「EC2 のメモリ使用率を CloudWatch で見ようとしたのですが、どこを探してもメトリクスがありません」
「CPU 使用率のアラームを作り、SNS でメールに通知するように設定しました。アラームは ALARM になっているのに、メールが一通も届きません」
第10回では、RDS・Aurora・DynamoDB などのデータベースを見ました。システムを作ったあとに毎日向き合うのが、監視・操作の記録・設定の統制・費用です。オンプレでは SNMP で機器に問い合わせ、syslog でログを集め、資産台帳で棚卸しをしてきました。AWS では同じ目的を、CloudWatch・CloudTrail・Config・Systems Manager などのサービスで実現しますが、仕組みが違うために、オンプレの感覚のままだと「監視できているつもり」「止めたつもり」が起こります。
第11回と第12回では、AWS の運用・監視・コストを見ていきます。前編の第11回では、CloudWatch のメトリクス・ログ・アラーム、CloudTrail と AWS Config、Systems Manager、監視の考え方の変化を扱います。
CloudWatch:メトリクス
CloudWatch は AWS の監視基盤で、各サービスが自動的に送る メトリクス(名前空間・メトリクス名・ディメンションで識別される時系列の数値)を保存・可視化・監視します。EC2 の CPUUtilization、NetworkIn/Out、StatusCheckFailed は 基本モニタリング(5分間隔)で無料 で使え、詳細モニタリング(1分間隔)は有料 で有効にできます。EBS の VolumeReadOps、RDS の DatabaseConnections・FreeStorageSpace などは、最初から1分間隔で無料で送られます。
重要な注意点として、EC2 のメモリ使用率とディスク使用率は標準のメトリクスに含まれません。ハイパーバイザーからは OS の中が見えないためで、OS に CloudWatch エージェント(次の節)を入れて送る必要があります。冒頭の1つ目の相談がこれです。メトリクスが見つからないのは設定の誤りではなく、最初から無い のです。
SNMP で行っていたポーリング型の監視(このブログの連載「SNMP入門」で扱います)は、AWS ではサービス側がプッシュするメトリクスを CloudWatch から取る形に変わり、マネージドサービス(RDS、ELB、NAT ゲートウェイ)に SNMP でアクセスすることはできません。メトリクスの保持期間は解像度により 3時間(1分未満の高解像度)〜15か月で、ダッシュボードで複数のアカウント・リージョンを横断して表示できます。カスタムメトリクス(aws cloudwatch put-metric-data)でアプリ独自の値も送れ、メトリクスの数に応じて課金されます。
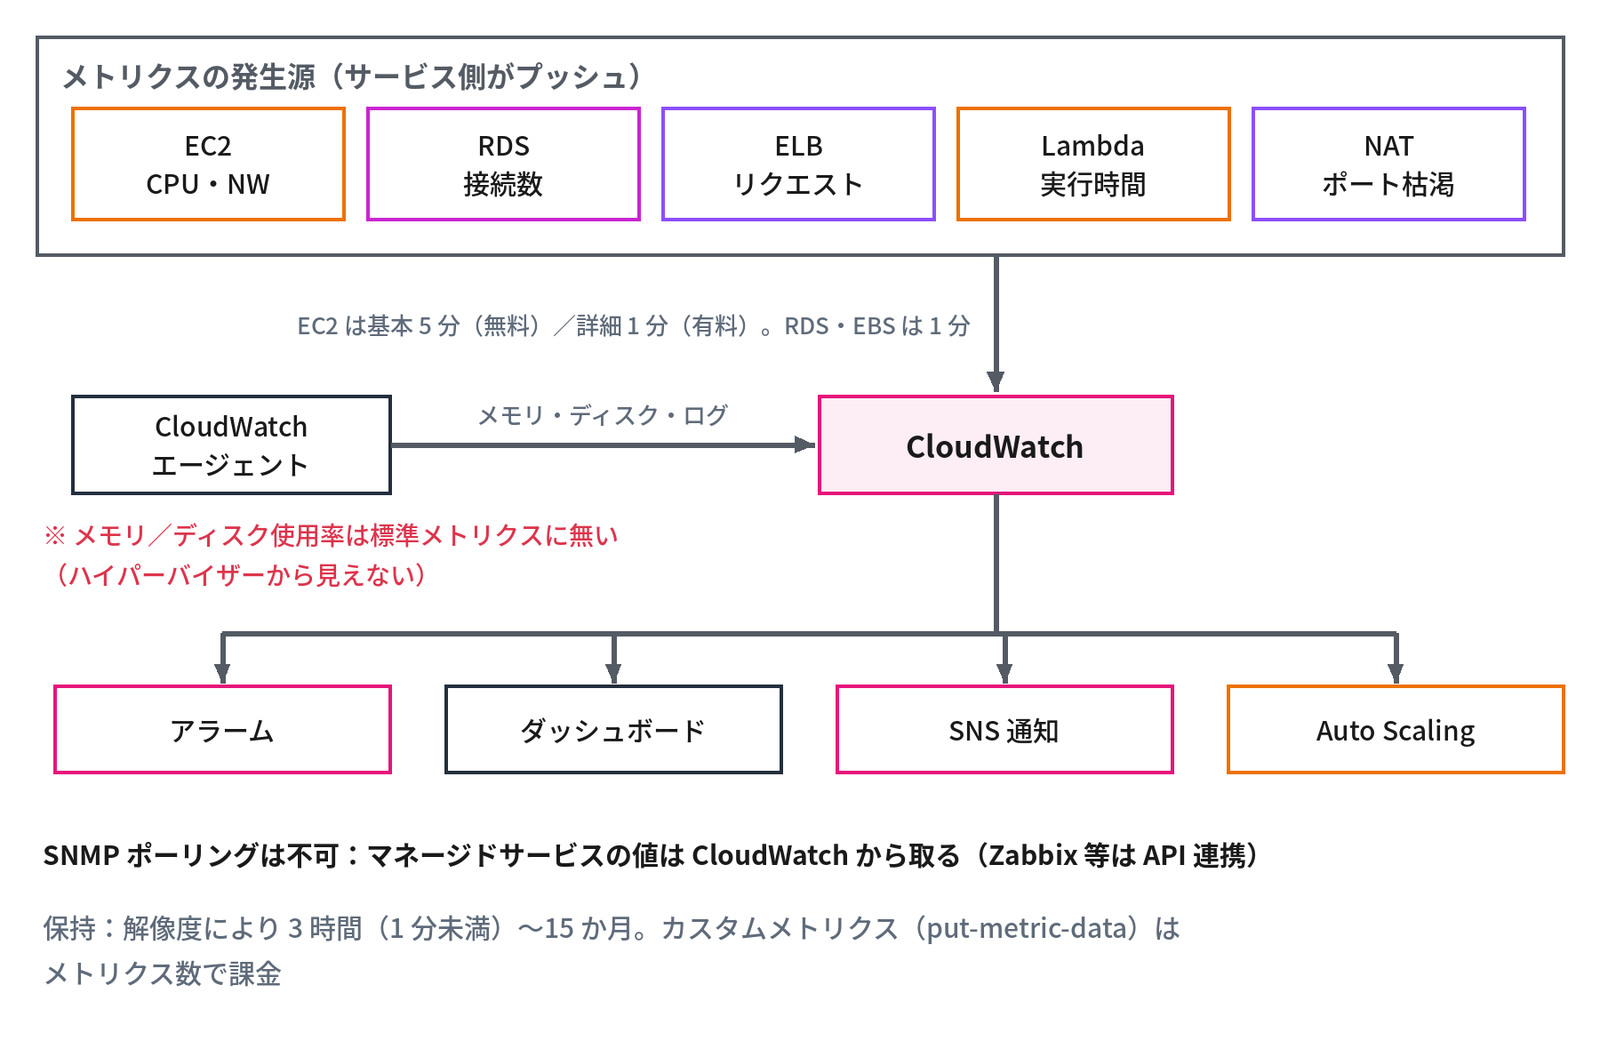
- サービスが自動で送る時系列のメトリクス。基本は5分間隔で無料、詳細は1分間隔で有料
- メモリ・ディスクの使用率は標準に無い。エージェントで送る
- SNMP のポーリングは不可。CloudWatch へ取りに行く形に変わる
CloudWatch Logs とエージェント
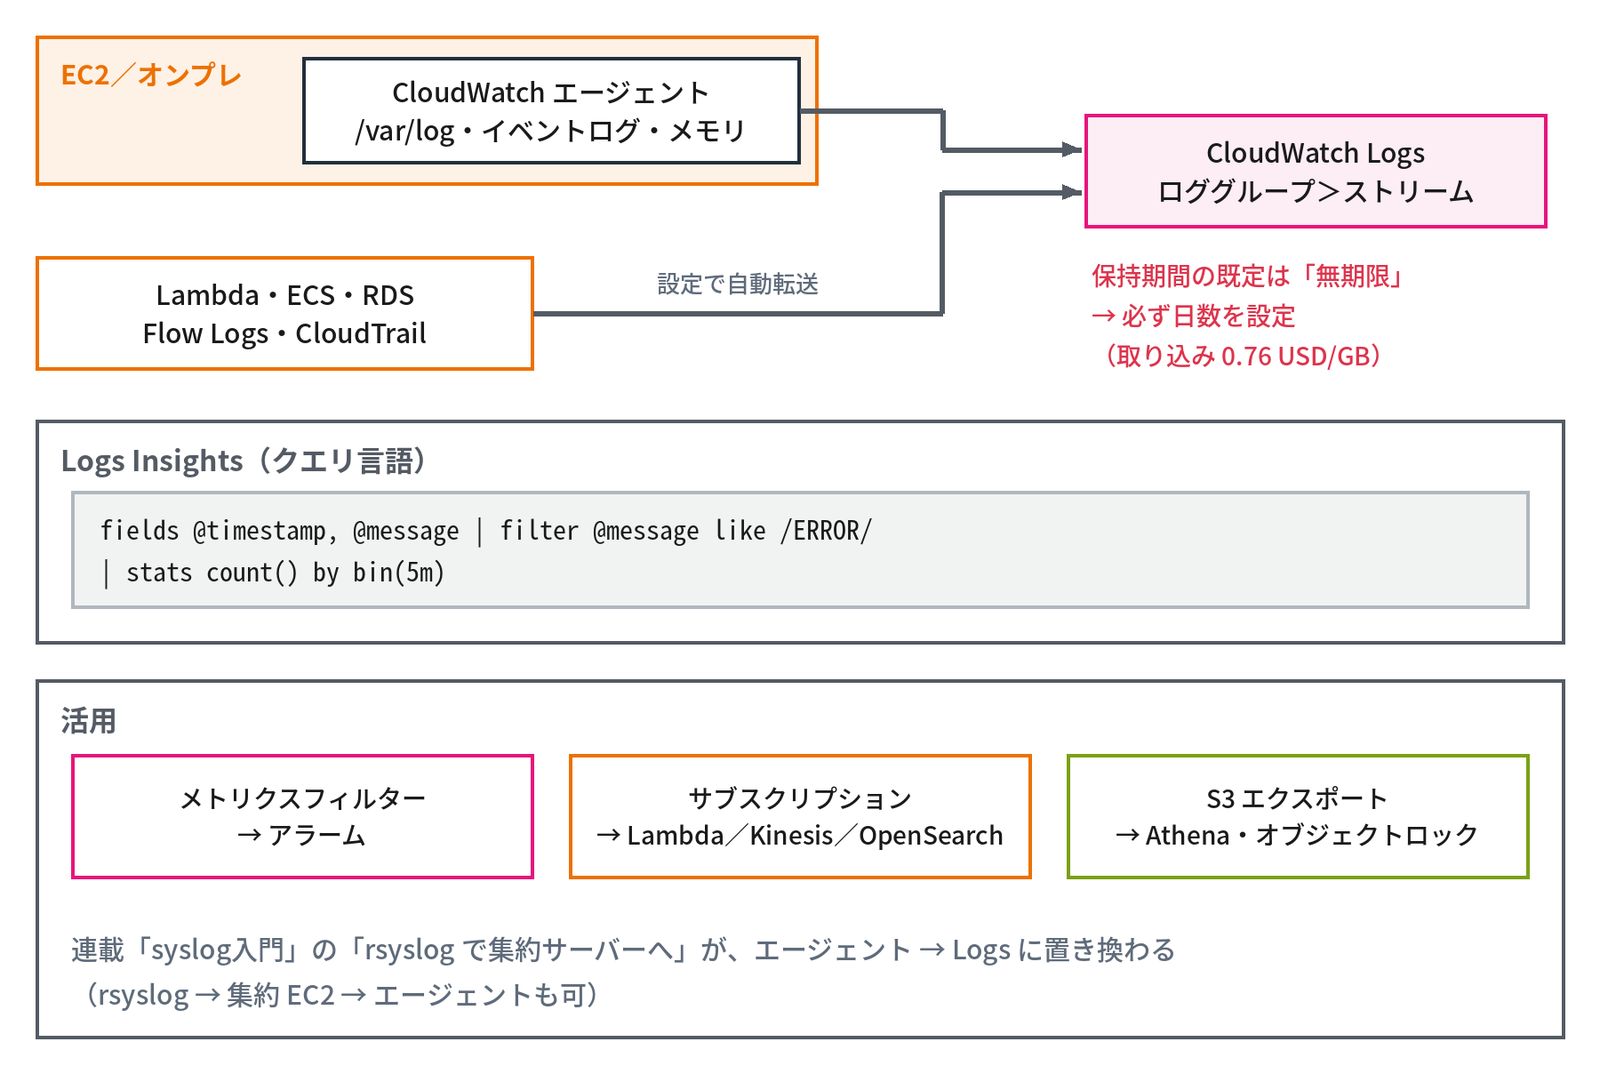
ログは CloudWatch Logs に集め、OS の中の値とログファイルは CloudWatch エージェントで送ります。
- CloudWatch Logs:ログを「ロググループ」>「ログストリーム」で保管する。Lambda・ECS・RDS・VPC Flow Logs・CloudTrail は設定で自動転送される。保持期間の既定は「無期限」 なので、必ず日数(例:90日)を設定する。設定しないと取り込み料(0.76 USD/GB。東京リージョン、2026年9月時点)と保存料が積み上がる
- CloudWatch エージェント:EC2・オンプレのサーバーに導入し、OS のメトリクス(メモリ、ディスク、プロセス)と ログファイル(
/var/log/messages、Windows のイベントログ、アプリのログ) を送る。設定は JSON を SSM Parameter Store に置いて配布する。rsyslog で集約サーバーへ転送する構成(連載「syslog入門」第4回「転送の設定(omfwd)とアクションキュー」で扱います)が、エージェントで CloudWatch Logs へ転送する形に置き換わる(rsyslog → 集約用の EC2 → エージェントという構成も可能) - Logs Insights:ロググループに対するクエリー言語。例は下のとおり
- メトリクスフィルター:ログの中の文字列(
ERRORなど)の出現回数をメトリクスにし、アラームにつなげる - サブスクリプションフィルター:ログをリアルタイムに Lambda・Kinesis・OpenSearch へ流す
- 長期保存は S3 へエクスポートし、Athena で検索する(Athena は第10回で扱います)。ログの改ざん防止 は S3 のオブジェクトロックで行う
fields @timestamp, @message
| filter @message like /ERROR/
| stats count() by bin(5m)
ERROR を含むログを5分ごとに数える例です。CloudWatch Logs の保持期間やコストの設計は、連載「syslog入門」第9回「CloudWatch Logsの設計」と「コストの考え方:取り込み・保存・検索」で詳しく扱います。
アラーム・通知・イベント
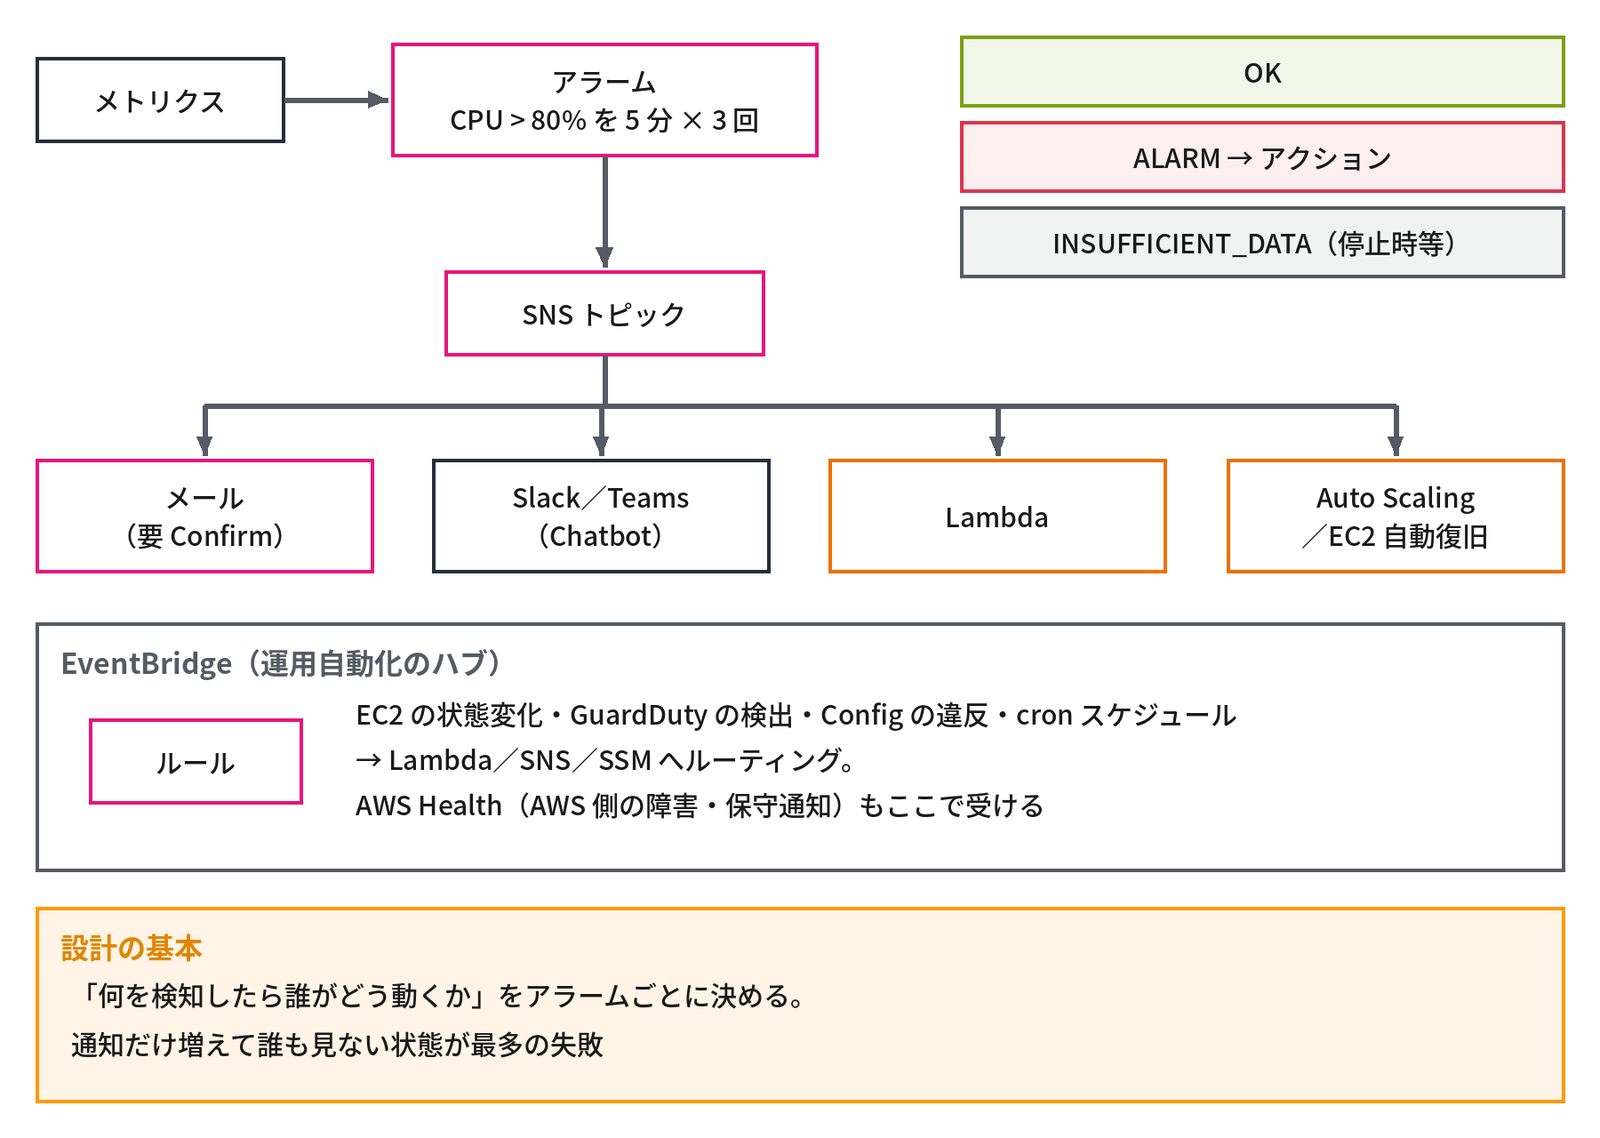
集めたメトリクスとイベントは、アラームとイベントのルールで「人や仕組みが動く」ところまでつなげます。
- CloudWatch アラーム:メトリクスにしきい値と評価期間(例:CPU > 80% が5分間×3回連続)を設定する。状態は
OK/ALARM/INSUFFICIENT_DATA(データが来ない。インスタンスの停止時など)で表され、INSUFFICIENT_DATA を異常として扱うか を決めておく - アクション:SNS トピックへの通知(メール、SMS、HTTP、Lambda、AWS Chatbot 経由で Slack/Teams。AWS Chatbot は2025年に Amazon Q Developer in chat applications へ改称)、Auto Scaling の増減、EC2 の再起動・復旧(
StatusCheckFailed_Systemで別のホストへ自動で移す) - 複合アラーム:複数のアラームの AND/OR で「両系とも落ちたときだけ」通知する
- Amazon SNS:Pub/Sub の通知サービス。トピックにサブスクライバー(メールなど)を登録する。メールは確認リンクを踏むまで届かない
- Amazon EventBridge:AWS の中のイベント(EC2 の状態変化、GuardDuty の検出、Config の違反、cron のスケジュール)をルールで拾い、Lambda・SNS・SSM などへルーティングする。運用自動化のハブ
- CloudWatch Synthetics:外形監視(定期的に URL にアクセスする Canary)。AWS Health:AWS 側の障害・メンテナンスの通知(EventBridge で受ける)
- 設計の基本:「何を検知したら誰がどう動くか」をアラームごとに決める。通知だけが増えて誰も見ない状態(アラート疲れ)が最も多い失敗
冒頭の2つ目の相談がこれです。SNS のメールのサブスクリプションは、登録したアドレスに届く確認のメールのリンクを踏む(Confirm する)までは「確認保留中」のままで、アラームが ALARM になっても通知は届きません。SNS のコンソールでサブスクリプションの状態を確かめ、確認のメールが迷惑メールに振り分けられていないかも見ておきます。
CloudTrail:操作の証跡
CloudTrail は「誰が・いつ・どこから・どの API を・どのリソースに・成功/失敗」を記録する監査ログで、コンソールの操作、CLI、SDK、ほかのサービスからの呼び出しまで、AWS に対する 管理系の操作はすべて対象 になります。有効にしなくても直近 90日の「イベント履歴」はコンソールで検索できますが、それ以上の保存、複数アカウントの集約、機械的な分析には「証跡(トレイル)」を作って S3 に出力する必要があります。
Organizations の 組織トレイル を管理アカウントで1つ作れば、全メンバーアカウントの操作が1つのバケットに集まり、メンバー側では無効にできません。S3 のオブジェクト単位の操作や Lambda の実行のような「データイベント」は既定では記録されず、必要なら追加で設定します(有料)。ログは数分〜15分程度の遅れで配信され、ログファイルの整合性検証(ダイジェストファイルによる改ざんの検知)を有効にできます。
用途は、セキュリティインシデントの調査(「誰がこの SG を 0.0.0.0/0 に開けたか」)、コンプライアンス監査の証拠、GuardDuty・Security Hub の入力です。CloudTrail Lake を使うと、SQL で長期間のイベントを直接検索できます。オンプレの監査ログ(連載「syslog入門」で扱います。CloudTrail の設計は同じ連載の第9回「CloudTrailの設計」)と同じ位置づけで、「取っているが誰も見ない」ではなく、EventBridge で特定の危険な操作(ルートユーザーのログイン、CloudTrail の停止、SG の変更)を検知して通知する運用にしましょう。
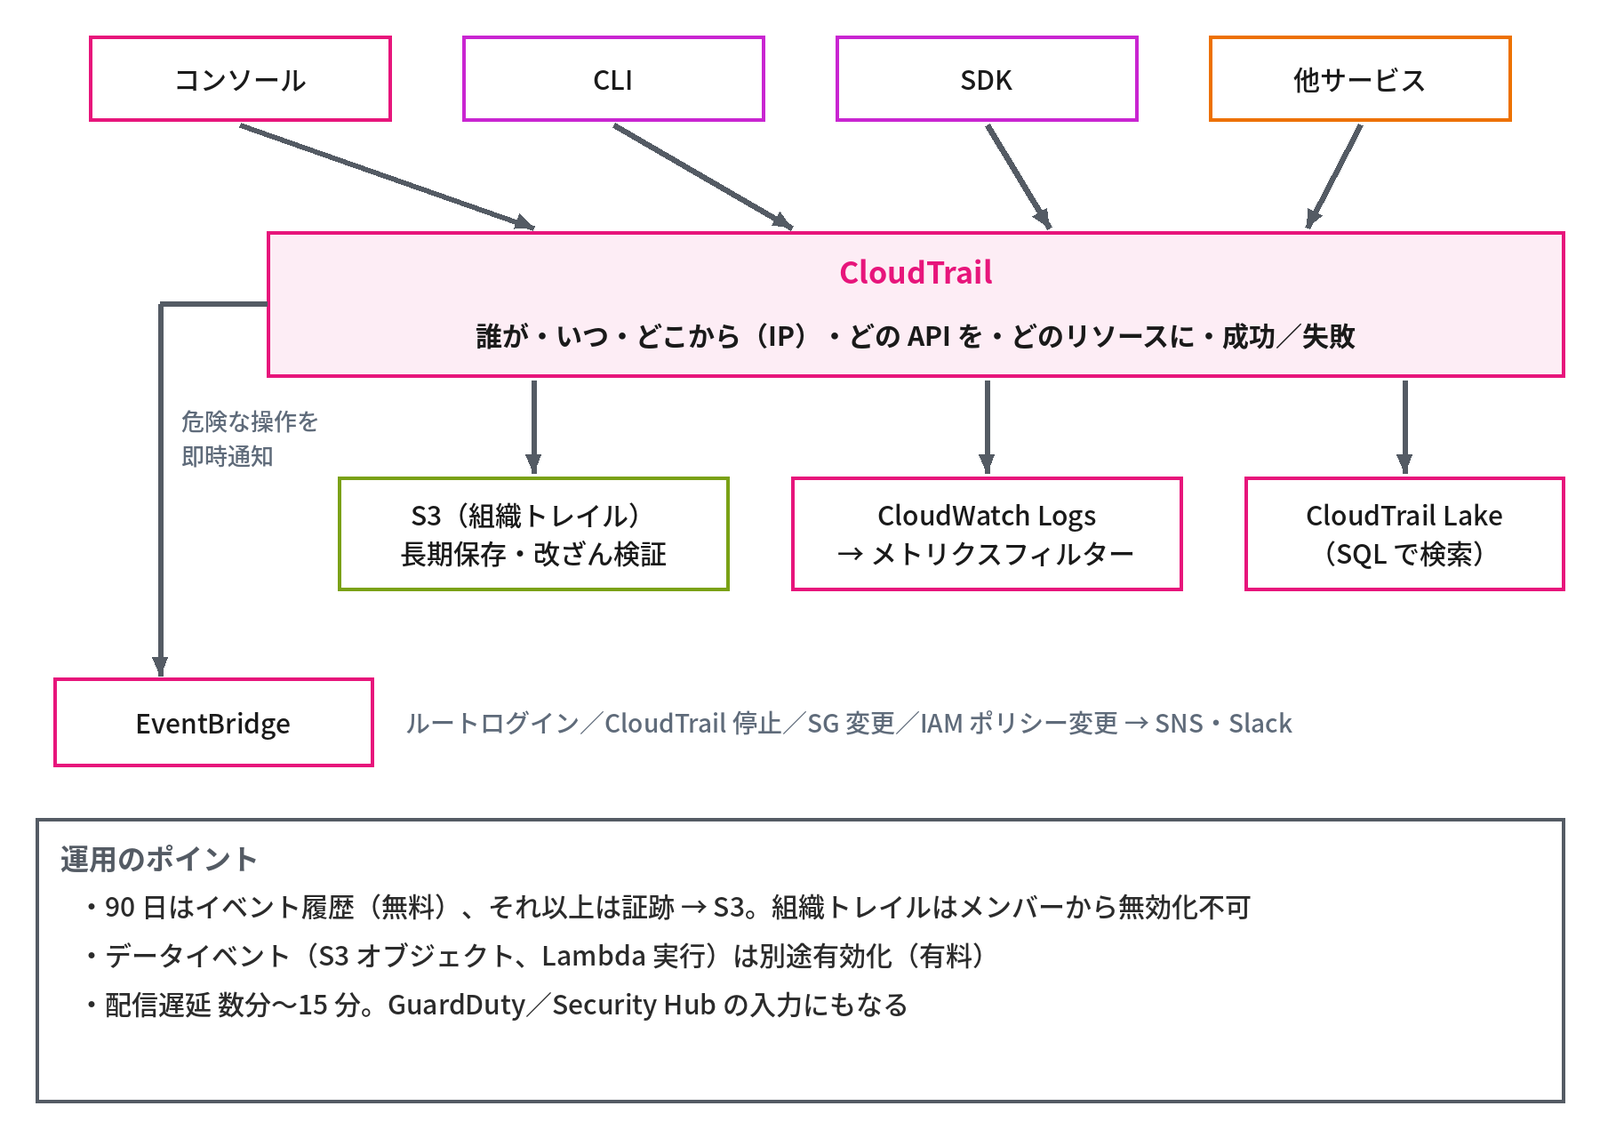
- 全 API 操作の証跡。90日は無料の履歴、長期は S3 へ組織トレイル
- データイベント(S3 のオブジェクトなど)は別に有効化
- 危険な操作は EventBridge で即時に通知。整合性検証も有効に
AWS Config:設定の記録と準拠チェック
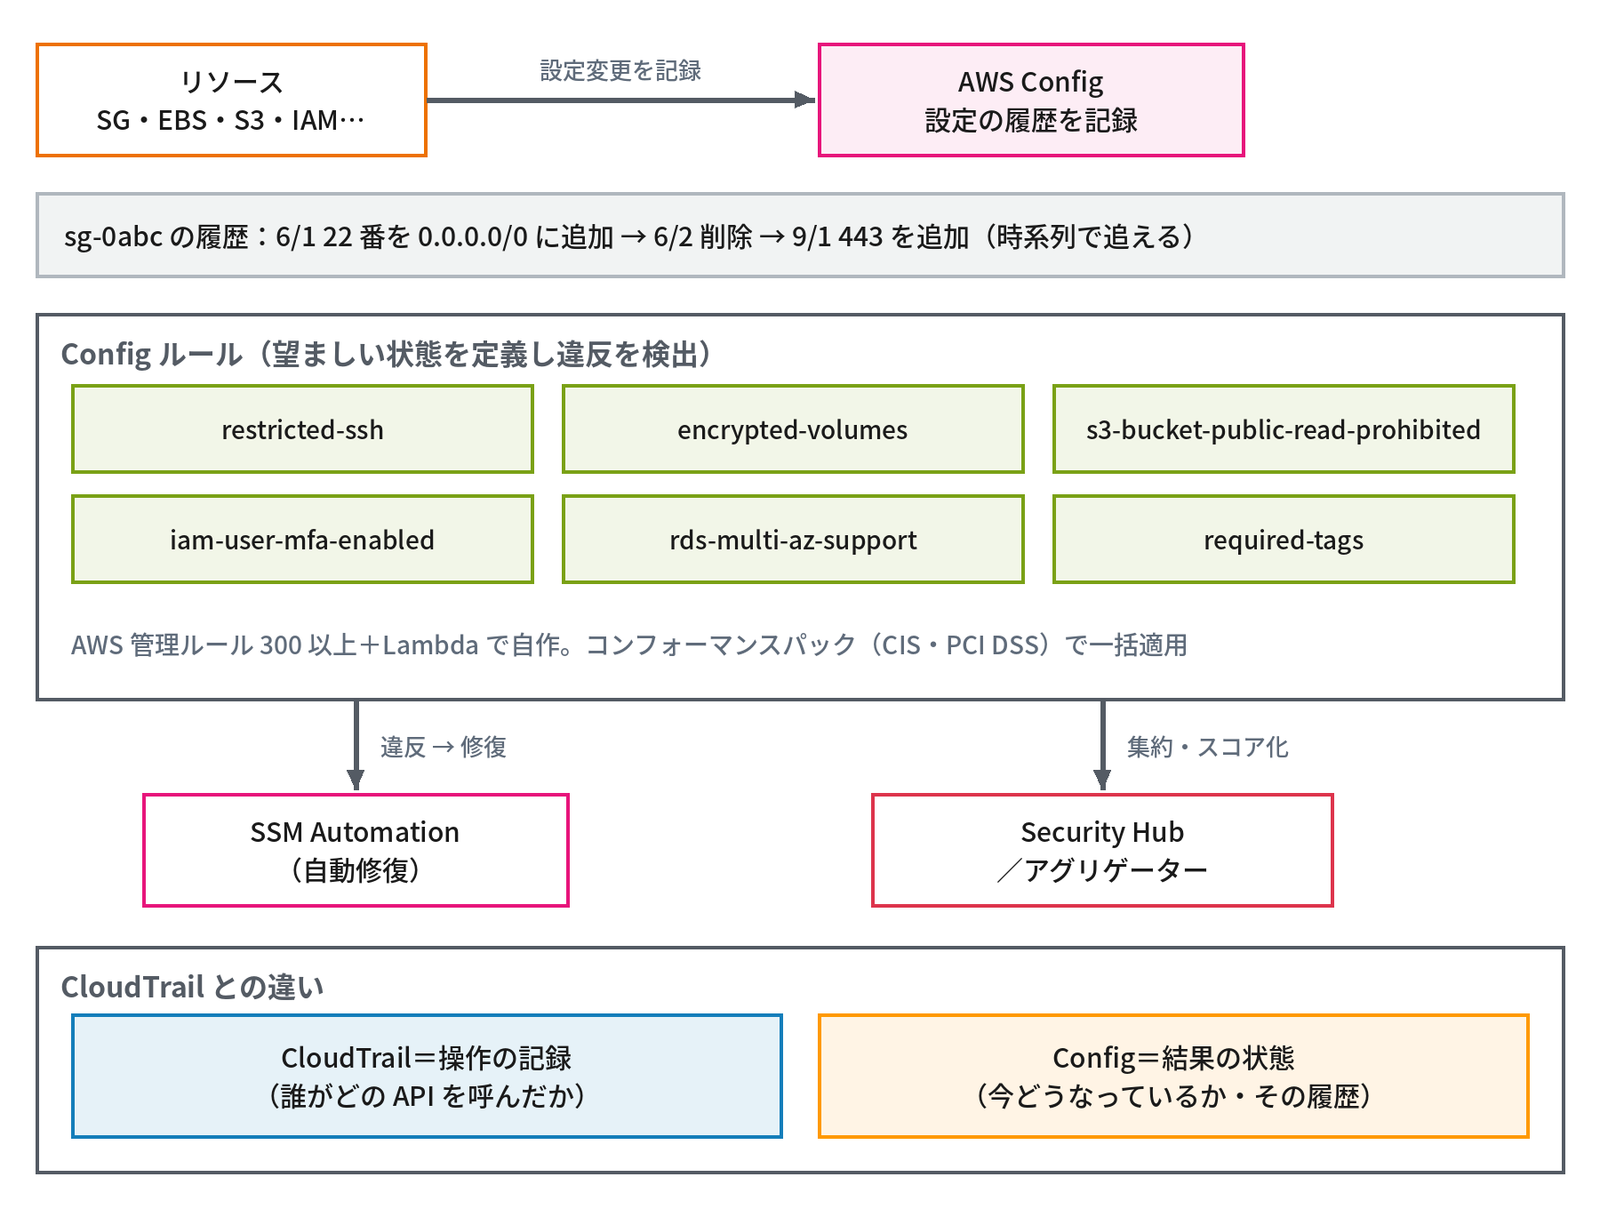
CloudTrail が「操作」の記録なら、AWS Config は「結果の状態」の記録です。
- リソースの 設定内容の履歴 を記録する(CloudTrail が「操作」、Config が「結果の状態」)。「この SG のルールは3か月前どうだったか」「この EBS はいつ暗号化されたか」を時系列で追える
- Config ルール:望ましい状態を定義し、違反を検出する(AWS の管理ルール 300 以上+Lambda での自作)。例:
restricted-ssh(22番が全開放)、encrypted-volumes、s3-bucket-public-read-prohibited、iam-user-mfa-enabled、rds-multi-az-support、required-tags - 修復アクション:違反を SSM Automation で自動修正できる(公開された S3 を非公開に戻すなど)
- コンフォーマンスパック:CIS ベンチマーク、PCI DSS などのルール集を一括で適用できる
- Organizations の アグリゲーター で全アカウントの準拠状況を1画面に集約できる。Security Hub のスコアの入力にもなる
- 費用は、記録した設定項目の数とルールの評価回数に比例する。全リソースの記録は思いのほか高くなるので、対象を絞るか、記録の頻度を「日次」にする選択肢もある
AWS Systems Manager(SSM)
Systems Manager は、EC2(やオンプレのサーバー)を管理する機能の集まりです。オンプレで使ってきた道具との対応で見ます。
| 機能 | 内容 | オンプレの対応 |
|---|---|---|
| Session Manager | ブラウザー・CLI からインスタンスのシェルへ。インバウンドのポートが不要、IAM で認証、操作ログを S3・CloudWatch Logs へ | 踏み台+SSH(連載「SSH入門」第10回「クラウドの代替手段」で扱います) |
| Run Command | 多数のインスタンスへコマンド・スクリプトを一斉に実行 | Ansible の ad-hoc、PSRemoting |
| Patch Manager | パッチベースライン+メンテナンスウィンドウで OS のパッチを自動で適用し、準拠状況を集計 | WSUS、yum-cron |
| State Manager | 望ましい状態(エージェントの導入済み、設定ファイル)を維持 | 構成管理ツール |
| Parameter Store | 設定値・シークレットの保管(第9回) | 設定ファイル |
| Inventory/Fleet Manager | インストール済みのソフト・OS の情報の収集、GUI でのファイル・レジストリの操作 | 資産管理ツール |
| Automation | ランブック(AMI の更新、EBS の暗号化、障害対応の手順)を自動で実行 | 手順書+スクリプト |
| Hybrid Activations | オンプレ・ほかのクラウドのサーバーも SSM の管理下に | ― |
前提は SSM エージェント(Amazon Linux 2023・Windows の AMI には導入済み)+IAM ロール(AmazonSSMManagedInstanceCore)+SSM のエンドポイントへの経路(インターネットか、VPC エンドポイント3つ)です。「Session Manager で入れない」の原因は、ほぼこの3点のどれかです。
監視の考え方の変化:オンプレとの違い
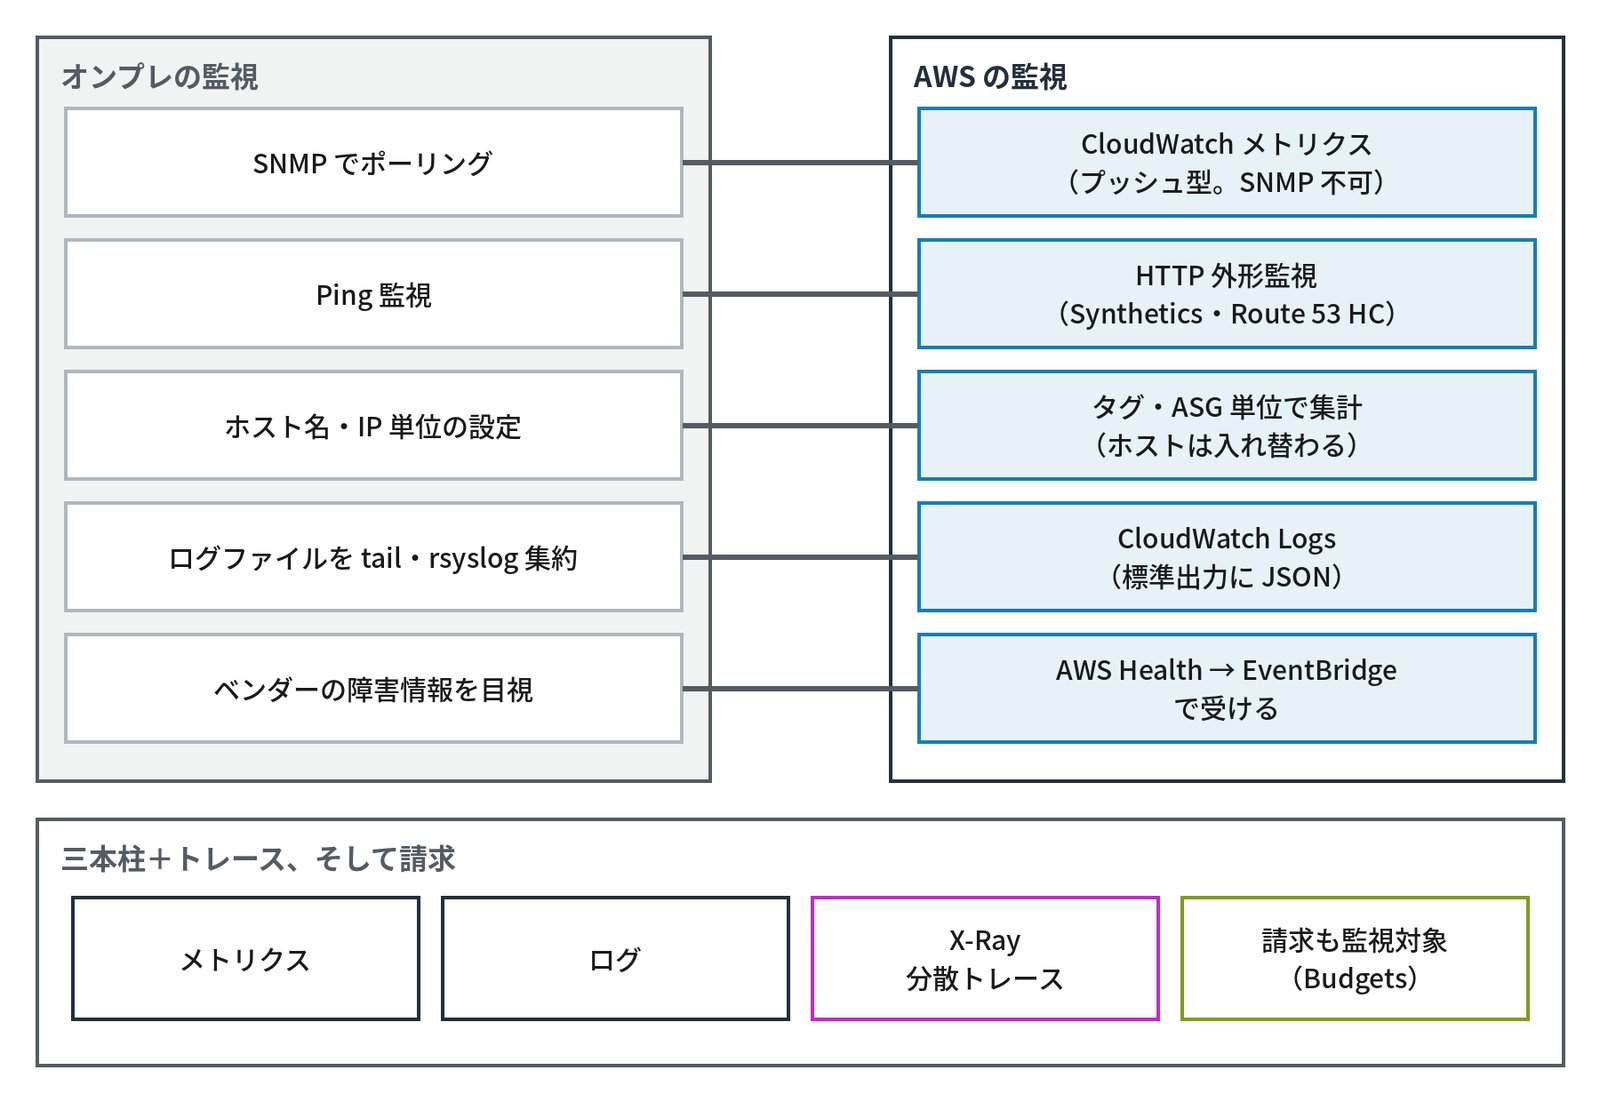
道具が変わるだけでなく、監視の前提そのものが変わります。
- SNMP は使わない:マネージドサービスに SNMP のエージェントは無い。メトリクスは CloudWatch から取る。既存の監視ツール(Zabbix、Nagios)を使い続けるなら、CloudWatch の API との連携(Zabbix の AWS 用のテンプレートなど)を使う(連載「SNMP入門」第10回「クラウドでの監視」で扱います)
- Ping 監視は意味が薄い:ELB・Lambda・S3 に ICMP は通らない。HTTP の外形監視(Synthetics、Route 53 のヘルスチェック)に置き換える
- サーバーは入れ替わる:Auto Scaling でホスト名・IP が変わるので、ホスト単位の監視設定は破綻する。タグや Auto Scaling グループ(ASG)の単位で集計する
- ログはファイルではなくストリーム:Lambda・Fargate にはログインできない。CloudWatch Logs に出す前提でアプリを書く(標準出力に JSON)
- AWS 側の障害は AWS Health で知る:ステータスページを目で見るのではなく、EventBridge で自分のアカウントに影響するイベントを受ける
- 監視の対象は「請求」も含む:Budgets・Cost Anomaly Detection(後編の「コスト管理のツール」の節)で監視する
- 三本柱(メトリクス・ログ・トレース)+ X-Ray(分散トレーシング。計装は OpenTelemetry(ADOT)が推奨)で「どのサービスで遅いか」を追う
考えてみよう
- 手元の AWS アカウント(または検証用のアカウント)で、CloudWatch Logs のロググループに、保持期間が「無期限」のものは残っていませんか。残っていたら、何日に設定し、それより古いログをどこに残しますか
- EC2 のメモリ使用率とディスク使用率を監視するには、何を入れて、どの IAM ロールを付ける必要がありますか。Session Manager で入るための前提3つと合わせて答えてください
- 「誰がこの SG を 0.0.0.0/0 に開けたか」と「この SG は3か月前どうだったか」を調べるには、それぞれどのサービスを使いますか。その操作を次からすぐ通知するには、どう組み合わせますか
ヒント:1は「CloudWatch Logs とエージェント」、2は「CloudWatch Logs とエージェント」「AWS Systems Manager(SSM)」、3は「CloudTrail:操作の証跡」「AWS Config:設定の記録と準拠チェック」の節を見直してください。
まとめ
- CloudWatch はサービスが送るメトリクスを集める。メモリ・ディスクの使用率はエージェントで送る。SNMP のポーリングは使えない
- CloudWatch Logs は 保持期間の既定が無期限。必ず日数を決める
- アラームは SNS・EventBridge で人や仕組みへつなぐ。通知先のメールは Confirm するまで届かない
- CloudTrail は「操作」、Config は「結果の状態」 の記録。危険な操作は EventBridge で通知
- Systems Manager の Session Manager で、22番を開けずに シェルへ入れる(前提はエージェント・ロール・経路)
- オンプレの監視は、プッシュ型のメトリクス・外形監視・タグ単位の集計・ログのストリーム に置き換わる
次回は後編として、タグ運用、データ転送料金、コスト管理のツールとつまずき、マルチアカウントの統制(Control Tower)、IaC、運用のつまずき、Azure との対応を扱います。
連載「クラウド入門」全14回
- クラウドとは(定義・歴史・責任分界)
- AWSの全体像
- コンピューティング 前編(EC2・Nitro・インスタンスタイプ・AMI・IMDS)
- コンピューティング 後編(課金と購入オプション・Auto Scaling・ELB・コンテナ・Lambda)
- ストレージ
- ネットワーキング 前編(VPC・サブネット・SG・NACL)
- ネットワーキング 後編(DNS・接続・Route 53・CloudFront)
- IAMとセキュリティ 前編(IAM・ポリシー・STS・ID連携・Organizations)
- IAMとセキュリティ 後編(KMS・シークレット・ACM・検知と防御)
- データベース
- 運用・監視・コスト 前編(CloudWatch・CloudTrail・Config・SSM)(この記事)
- 運用・監視・コスト 後編(タグ・転送料金・コスト管理・Control Tower・IaC)
- Well-Architectedフレームワーク
- これまでのテーマとAWSの対応・まとめ
コメント