「RDS をマルチ AZ にしたので、待機しているスタンバイのほうに月末のレポートのクエリを流して、本番の負荷を減らしたいと思います。スタンバイの接続先はどこですか」
「RDS のフェイルオーバーを訓練してみたら、DB は1〜2分で切り替わったのに、アプリが10分以上つながらないままでした。何が悪いのでしょう」
第8回と第9回では、IAM と KMS・Secrets Manager・ACM などのセキュリティのサービスを見ました。オンプレの DB サーバーでは、インストール、パッチ、バックアップ、レプリケーション、フェイルオーバー、監視と、多くの作業を自分たちで行ってきました。AWS には、これらを AWS が引き受けるマネージドのデータベースがあり、RDB の RDS と Aurora、NoSQL の DynamoDB を中心に、用途ごとのサービスがそろっています。ただし、任せられることと任せられないことの境目を知らないと、冒頭のような思い違いが起きます。
第10回では、マネージド DB の考え方、RDS の概要、マルチ AZ による可用性、リードレプリカとスケーリング、Aurora、DynamoDB、そのほかのデータベース・分析サービス、RDB と NoSQL の使い分け、バックアップと災害対策(DR)、DB への接続とセキュリティ、そして Azure との対応を扱います。数値・料金は2026年9月時点のものです。
マネージド DB という考え方
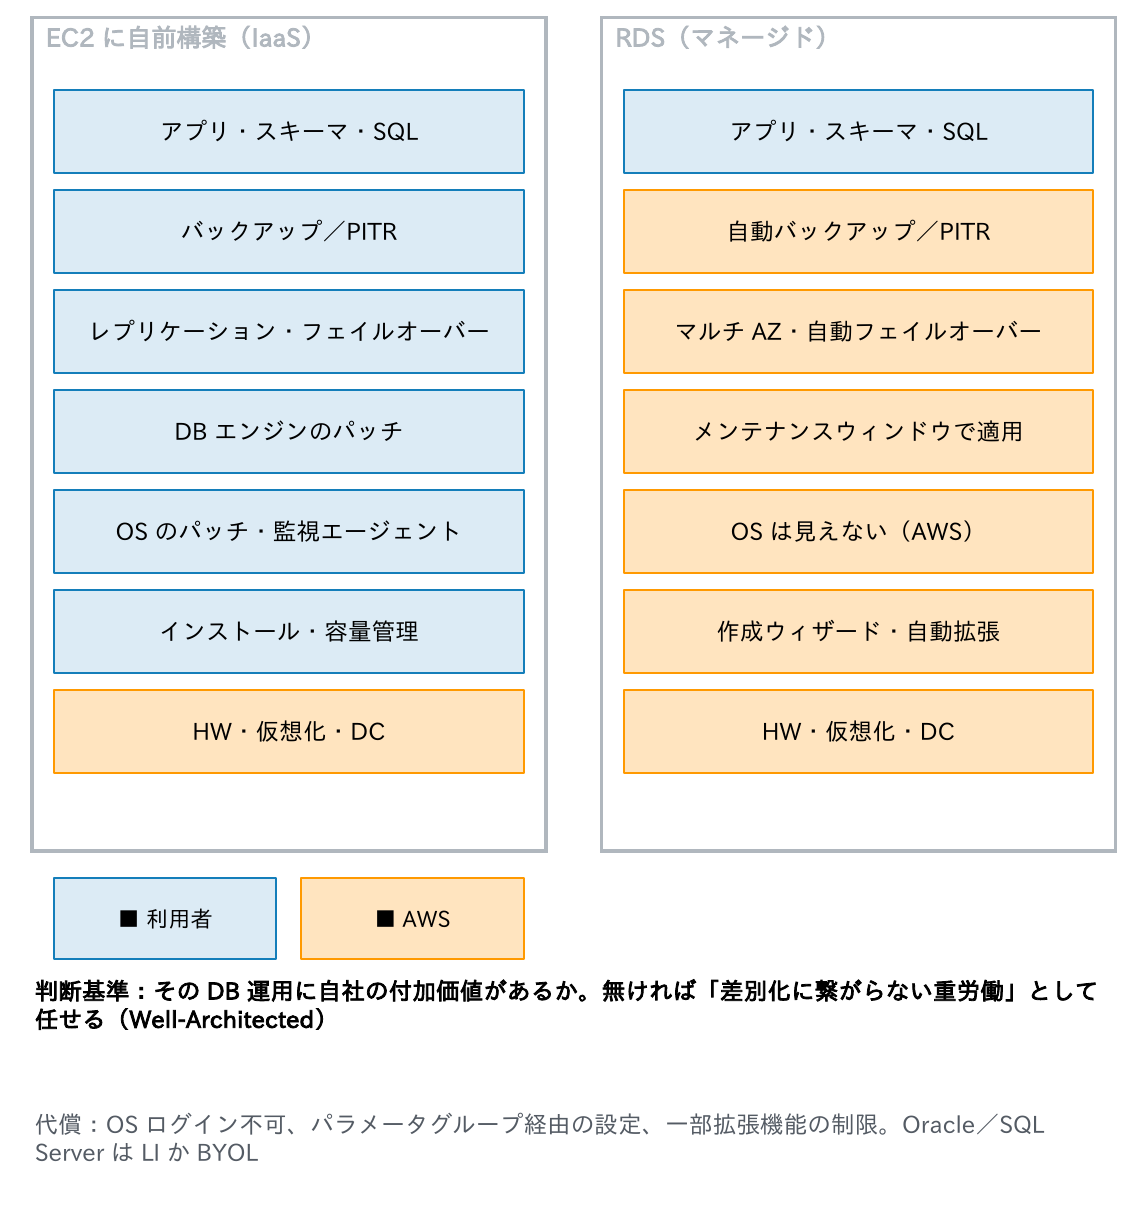
RDB の運用には、インストール、パッチ適用、バックアップ、レプリケーション、フェイルオーバー、監視、容量管理と、多くの作業が伴います。EC2 に MySQL を入れて動かすこともできますが(IaaS)、それらはすべて自分で行うことになります(RDB の運用の作業は、このブログの連載「RDB・SQL入門」第12回「バックアップと移行」・第13回「レプリケーションと冗長化」・第14回「監視と日々の運用」で詳しく扱います)。
RDS のようなマネージド DB では、OS とエンジンのパッチ適用はメンテナンスウィンドウで AWS が行い、バックアップは自動で日次に取得され、待機系への同期レプリケーションと障害時の切り替えは設定ひとつで有効になります。代わりに OS へのログインはできず、エンジンのパラメータは「パラメータグループ」経由でしか変えられず、一部の拡張機能や OS レベルのチューニングは使えません。
判断の基準は「その DB の運用に自社の付加価値があるか」です。多くの業務システムでは付加価値が無いため、AWS の Well-Architected(第13回)でも「差別化に繋がらない重労働(undifferentiated heavy lifting)はマネージドに任せる」ことを原則に挙げています。ライセンスの面では、Oracle と SQL Server はライセンス込み(LI)と持ち込み(BYOL)を選べ、Windows 版 SQL Server の CAL の考え方は不要になります。
- パッチ・バックアップ・フェイルオーバー・監視を AWS が担う
- 代わりに OS ログイン不可、パラメータグループ経由の設定
- 「自社に付加価値のない運用」は任せる。Oracle/SQL Server は LI/BYOL
RDS(Relational Database Service)の概要
RDS の主な項目です。オンプレの DB サーバーの設定項目が、どこに当たるかを見てください。
| 項目 | 内容 |
|---|---|
| エンジン | MySQL、MariaDB、PostgreSQL、Oracle、SQL Server、Db2(2023 年追加) |
| インスタンス | db.m7g.large のように EC2 と同じ体系(db. 付き)。メモリ最適化(db.r)、バースト(db.t) |
| ストレージ | gp3/io1/io2(EBS と同じ)。ストレージ自動スケーリングで閾値到達時に自動拡張 |
| ネットワーク | VPC のサブネットグループに配置。エンドポイントは DNS 名(xxx.abcdef.ap-northeast-1.rds.amazonaws.com)。IP は変わり得るので名前で接続 |
| 認証 | エンジンのユーザー+パスワード、IAM データベース認証(トークン、MariaDB/MySQL/PostgreSQL)、Kerberos(Managed AD 連携) |
| バックアップ | 自動(保持 0〜35 日、PITR 可)+手動スナップショット(無期限) |
| パッチ | メンテナンスウィンドウ(週 30 分)。マイナーバージョン自動適用は選択可、メジャーは手動 |
| 設定 | パラメータグループ(my.cnf/postgresql.conf 相当)、オプショングループ(Oracle/SQL Server の追加機能) |
| 監視 | CloudWatch(CPU、接続数、IOPS、空き容量)、CloudWatch Database Insights(旧 Performance Insights。待機イベント・SQL 単位の負荷)、拡張モニタリング(OS レベル) |
| 追加 | RDS Proxy(接続プーリング。Lambda からの大量接続対策)、Blue/Green デプロイ(メジャーアップグレードを別環境で検証して切替) |
RDS の可用性:マルチ AZ
RDS の可用性は、AZ をまたいだ構成で確保します。
- マルチ AZ DB インスタンス:別の AZ に同期レプリケーションのスタンバイを持つ。スタンバイは読めない。障害・メンテナンスのときに DNS のエンドポイントが自動で切り替わる(60〜120秒)。アプリは同じ DNS 名に再接続するだけ
- マルチ AZ DB クラスター(MySQL/PostgreSQL):1ライター+2リーダーを3つの AZ に置き、準同期レプリケーションを行う。フェイルオーバーは35秒程度で、リーダーは読み取りに使える。書き込みの遅延も従来のマルチ AZ より小さい
- シングル AZ:検証用。AZ の障害・メンテナンスで止まる。本番では使わない
- フェイルオーバーは強制実行(
aws rds reboot-db-instance --force-failover)で訓練できる。アプリ側の再接続処理と DNS のキャッシュ(JVM の TTL など)が切り替えの時間を左右する - レプリケーションの同期/非同期の違いが、「マルチ AZ(同期=可用性)」と「リードレプリカ(非同期=性能)」の区別にそのまま効いてくる(同期・非同期のレプリケーションは連載「RDB・SQL入門」第13回で詳しく扱います)
冒頭の1つ目の相談の答えがここにあります。マルチ AZ DB インスタンスのスタンバイは読めないので、レポートを流す先にはなりません。読み取りを逃がしたいなら、次の節のリードレプリカか、リーダーを読めるマルチ AZ DB クラスターを使います。
冒頭の2つ目の相談もここです。DB が切り替わっても、アプリが古い IP アドレスをキャッシュしていれば、つながらないままです。Java では JVM が名前解決の結果を長く覚えていることがあり、networkaddress.cache.ttl を短く(例:数十秒)するのが定番です。接続プールの再接続の設定も合わせて確かめます(DNS のキャッシュと TTL の考え方は、このブログの連載「DNS入門」第3回の「キャッシュとTTL」で詳しく扱っています)。
$ aws rds reboot-db-instance --db-instance-identifier app-db --force-failover
$ dig +short app-db.abcdef.ap-northeast-1.rds.amazonaws.com    # 切り替えの前後で IP が変わる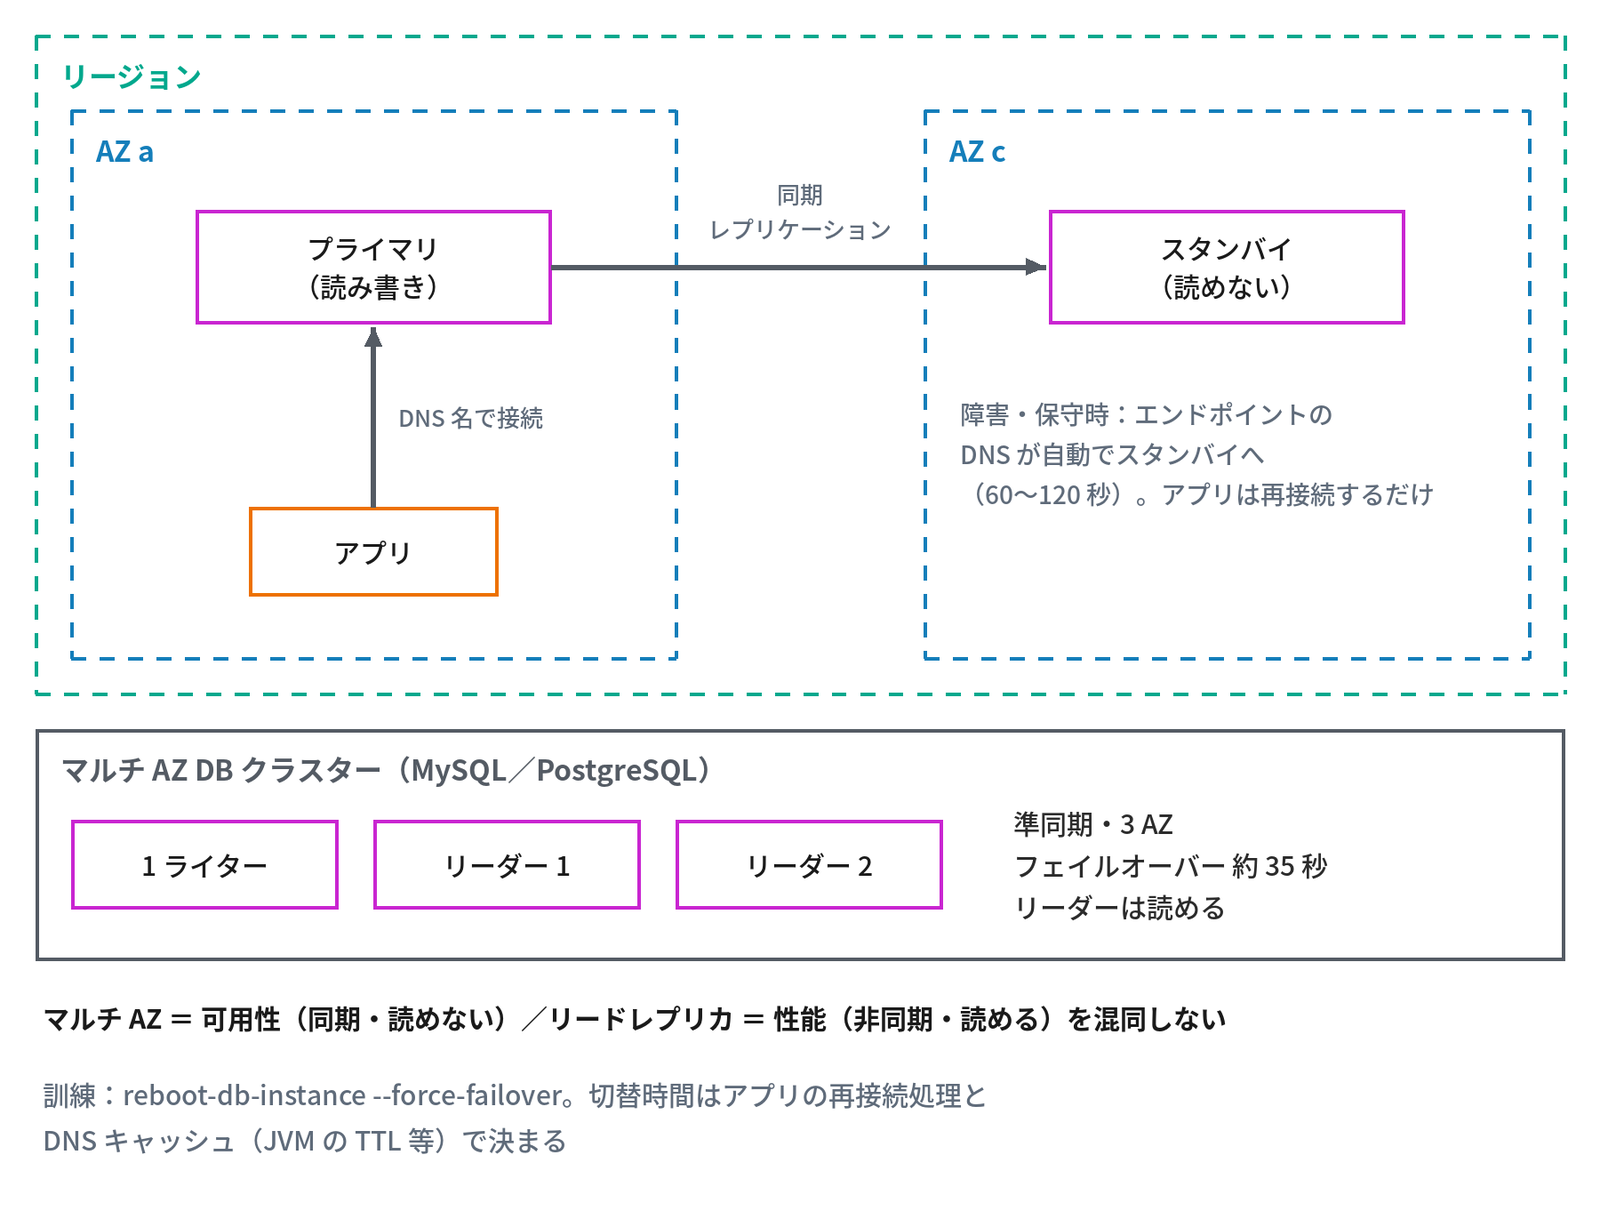
リードレプリカとスケーリング
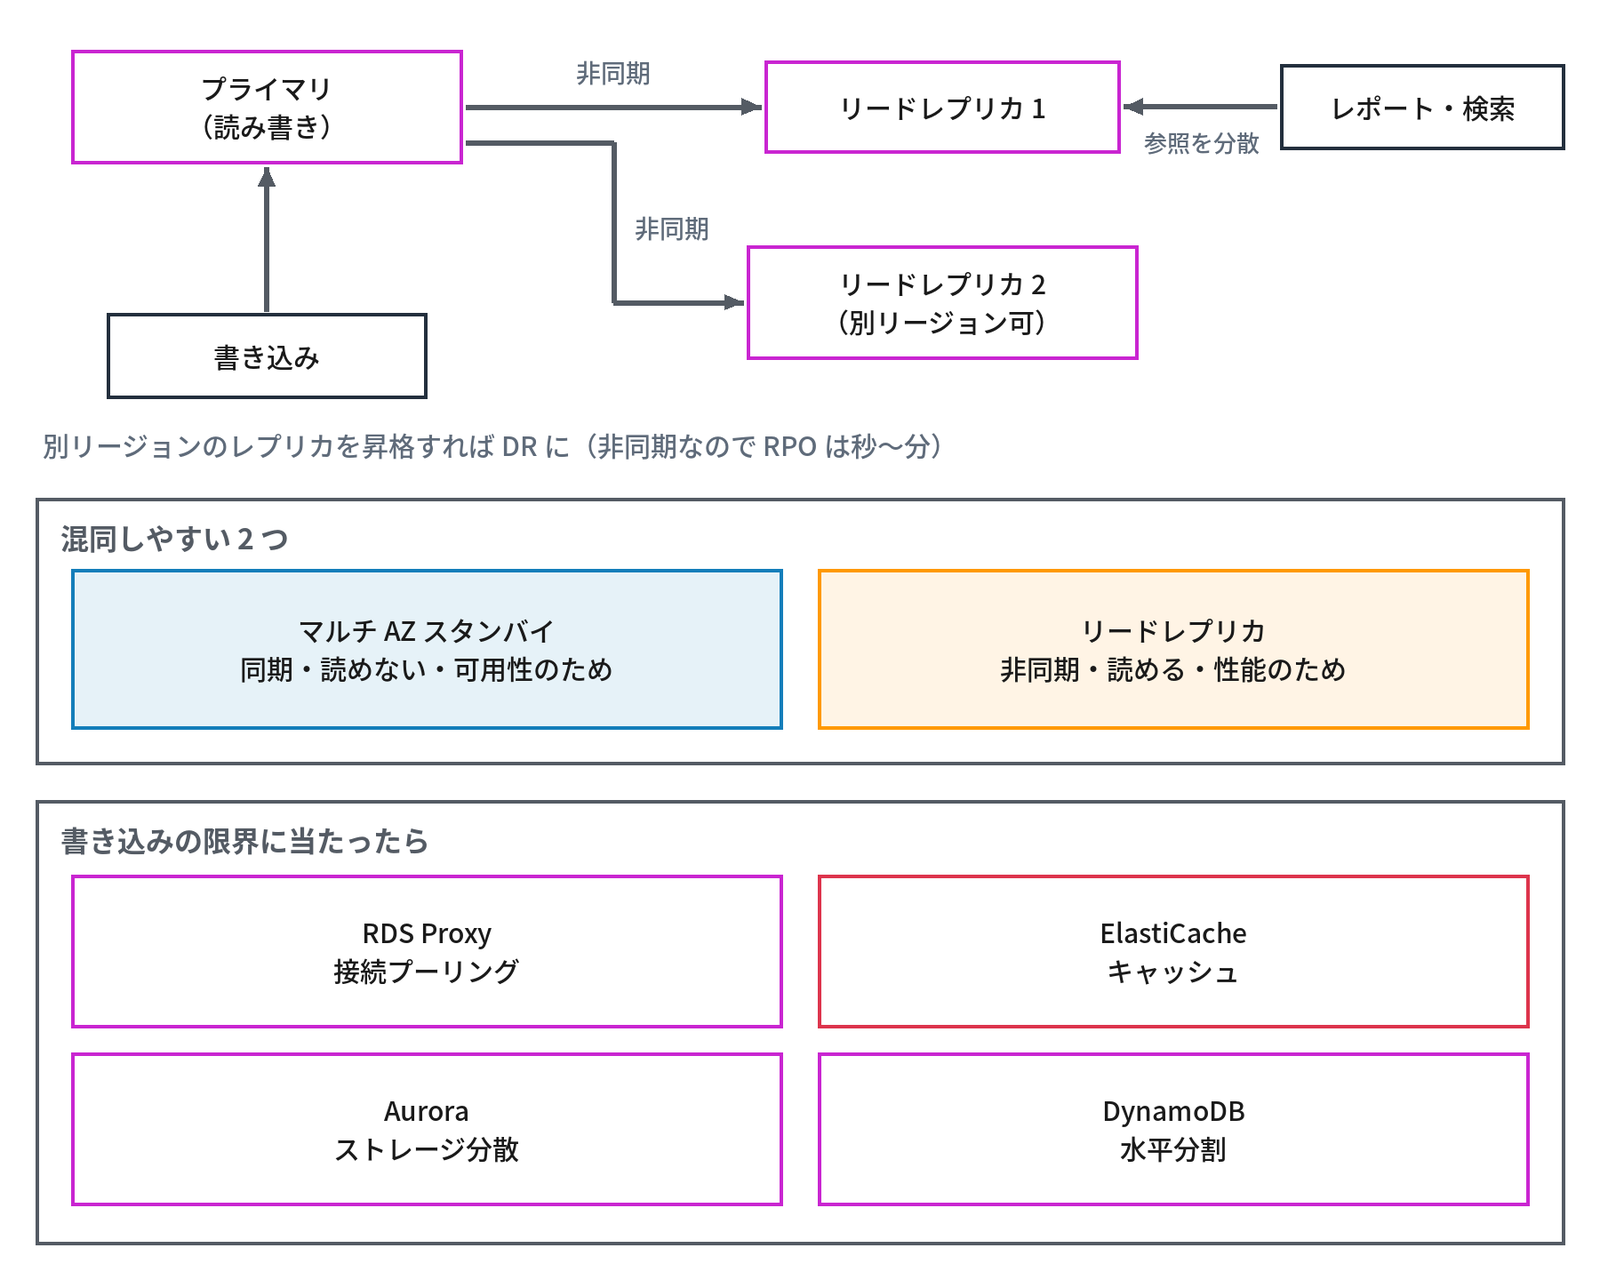
リードレプリカは、非同期レプリケーションで作る読み取り専用の複製で、参照系のクエリ(レポート、検索)を分散して、書き込み側の負荷を下げるのが目的です。マルチ AZ のスタンバイが「可用性のため・読めない」のに対し、リードレプリカは「性能のため・読める・遅延がある」という違いを混同しやすいので注意しましょう。
MySQL/PostgreSQL で最大15台、別のリージョンにも作れるため、リージョンの障害のときにレプリカを昇格させて DR にも使えます(ただし非同期なので直前のデータは失われ得ます。RPO は秒〜分です)。スケールアップ(インスタンスクラスの変更)はオンラインではなく、短時間の停止を伴います(マルチ AZ ならスタンバイ側から順に変えて、停止時間を短くできます)。
垂直方向の上限に当たる前に、読み取りはレプリカへ、接続数は RDS Proxy で、キャッシュは ElastiCache(この回の「その他のデータベース・分析サービス」)で逃がすのが定石です。書き込みそのものの水平分割(シャーディング)は、Aurora Limitless や DynamoDB の領域になります。
- 非同期の読み取り専用の複製。性能の分散が目的(マルチ AZ は可用性)
- 最大15台、クロスリージョン可。昇格で DR にも使える(RPO あり)
- 書き込みの限界は RDS Proxy・キャッシュ・Aurora・NoSQL で対処
Amazon Aurora
Aurora は、AWS が設計した RDB です。
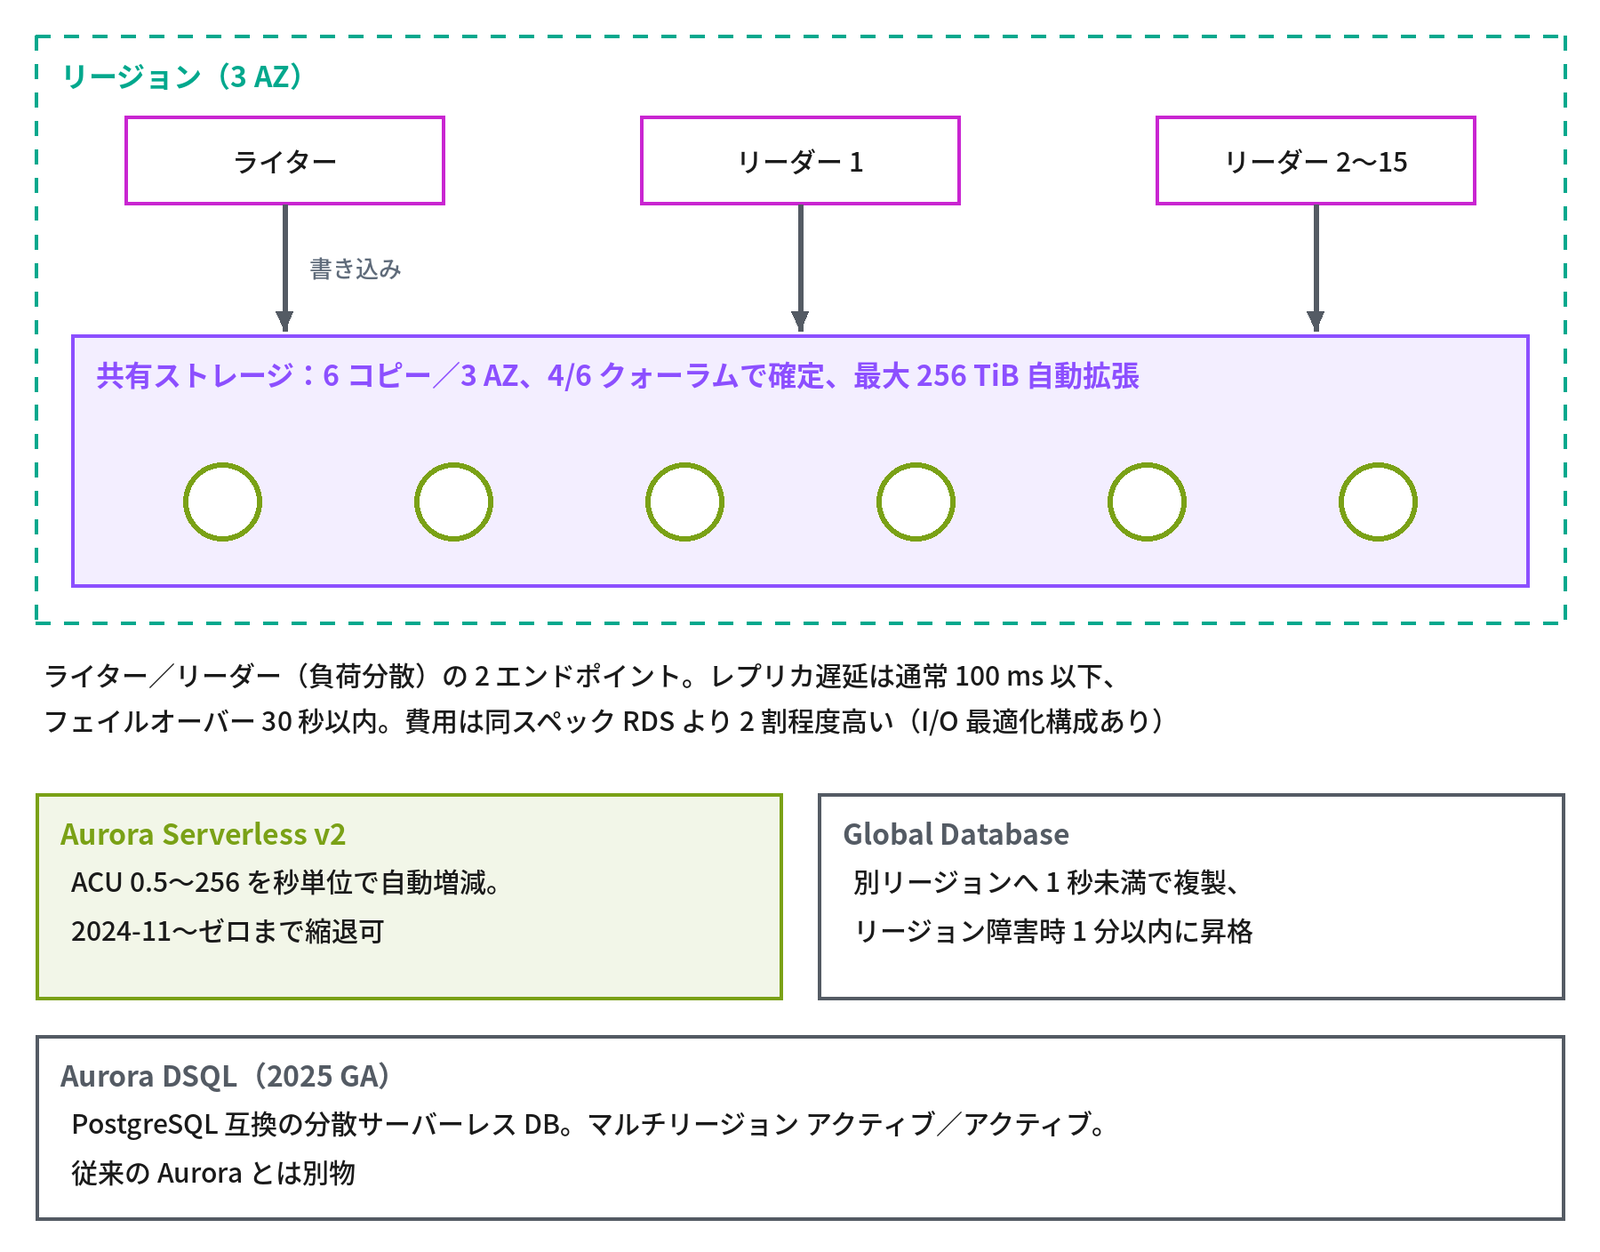
- AWS が設計した MySQL 互換/PostgreSQL 互換の RDB。エンジンの SQL 層は互換で、ストレージ層を分散システムに置き換えたのが本質
- ストレージは 3 AZ に6コピーを自動で持ち、書き込みは 4/6 のクォーラムで確定。最大 256 TiB(2025年7月に 128 → 256 TiB に拡張。対応するバージョンへの更新が必要)まで自動で拡張し、使った分だけ課金
- インスタンスはストレージを共有するため、リードレプリカ(最大15台)の遅延は通常 100 ms 以下、フェイルオーバーは30秒以内。ライターエンドポイントとリーダーエンドポイント(負荷分散)を使い分ける
- Aurora Serverless v2:ACU(0.5〜256)単位で秒単位に自動スケール。2024年11月からゼロまで縮退(アイドルのときは停止)できる。開発環境・変動する負荷に
- Global Database:別のリージョンに1秒未満の遅延で複製し、リージョンの障害のときは1分以内に昇格
- Aurora DSQL(2025年 GA):PostgreSQL 互換の分散サーバーレス DB。マルチリージョンでアクティブ/アクティブ。従来の Aurora とは別物
- 費用は同じスペックの RDS より2割程度高いが、I/O 課金なしの「I/O 最適化」構成もある。可用性・性能の要件が高ければ Aurora、コスト最優先や Oracle/SQL Server なら RDS を選ぶ
Amazon DynamoDB
DynamoDB はフルマネージドの NoSQL(キーバリュー/ドキュメント型)のデータベースで、サーバー・容量の管理が無く、テーブルを作れば即使えます。データは「パーティションキー」(+任意の「ソートキー」)で格納され、キーによる読み書きはデータ量に関係なく1桁ミリ秒で応答します。
RDB が得意な JOIN・トランザクション・アドホックな集計は不得手で、アクセスパターンを先に決めてからテーブルを設計します(RDB とは逆の順序です。RDB の結合とトランザクションは連載「RDB・SQL入門」第3回・第6回、NoSQL の分類は第15回で扱います)。1項目は最大 400 KB で、キー以外の検索には GSI(グローバルセカンダリインデックス)を作ります。課金はオンデマンド(リクエスト数)かプロビジョンド(RCU/WCU を確保)で、常時の無料枠 25 GB があります(2026年9月時点)。
付随する機能として、TTL(期限切れの項目の自動削除)、Streams(変更を Lambda へ流す)、Global Tables(マルチリージョンのアクティブ/アクティブの複製)、PITR、DAX(インメモリキャッシュ)があります。Amazon.com の買い物かごを支える技術として2012年に登場し、セッション管理、IoT のテレメトリ、ゲームのランキング、Lambda のバックエンドといった「大量・単純・低遅延」の用途で標準的に使われています。
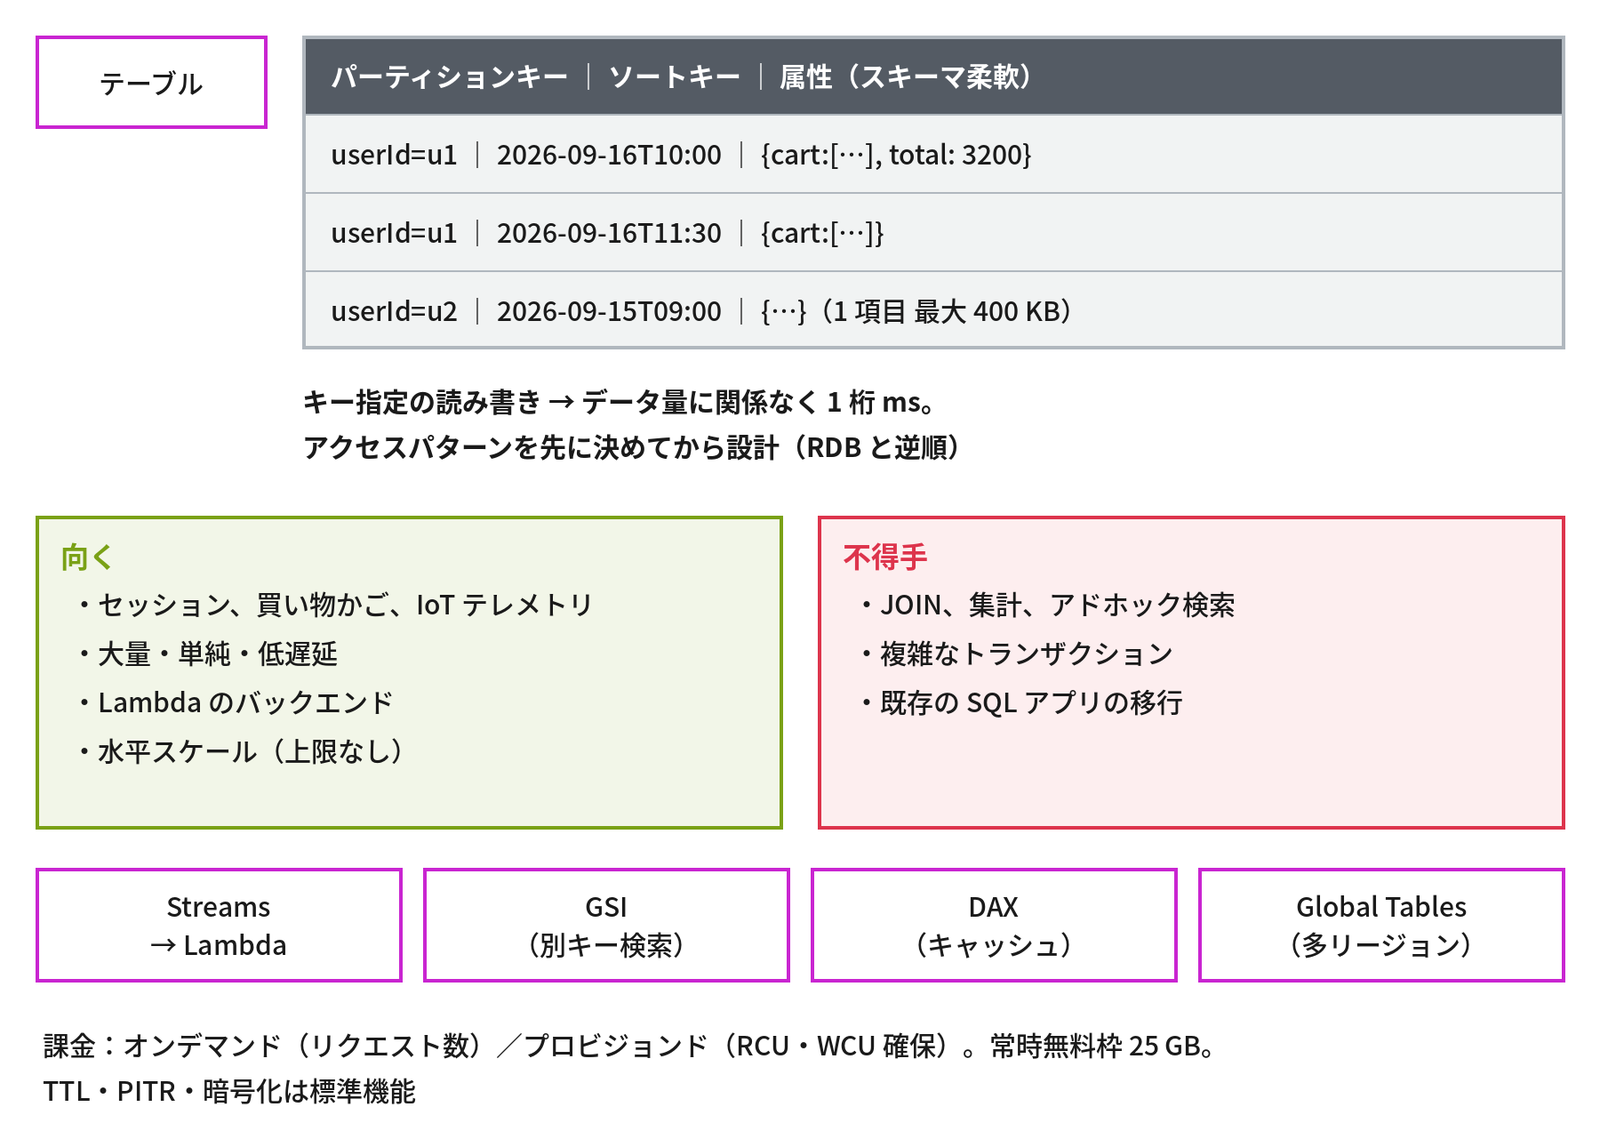
- キーバリュー型。キー検索は量に関係なく1桁 ms
- アクセスパターン先行の設計。JOIN・集計は不得手
- オンデマンド/プロビジョンド課金。Global Tables で多リージョン
その他のデータベース・分析サービス
RDS・Aurora・DynamoDB 以外にも、用途ごとのサービスがあります。
| サービス | 種別 | 互換/用途 |
|---|---|---|
| ElastiCache | インメモリキャッシュ | Valkey(Redis 互換、2024 年〜。Redis のライセンス変更を受けた OSS フォーク)/Redis OSS/Memcached。セッション、ランキング、DB の前段キャッシュ |
| MemoryDB | 永続化付きインメモリ | Valkey/Redis 互換で耐久性あり。プライマリ DB として使える |
| Redshift | データウェアハウス(列指向) | PostgreSQL 系 SQL。大量データの集計・BI。Serverless あり |
| Athena | S3 上のデータへの SQL | サーバーレス。スキャン量課金。ログ分析の第一選択 |
| OpenSearch Service | 全文検索・ログ分析 | Elasticsearch 互換(フォーク)。syslog などのログ基盤の受け皿 |
| DocumentDB | ドキュメント DB | MongoDB 互換 |
| Neptune | グラフ DB | Gremlin/SPARQL/openCypher |
| Keyspaces | ワイドカラム | Apache Cassandra 互換 |
| Timestream | 時系列 DB | IoT・メトリクス |
| DMS(Database Migration Service) | 移行ツール | オンプレ → RDS/Aurora の継続的レプリケーション、異種 DB 変換(SCT) |
「S3 に置いて Athena で SQL」は、ログ調査の最も安い基盤として覚えておきましょう。ログを集約して検索する流れが、CloudWatch Logs → S3 → Athena で実現できます(ログの検索基盤は、このブログの連載「syslog入門」第8回の「検索基盤とは」と、第9回の「S3への保管とAthenaでの検索」で詳しく扱います)。
なお、Timestream のうち Timestream for LiveAnalytics は、2025年6月から新しい顧客は使えなくなりました(AWS の発表による)。新しく時系列 DB を選ぶときは、Timestream for InfluxDB を確かめてください。
RDB と NoSQL の使い分け
RDS/Aurora と DynamoDB を、観点ごとに比べます。
| 観点 | RDS/Aurora | DynamoDB |
|---|---|---|
| データモデル | 正規化されたテーブル、スキーマ固定 | キーと属性、スキーマ柔軟 |
| クエリ | SQL、JOIN、集計、アドホック検索 | キー指定、インデックス経由の限定的な検索 |
| 整合性・トランザクション | ACID、複雑なトランザクション | 単項目は強整合可、トランザクションは限定的 |
| スケール | 垂直+読み取りの水平(レプリカ) | 水平(自動パーティション)。上限は実質なし |
| 遅延 | ms〜(クエリ次第) | 1 桁 ms(一定) |
| 運用 | パラメータ・インデックス・接続数の管理 | キャパシティ設計(オンデマンドなら不要) |
| 費用の性質 | インスタンス時間(常時) | リクエスト数+容量(アイドル時は安い) |
| 向く例 | 会計、在庫、ERP、既存の SQL アプリ | セッション、カート、IoT、Lambda のバックエンド |
「新しいから NoSQL」「慣れているから RDB」ではなく、アクセスパターンとデータ間の関係の複雑さで決めましょう。1つのシステムで、注文は Aurora、セッションは DynamoDB、検索は OpenSearch のように併用する(ポリグロット・パーシステンス)のが普通です。
バックアップと災害対策(DR)
DB のバックアップと、リージョンの障害への備えです。
- 自動バックアップ:日次のスナップショット+5分ごとのトランザクションログで、保持期間(最大35日)内の任意の秒にポイントインタイムリカバリ(PITR)。復元は「新しいインスタンスを作る」形(既存を上書きしない)
- 手動スナップショット:保持は無期限。別のリージョン・別のアカウントへコピーできる。KMS で暗号化したスナップショットをクロスアカウントで共有するには、鍵の共有も必要
- AWS Backup(第5回)で RDS/Aurora/DynamoDB もポリシーで管理し、Vault Lock で削除から守る
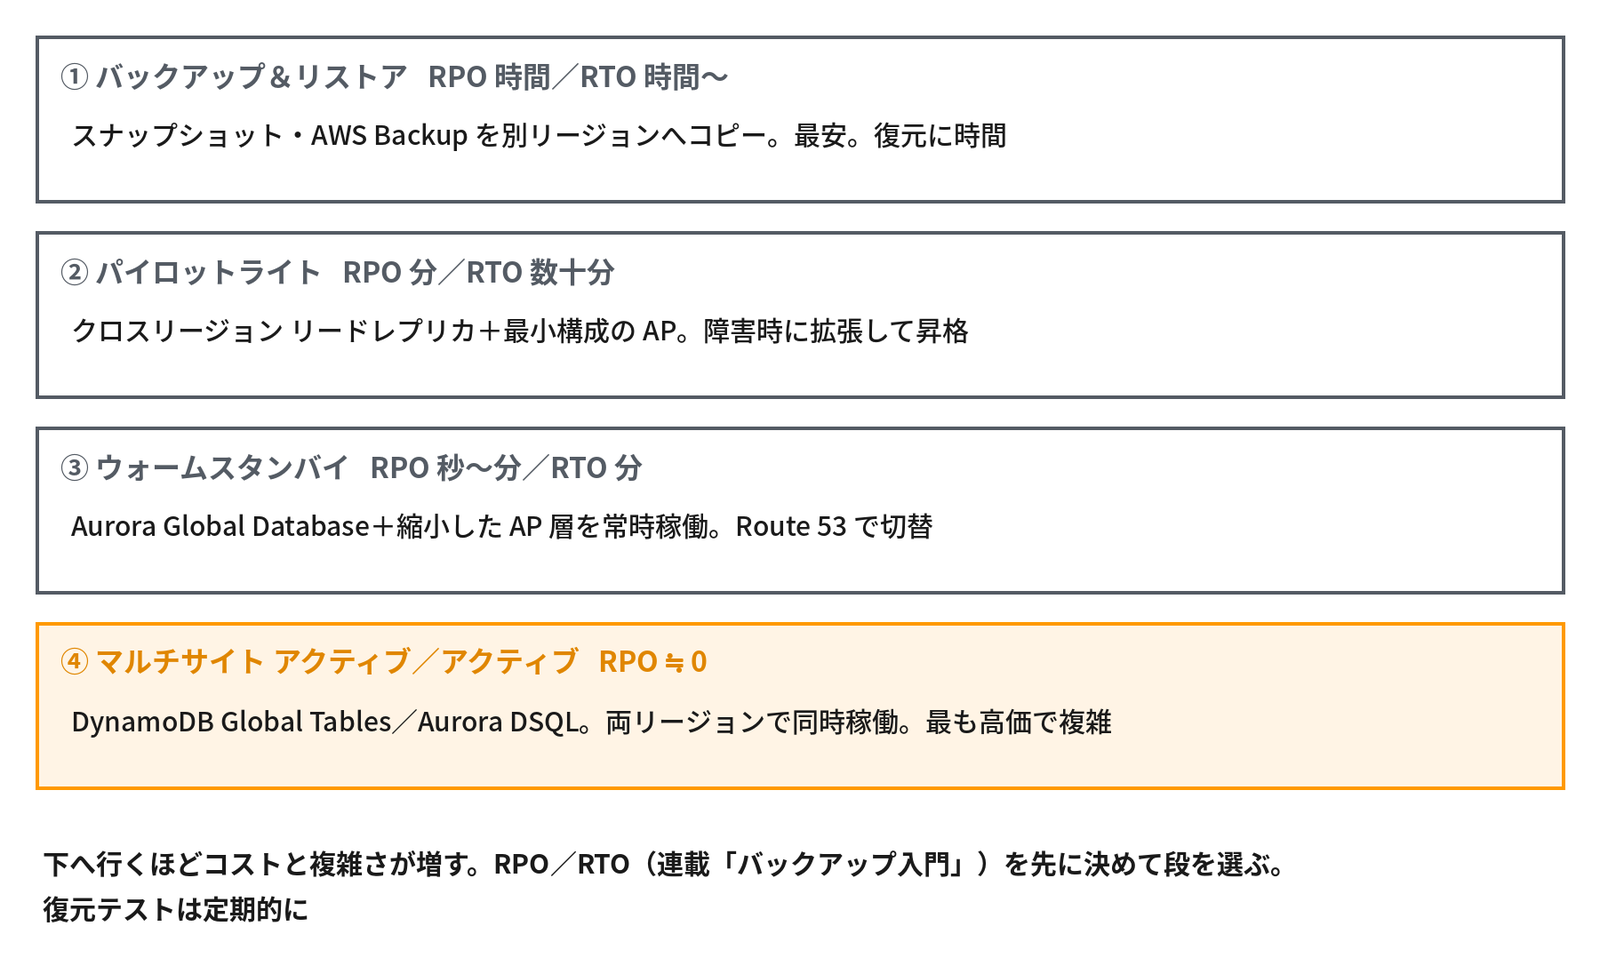
- DR の段階(RPO/RTO で整理):
- バックアップ&リストア(RPO 時間、RTO 時間〜):スナップショットを別のリージョンへコピー
- パイロットライト(RPO 分、RTO 数十分):クロスリージョンのリードレプリカを最小構成で待機
- ウォームスタンバイ(RPO 秒〜分、RTO 分):Aurora Global Database+縮小した AP 層
- マルチサイト・アクティブ/アクティブ(RPO ほぼ0):DynamoDB Global Tables、Aurora DSQL
- 復元テストを定期的に行う。「バックアップは取れていたが、復元の手順が無かった」が最も多い失敗
RPO・RTO の決め方は、このブログの連載「バックアップ入門」第2回の「RPO・RTO と SLA の決め方」で、RDS のポイントインタイムの復元と AWS Backup は第9回の「RDS をポイントインタイムで戻す」「別アカウント・別リージョンへのコピー」で詳しく扱います。
DB への接続とセキュリティ
DB をどこに置き、どう接続させるかです。
- 配置:プライベートサブネット、パブリックアクセスは「なし」。SG は AP 層の SG からだけエンジンのポート(3306/5432/1433/1521)を許可(第6回の SG のルール例)
- 認証情報:マスターパスワードは Secrets Manager での管理を選ぶ(自動ローテーション)。アプリは起動時に Secrets Manager から取得する。IAM DB 認証なら15分有効のトークンでパスワードが要らない(MariaDB/MySQL/PostgreSQL。接続数の多い用途には不向き)
- Kerberos 認証:Managed AD と連携し、Windows 統合認証で SQL Server/PostgreSQL に接続(このブログの連載「Kerberos入門」第12回の「クラウドの Kerberos」で詳しく扱います。そこでは MySQL・Oracle・Db2 も挙げています。Managed AD は連載「Active Directory入門」第13回)
- 通信の暗号化:RDS は TLS に対応。
require_secure_transport(MySQL)/rds.force_ssl(PostgreSQL)で強制する。証明書は RDS の CA バンドル(rds-ca-rsa2048-g1など。2024年に旧 CA から更新)を信頼する(信頼ストアの考え方は、このブログの連載「証明書入門」第5回の「信頼ストア」で詳しく扱っています) - 監査:エンジンの監査ログ(MySQL の MariaDB Audit Plugin、PostgreSQL の pgAudit、SQL Server の Audit)を CloudWatch Logs へ出力。API の操作は CloudTrail
- 削除保護と最終スナップショット:本番は削除保護を有効にする。削除のときに最終スナップショットを取る設定を既定にする
- 接続の確認:TLS を必須にして接続する
$ mysql -h xxx.rds.amazonaws.com -u admin -p --ssl-mode=REQUIRED
$ psql "host=xxx sslmode=require"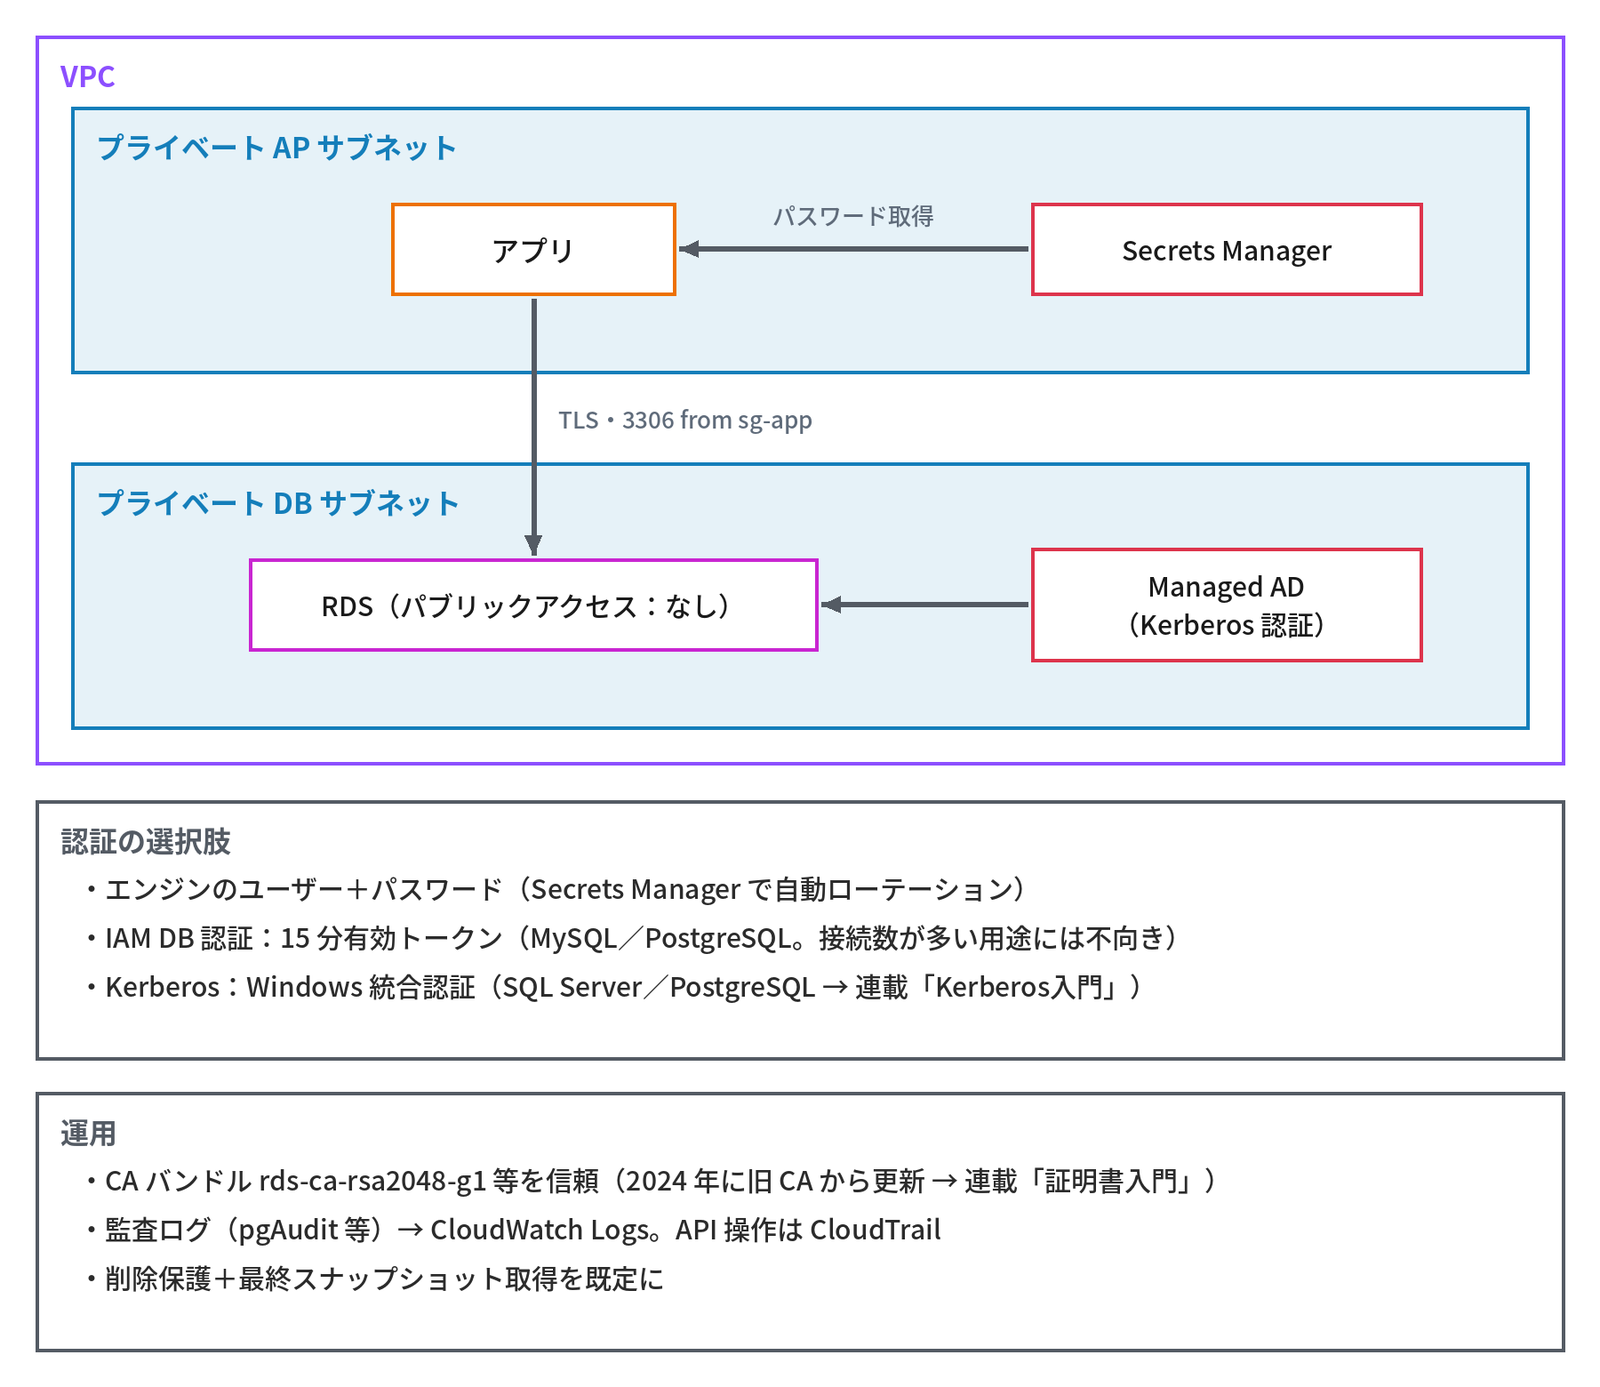
Azure との対応表:データベース
Azure のデータベースとの対応です。
| AWS | Azure | 補足 |
|---|---|---|
| RDS for MySQL/PostgreSQL | Azure Database for MySQL/PostgreSQL(Flexible Server) | Azure も「ゾーン冗長 HA」でマルチ AZ 相当 |
| RDS for SQL Server | Azure SQL Database(PaaS)/SQL Managed Instance(互換性重視)/SQL Server on VM | Azure は SQL Server の選択肢が 3 段階 |
| RDS for Oracle | (相当なし。Oracle Database@Azure は Oracle が OCI を Azure DC 内で提供) | |
| Aurora | Azure SQL Database Hyperscale/Cosmos DB for PostgreSQL | 明確な 1:1 は無い |
| DynamoDB | Azure Cosmos DB(NoSQL API、Table API) | Cosmos DB は複数 API(MongoDB、Cassandra、Gremlin も) |
| ElastiCache | Azure Managed Redis | Azure Cache for Redis は廃止予定(Basic・Standard・Premium は2028年9月30日、Enterprise は2027年3月31日) |
| Redshift | Azure Synapse Analytics/Microsoft Fabric | |
| Athena | Synapse Serverless SQL/Fabric | |
| OpenSearch | Azure AI Search(用途は一部) | |
| DMS | Azure Database Migration Service | |
| Secrets Manager(RDS 連携) | Key Vault |
なお、Azure Cosmos DB for PostgreSQL は廃止に向かっており、新しいプロジェクトには勧められていません。Microsoft は、PostgreSQL の分散には Azure Database for PostgreSQL の Elastic Clusters を案内しています。
考えてみよう
- 手元の RDS は、マルチ AZ DB インスタンス・マルチ AZ DB クラスター・シングル AZ のどれですか。レポートのクエリをどこへ流すのがよいか、冒頭の1つ目の相談に沿って考えてください
- アプリが Java なら、JVM の DNS キャッシュの設定(
networkaddress.cache.ttl)と接続プールの再接続の設定を確かめ、--force-failoverの訓練で切り替わるまでの時間を測ってください - 次のデータは RDS/Aurora と DynamoDB のどちらに置きますか。①受注と在庫、②ログイン中のセッション、③月次の売上の集計。DR の段階は、それぞれ RPO・RTO から選んでください
ヒント:1は「RDS の可用性:マルチ AZ」と「リードレプリカとスケーリング」、2は「RDS の可用性:マルチ AZ」、3は「RDB と NoSQL の使い分け」と「バックアップと災害対策(DR)」の節を見直してください。
まとめ
- マネージド DB はパッチ・バックアップ・フェイルオーバーを AWS に任せる。代わりに OS ログイン不可、設定はパラメータグループ
- マルチ AZ = 可用性(同期・読めない)、リードレプリカ = 性能(非同期・読める)。混同しない
- 切り替えの時間はアプリの再接続と DNS のキャッシュで決まる。DB には必ず DNS 名で接続する
- Aurora はストレージ層を分散化した RDB(6コピー/3 AZ)。Serverless v2・Global Database・DSQL がある
- DynamoDB はアクセスパターン先行の設計で、大量・単純・低遅延に向く。RDB との併用が普通
- DR は RPO・RTO から4段階を選び、復元テストを定期的に行う
次回は、運用・監視・コストの前編として、CloudWatch・CloudTrail・Config・Systems Manager による監視と記録を扱います。
連載「クラウド入門」全14回
- クラウドとは(定義・歴史・責任分界)
- AWSの全体像
- コンピューティング 前編(EC2・Nitro・インスタンスタイプ・AMI・IMDS)
- コンピューティング 後編(課金と購入オプション・Auto Scaling・ELB・コンテナ・Lambda)
- ストレージ
- ネットワーキング 前編(VPC・サブネット・SG・NACL)
- ネットワーキング 後編(DNS・接続・Route 53・CloudFront)
- IAMとセキュリティ 前編(IAM・ポリシー・STS・ID連携・Organizations)
- IAMとセキュリティ 後編(KMS・シークレット・ACM・検知と防御)
- データベース(この記事)
- 運用・監視・コスト 前編(CloudWatch・CloudTrail・Config・SSM)
- 運用・監視・コスト 後編(タグ・転送料金・コスト管理・Control Tower・IaC)
- Well-Architectedフレームワーク
- これまでのテーマとAWSの対応・まとめ
コメント