「で、うちの会社のログは、どうやって集めればいいんですか?」
仕組みや設定を学んだ後に出てくるのが、この問いです。ログ管理の設計にも、正解は1つではありません。送信元の種類と数、運用の人数、監査の要件、クラウドの有無……どの要件を重く見るかで、選ぶ案が変わります。
連載の最終回となる第11回では、第1回〜第10回の知識を使って、4つの設計演習に取り組みます。答えを覚えるのではなく、要件から案を選ぶ筋道を身に付けましょう。
演習の進め方
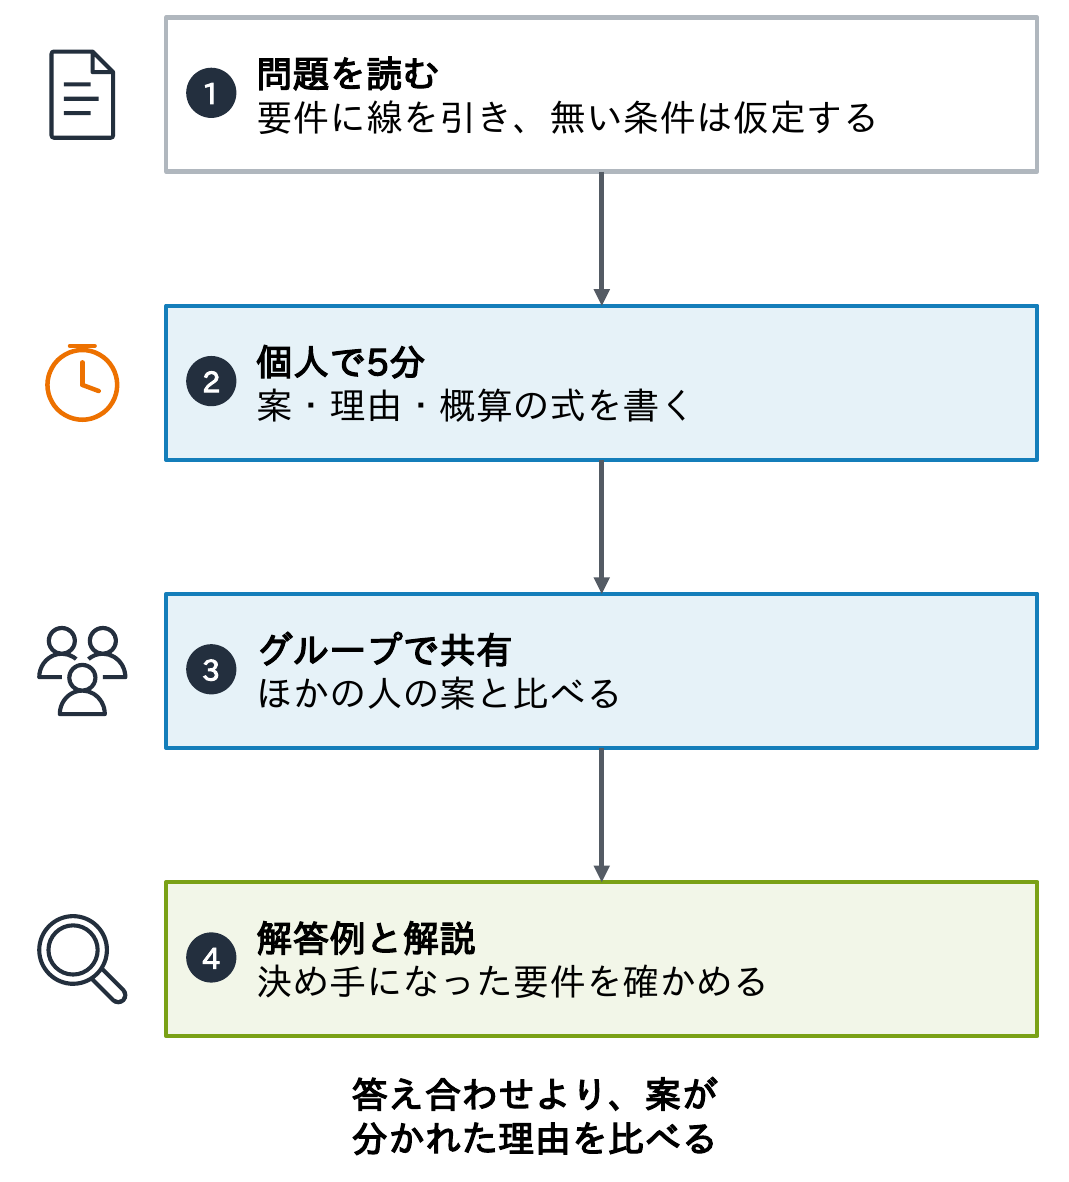
- 各問は「問題 → 解答例 → 解説」の順に進みます
- まず5分考え、選ぶ案と、その理由を書き出します。容量や費用は、概算の式を書くところまでで構いません
- 最初にすべきことは、要件と現状の確認です。問題文に書かれていない条件(体制、予算、ログの量)は、どう仮定したかを明記します
問1 500名の会社のログを1か所に集める
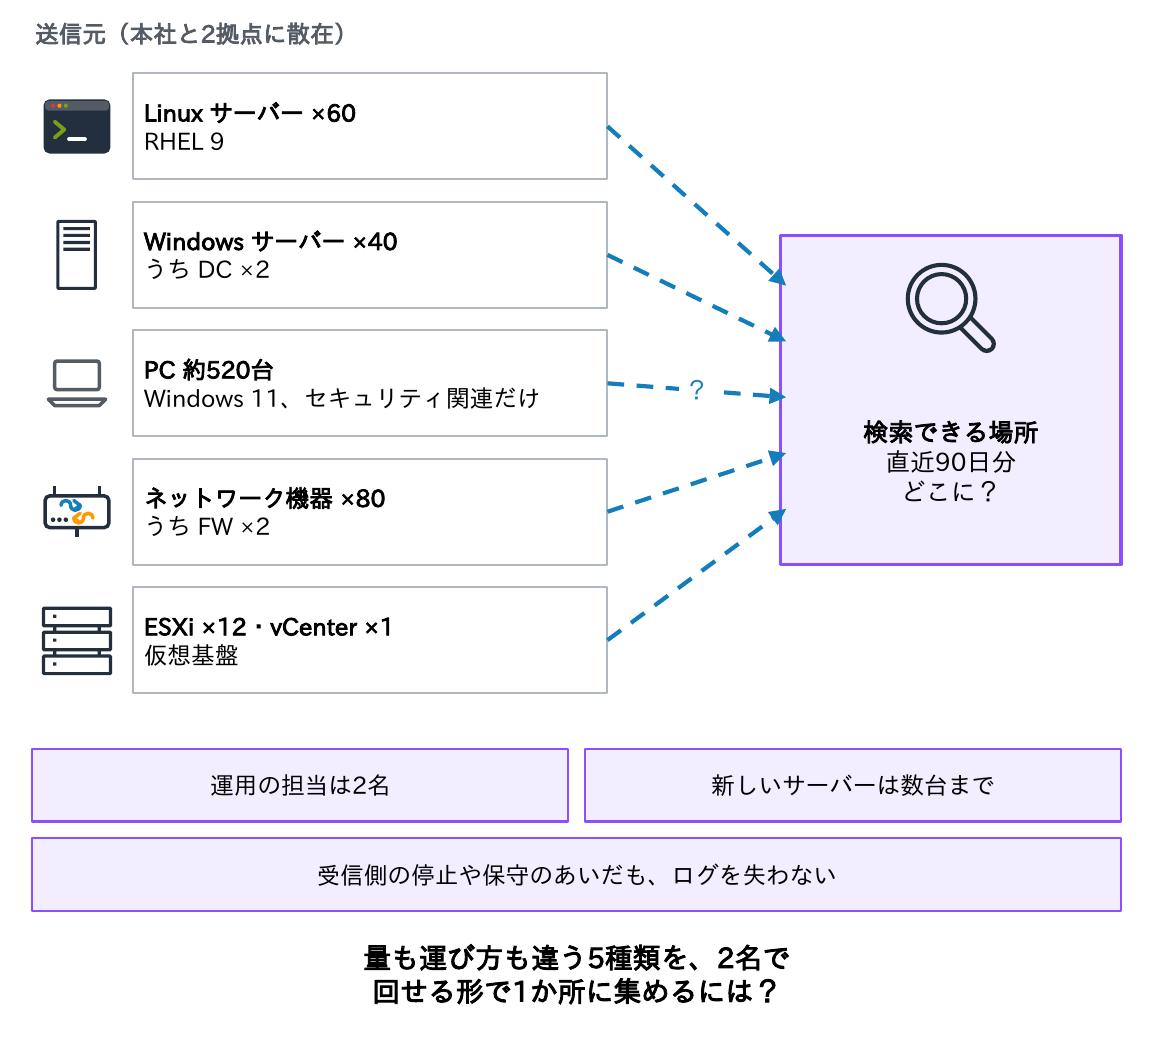
- 状況:従業員500名の会社(本社と2拠点)で、ログがサーバーや機器ごとに散らばっている。障害やセキュリティの調査のため、1か所に集めて検索できるようにする
- 対象:Linuxサーバー60台(RHEL 9)、Windowsサーバー40台(DC 2台を含む)、PC約520台(Windows 11)、ネットワーク機器80台(FW 2台を含む)、ESXi 12台とvCenter 1台
- 要件:直近90日分を検索できること。受信側の停止や保守のあいだもログを失わないこと。PCはセキュリティ関連のイベントだけ集める
- 制約:運用の担当は2名。新しいサーバーは数台までなら置ける
考えるポイント:送信元ごとの収集の方式(syslog・WEF・エージェント)、中継の要否、容量の見積もり、冗長。
問1 解答例
| 案 | 構成 | メリット | デメリット |
|---|---|---|---|
| A | すべて syslog にそろえ、1台の rsyslog サーバーへ UDP 514 で送ってファイルに保存する | 構成が単純で、費用がほとんどかからない | UDP で抜け、1台が止まると失う。Windows 全台に syslog へ変換するエージェントが要る。ファイルでは横断の検索が遅い |
| B | 送信元ごとに方式を分け、中継を2台置く。Linux は rsyslog(TCP+ディスクキュー)、Windows は WEF で収集サーバー(WEC)に集めてから転送、NW 機器・ESXi は syslog で中継へ。中継から検索基盤へ送る | OS と機器の標準機能で集められ、PC にエージェントが要らない。中継でバッファーと形式の統一ができる | 構成要素が増え、WEF と中継の運用・監視が必要 |
| C | 全台にエージェント(Fluent Bit や SIEM 製品のエージェント)を入れ、SaaS の SIEM へ直接送る | 検索と相関分析がすぐに使え、基盤の運用が少ない | NW 機器・ESXi にはエージェントを入れられず、syslog の受け口が別に要る。取り込み量に応じた費用が大きい |
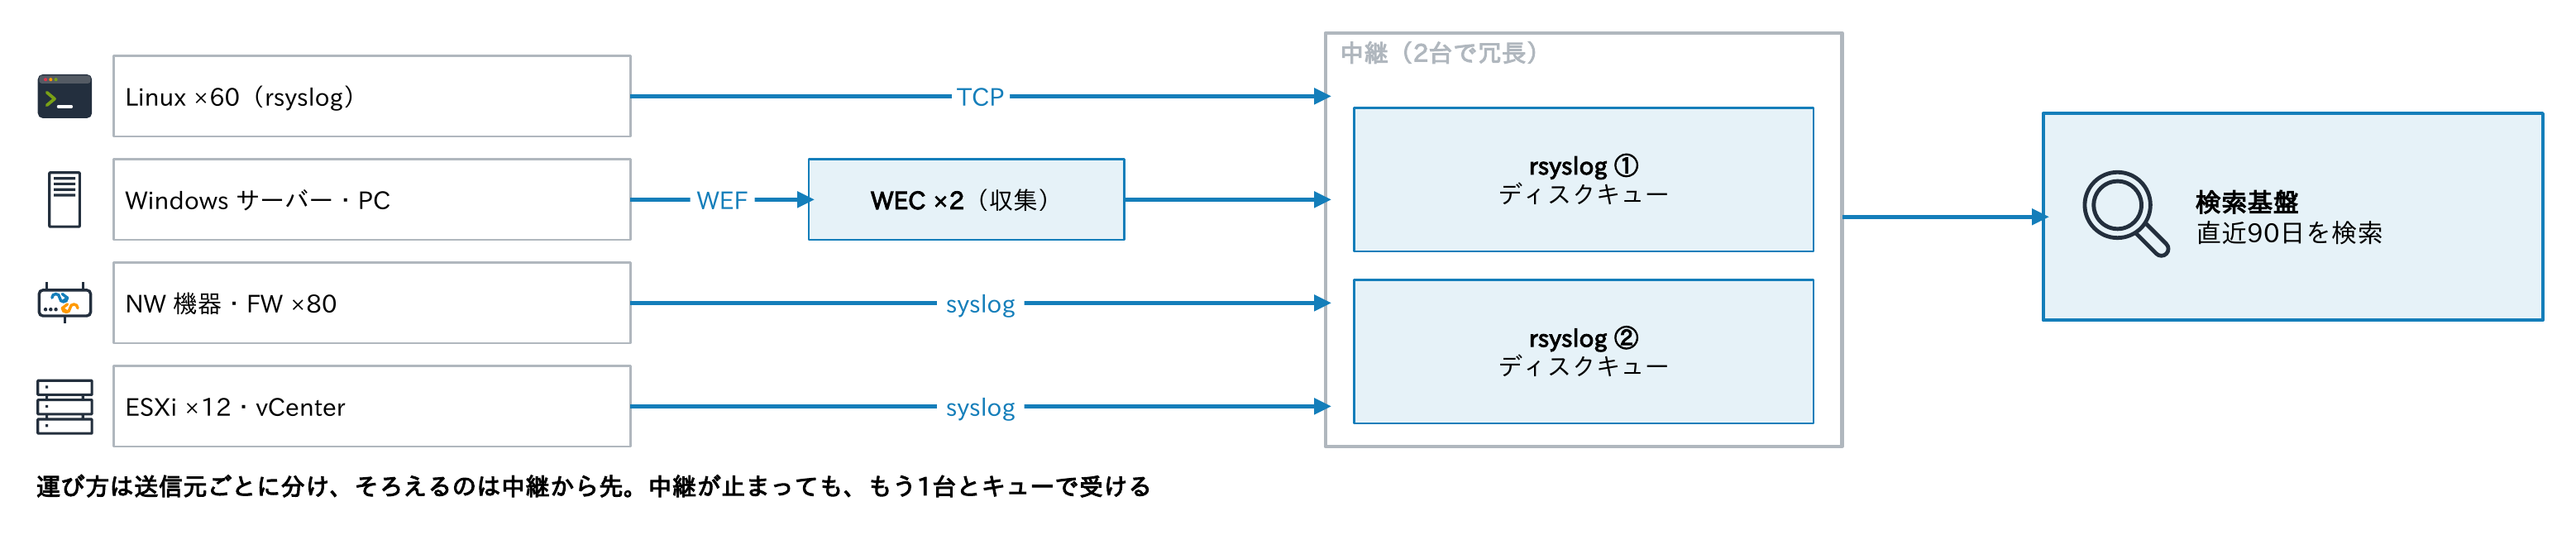
機器の種類が多く、運用が2名である点から、案Bが基本です。案Cは、案Bの中継の送り先をSaaSにする形で組み合わせられます。ESXiはUDP・TCP・TLSを選べますが、TLSの既定のポートが1514など、機器ごとの違いに注意します(第6回)。
運び方は送信元ごとに分け、そろえるのは中継から先。これがポイントです。
問1 解説:容量の見積もり
| 送信元 | 台数 | 1台の平均 EPS(仮定) | 合計 EPS |
|---|---|---|---|
| Linux サーバー | 60 | 2 | 120 |
| Windows サーバー(DC を除く) | 38 | 5 | 190 |
| DC | 2 | 100 | 200 |
| PC(セキュリティ関連のみ) | 520 | 0.5 | 260 |
| NW 機器(FW を除く) | 78 | 0.5 | 39 |
| FW | 2 | 150 | 300 |
| ESXi・vCenter | 13 | 5 | 65 |
| 合計 | 713 | — | 約1,200 |
1日の量  = 1,200 EPS × 500 バイト × 86,400 秒 ≒ 52 GB/日(生データ)
90日分   = 52 GB × 90 ≒ 4.7 TB(検索基盤は索引と複製で 1〜2倍を見込む)
ピーク時 = 平常の 3〜5倍(障害・攻撃・一斉の更新)→ 4,000〜6,000 EPS を受けられるように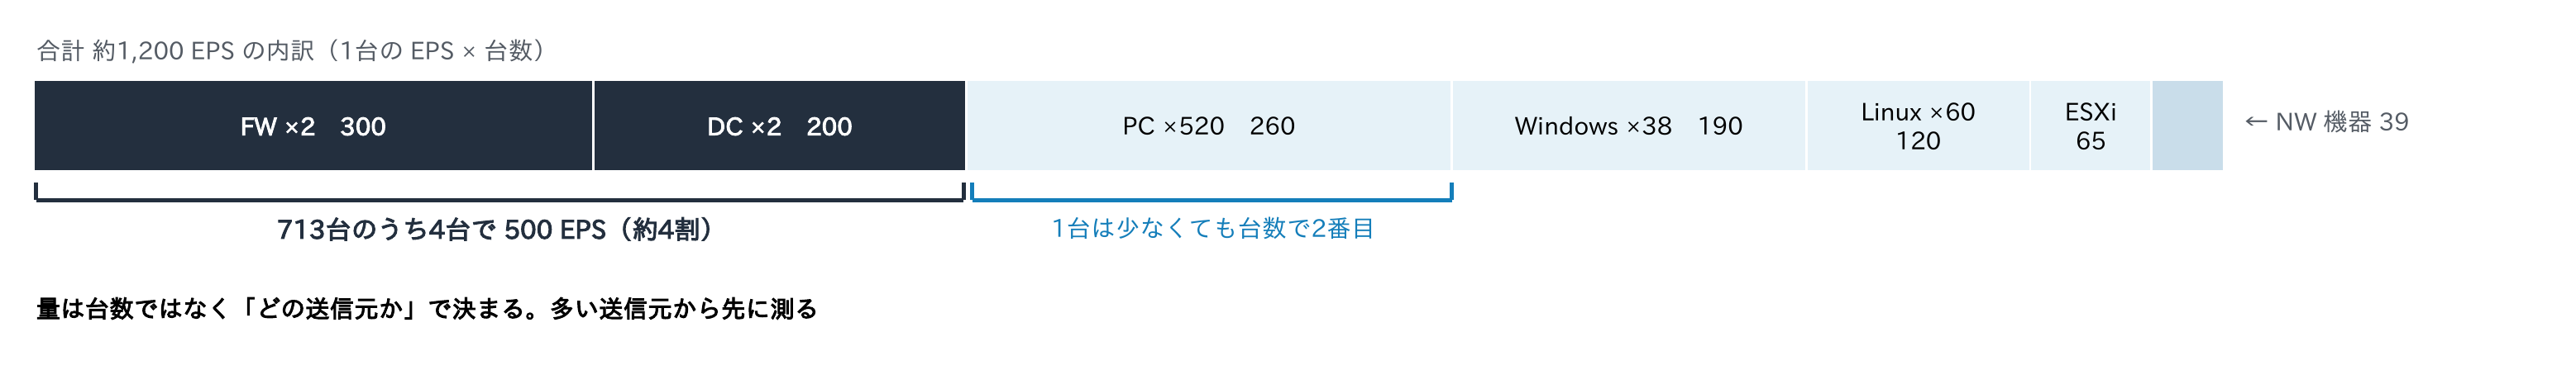
EPS(1秒あたりの件数)と1件の大きさは仮定です。実際には1〜2週間、中継のimpstatsや既存の機器の送信量で測ってから決めます。DCとFWだけで全体の4割を占めるように、量は一部の送信元に偏ります(第7回)。
問2 監査で「改ざん防止と1年保存」を求められた
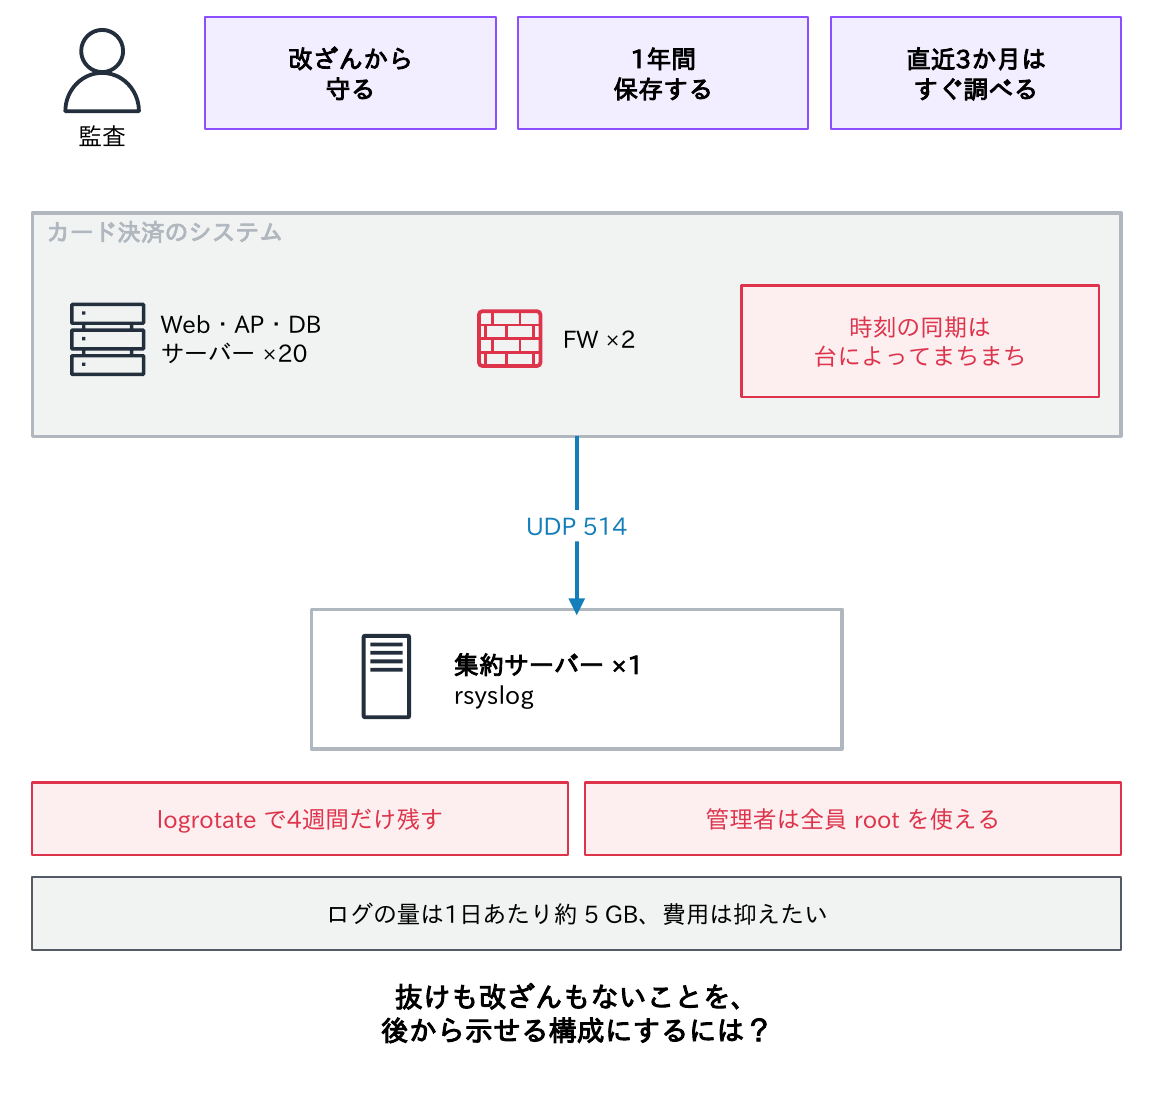
- 状況:カード決済を扱うシステム(Web・AP・DBのサーバー20台、FW 2台)を運用している。監査で「ログを改ざんから守り、1年間保存すること。直近3か月はすぐに調べられること」と指摘された
- 現状①:各サーバーはUDP 514でrsyslogの集約サーバー1台へ送り、集約サーバーはlogrotateで4週間分だけ残している
- 現状②:サーバーの管理者は全員、集約サーバーのrootも使える。サーバーの時刻同期は、台によって設定がまちまち
- 要件:抜けや改ざんがないことを、後から示せること。費用は抑えたい。ログの量は1日あたり約5 GB
考えるポイント:転送の信頼性と暗号化、保存先の改ざん防止、検索用と保管用の分け方、時刻の証跡。
問2 解答例
| 案 | 構成 | メリット | デメリット |
|---|---|---|---|
| A | 集約サーバーの logrotate を1年分に延ばし、ディスクを増やす | すぐにでき、費用が小さい | UDP の抜けが残る。root を使える人は誰でも消せて、改ざんがないことを示せない |
| B | 送信を TLS(6514)とディスクキューにし、必要なら RELP も使う。直近3か月は検索基盤に置き、日ごとのファイルのハッシュを取って WORM のストレージ(S3 Object Lock のコンプライアンスモード等)へ1年保管する。集約サーバーとアーカイブの管理者を分ける | 抜け・盗聴・改ざんのそれぞれに手当てがあり、証跡を示せる。保管の費用が安い | 設計と運用の手間が増える。WORM は期間中に誰も消せないため、保存期間の設定を誤ると費用が残り続ける |
| C | SaaS の SIEM へ送り、1年分をオンラインで保管する | 検索・改ざん防止・アクセス管理を製品に任せられる | 1年分をすべて検索できる状態で持つと費用が大きい。製品を替えるときの移行が難しい |
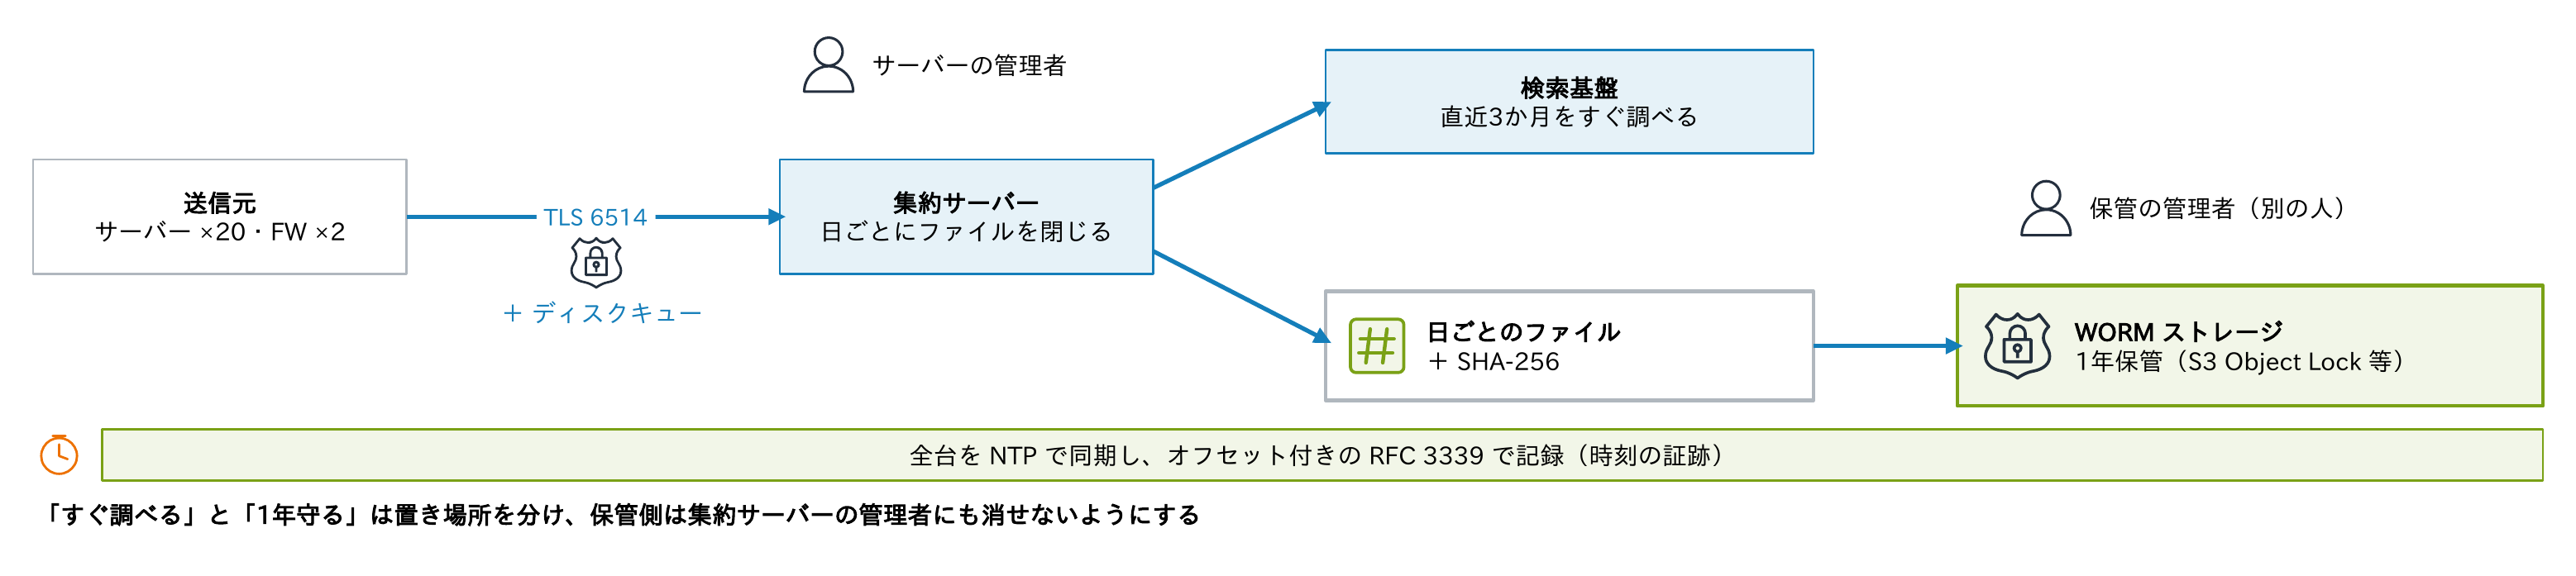
案Bが有力です。1年分は約1.8 TB(5 GB × 365日)で、圧縮すればその数分の1になります。PCI DSS v4.0.1の要件10も、12か月の保存と直近3か月をすぐに分析できることを求めています(第1回・第7回)。
問2 解説:抜け・盗聴・改ざん・時刻への手当て
| 脅威 | 手当て | 確かめ方 |
|---|---|---|
| 転送中の抜け | TCP とディスクキュー(queue.type=”LinkedList”、queue.filename、action.resumeRetryCount=”-1″)。受け取りの確認まで要るなら RELP(第4回・第5回) | impstats の破棄数、送信元ごとの件数の突き合わせ |
| 盗聴・なりすまし | TLS(RFC 5425、6514。暗号スイートは RFC 9662 で更新)と、証明書による相互の確認 | openssl s_client -connect 集約サーバー:6514、Test-NetConnection -Port 6514(TCP まで) |
| 保存後の改ざん・削除 | 日ごとにファイルを閉じて SHA-256 を取り、ハッシュの一覧も別の場所へ。保管先は WORM | sha256sum -c、Get-FileHash -Algorithm SHA256 |
| 管理者による消去 | 集約サーバーの root と、アーカイブを管理する権限を分け、操作も記録する | 権限の棚卸し、操作の記録(CloudTrail 等) |
| 時刻の信頼性 | 全台を NTP で同期し、オフセット付きの RFC 3339 で記録。同期の状態も記録を残す | chronyc tracking の定期的な記録(連載「NTP入門」第7回) |
| 1年の保存と検索 | 直近3か月は検索基盤、それ以降はアーカイブから戻して検索する | 取り出しの手順を年に1回試す |
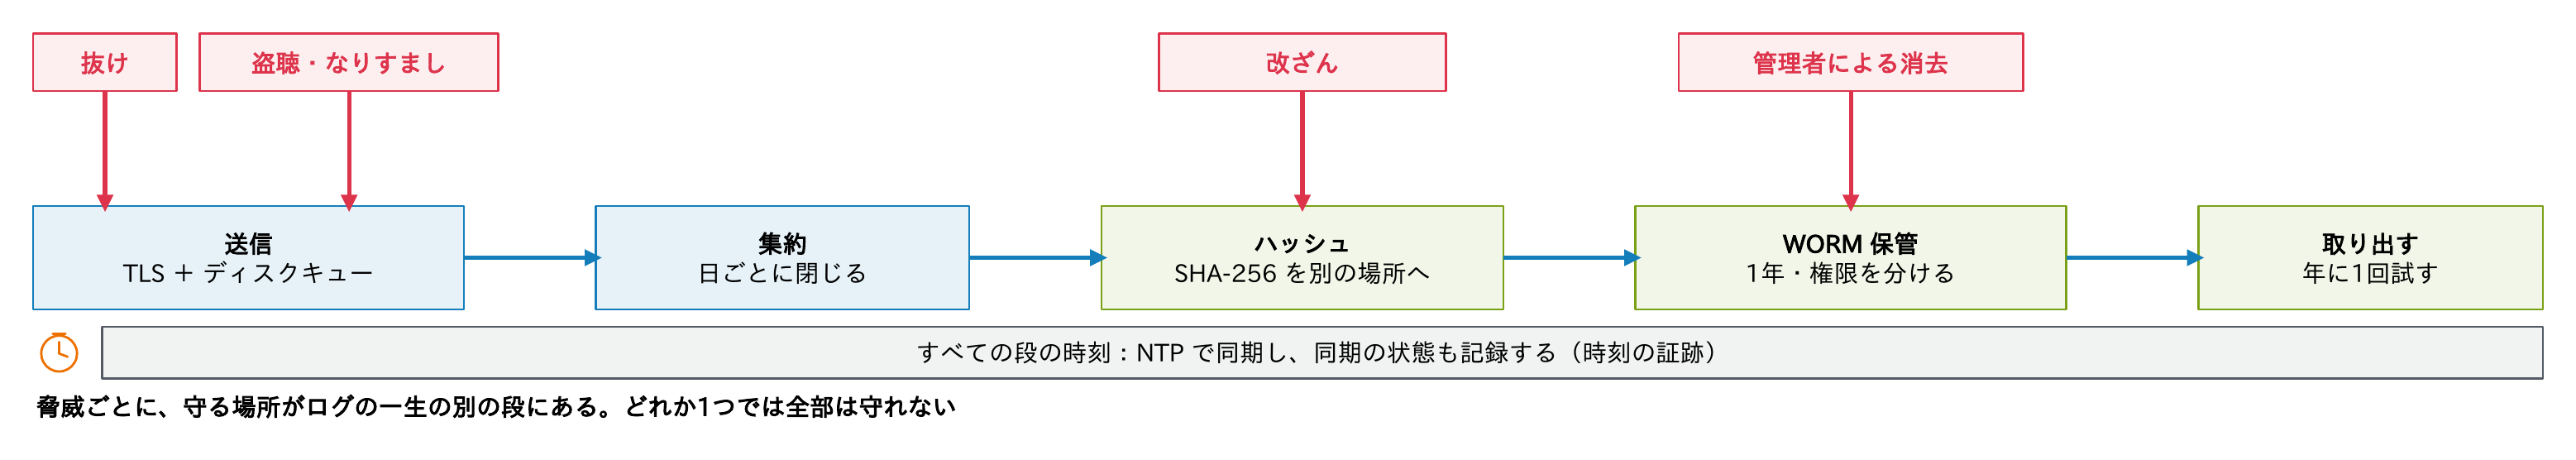
RFC 5848(署名付きsyslog)は対応する製品が限られるため、ファイル単位のハッシュとWORMで守るのが現実的です。AWSのCloudTrailは、ログのハッシュと署名(ダイジェストファイル)を1時間ごとに自動で作ります(第9回)。脅威ごとに、守る場所がログの一生の別の段にあるのです。
問3 オンプレとAWSのログを一元的に検索する
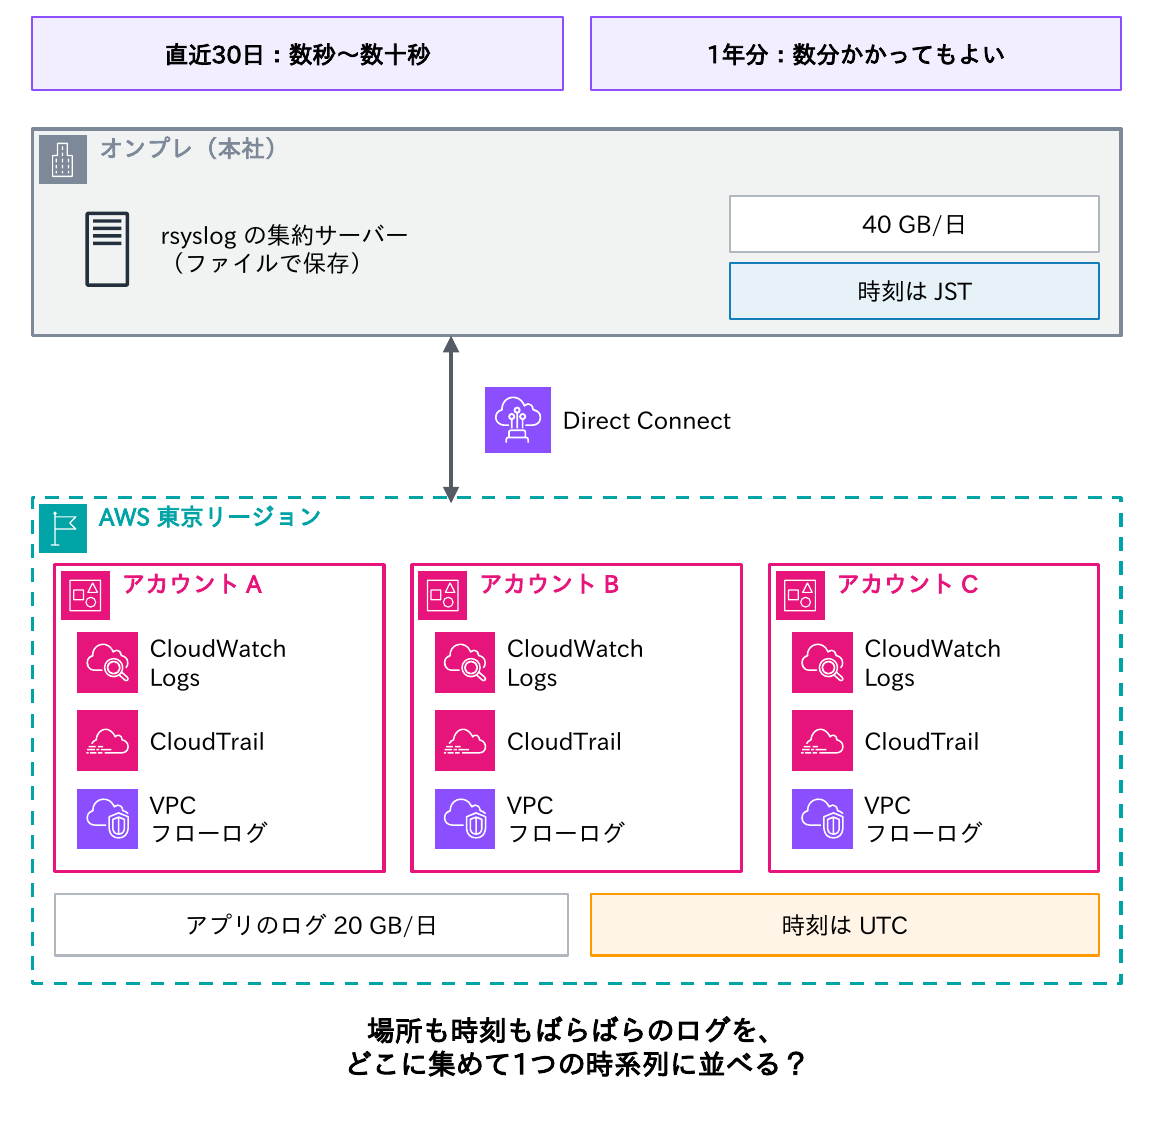
- 状況:業務システムの一部をAWS(東京リージョン、アカウント3つ)へ移した。オンプレの本社とは、Direct Connectでつながっている
- 現状①:オンプレは、rsyslogの集約サーバーにファイルで集めている(1日約40 GB)
- 現状②:AWS側は、EC2のアプリのログがアカウントごとのCloudWatch Logsに(1日約20 GB)、CloudTrailとVPCフローログが別々の場所にある
- 要件:障害や不正アクセスのとき、両方のログを時系列に並べて検索したい。直近30日は数秒〜数十秒で、1年分は数分かかってもよい
- 時刻:オンプレのログはJST、AWSのログはUTCで記録されている
考えるポイント:どこに集めるか(CloudWatch Logs・S3・SIEM)、転送の経路と費用、タイムゾーン。
問3 解答例と解説
| 案 | 構成 | メリット | デメリット |
|---|---|---|---|
| A | オンプレのログも CloudWatch Logs へ送り(CloudWatch エージェントや中継から)、Logs Insights でアカウントをまたいで検索する | AWS のマネージドなサービスで完結する | 取り込み量に比例して費用がかかり、オンプレの 40 GB/日も課金される。syslog の機器には中継が要る |
| B | 両方を S3 に集め(オンプレは中継から、AWS は CloudWatch Logs から)、Athena などで検索する | 保管が安く、1年分も持ちやすい | 直近の調査には遅い。形式(スキーマ)とパーティションの設計が要る |
| C | 検索基盤(OpenSearch や SIEM)を1つ決めて直近30日を入れ、生データは S3 に1年保管する(案B と組み合わせる) | 速い検索と安い保管を両立でき、相関分析もできる | 構成が大きくなり、検索基盤の容量と費用の管理が要る |
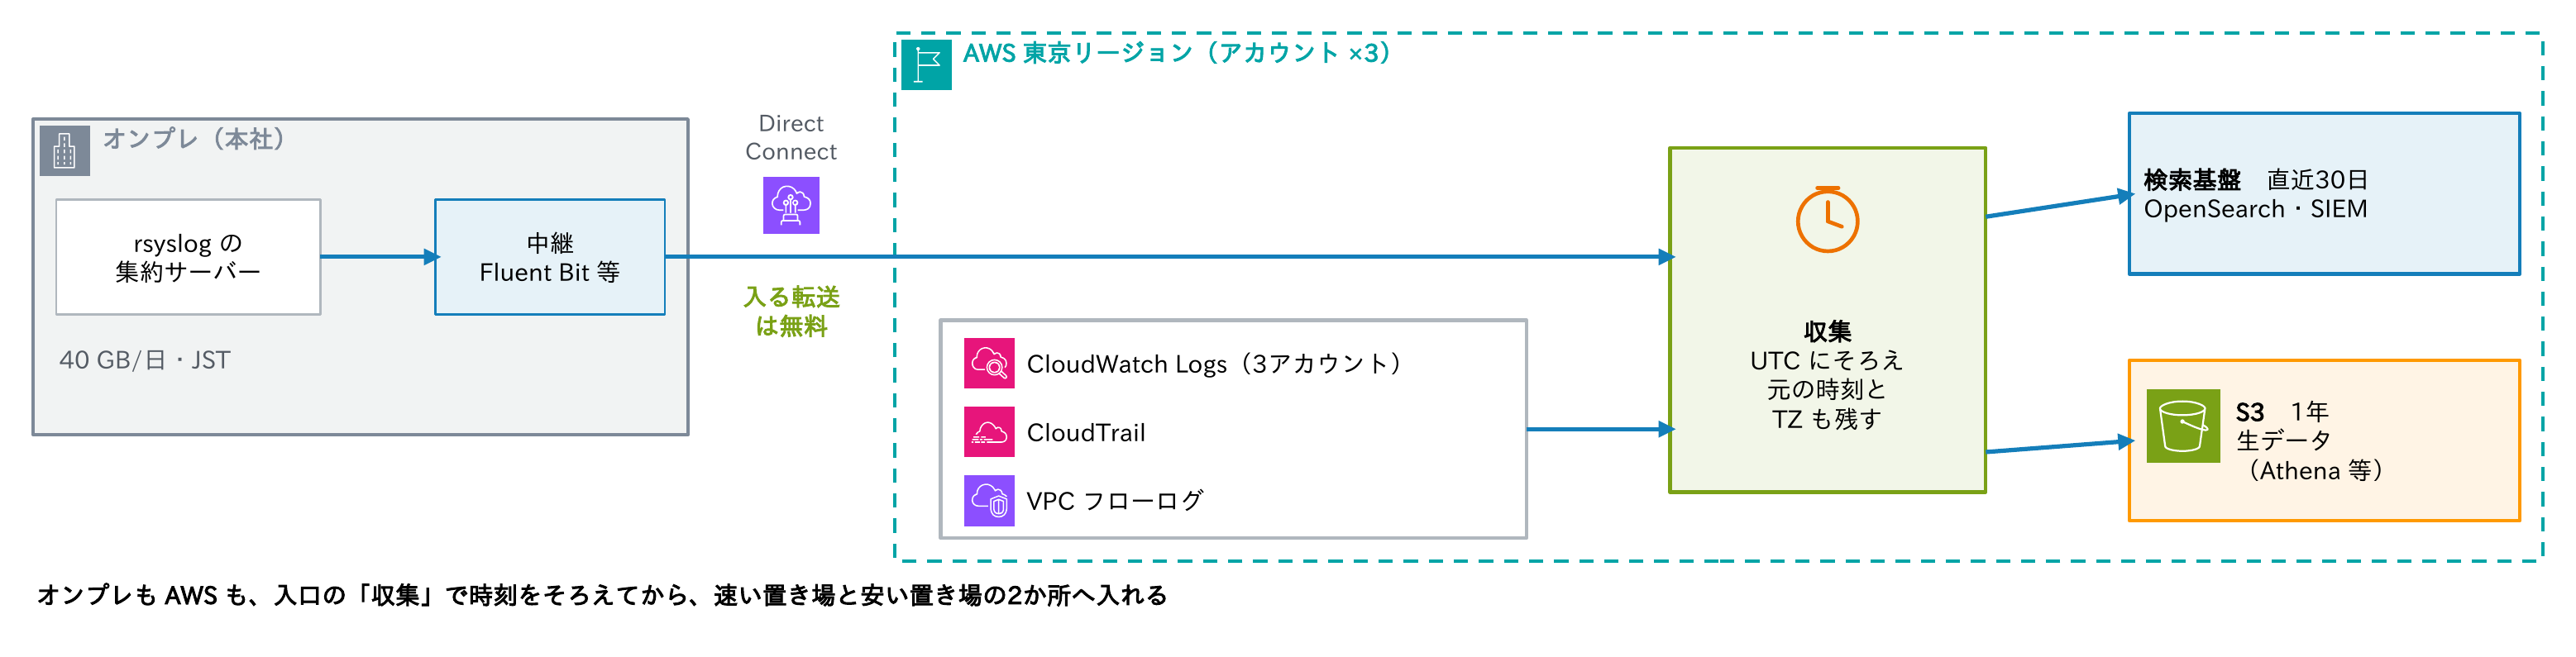
「30日は速く、1年は安く」という2段の要件から、案Cが有力です(第7回のホットとコールド)。
- AWSへ入る転送は無料で、出る転送は課金されるため、集める場所はAWS側に置くと転送の費用を抑えやすい(第9回)
- 時刻は収集のときにUTC(RFC 3339)へそろえ、元の時刻とタイムゾーンも残す(連載「NTP入門」第11回の問2)
問4 「一部の機器のログだけ届かない・ときどき抜ける」
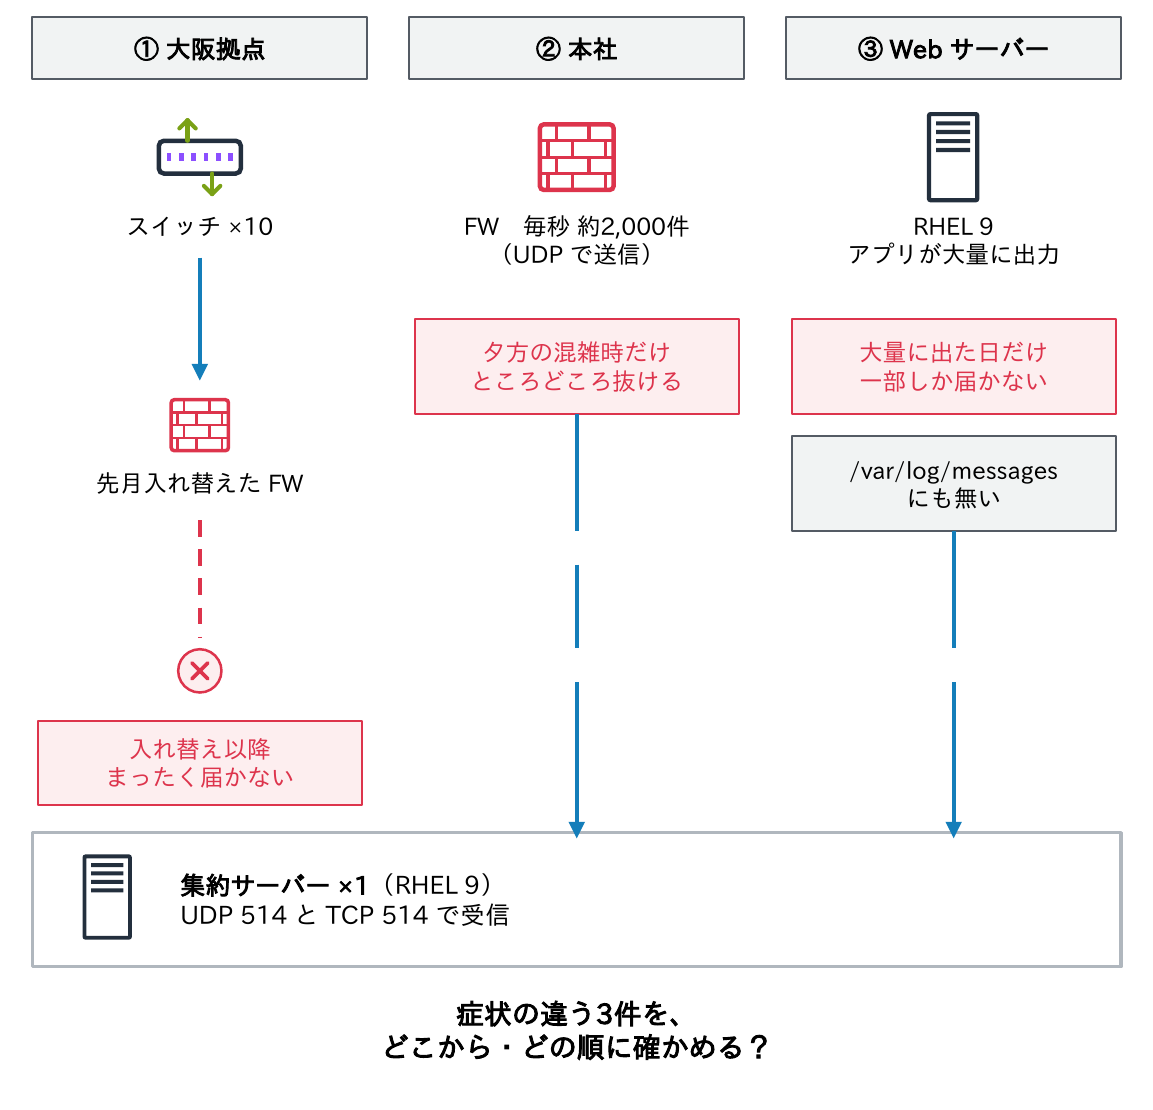
- 状況:rsyslogの集約サーバー1台(RHEL 9、UDP 514とTCP 514で受信)に、全社のログを集めている。1週間のうちに、次の3件の報告を受けた
- 報告①:先月、拠点のFWを入れ替えた大阪拠点のスイッチ10台のログが、入れ替え以降まったく届いていない
- 報告②:本社のFW(毎秒約2,000件をUDPで送信)のログが、夕方の混雑する時間帯だけ、ところどころ抜ける
- 報告③:Webサーバー(RHEL 9)のアプリが大量のログを出した日だけ、アプリのログが一部しか届かない。そのサーバーの
/var/log/messagesにも残っていない
考えるポイント:それぞれをどの順に切り分けるか、原因の候補、恒久的な対策。
問4 解答例と解説
| 案 | 対応 | メリット | デメリット |
|---|---|---|---|
| A | 集約サーバーを再起動し、性能の高いサーバーに替える | 手順が分かりやすい | 送信側や経路の原因(①・③)には効かず、原因も分からない |
| B | 報告ごとに、送信側 → 経路 → 受信側の順に確かめ(tcpdump、受信エラーのカウンター、レート制限の記録)、原因ごとに対策する | 3件の原因をそれぞれ特定でき、再発を防げる | 手間がかかり、コマンドの知識が要る |
| C | すべての送信元を TCP(または RELP)に切り替える | UDP の欠損(②)には効く | ①・③は直らない。TCP に対応しない機器もある |
$ sudo tcpdump -i any -nn 'udp port 514 and src net 198.51.100.0/24'   # ①大阪から届くか
$ nstat -az UdpRcvbufErrors ; ss -uanm 'sport = :514'                   # ②夕方に増えるか
$ grep 'rate-limiting' /var/log/messages ; journalctl -b | grep Suppressed  # ③送信元で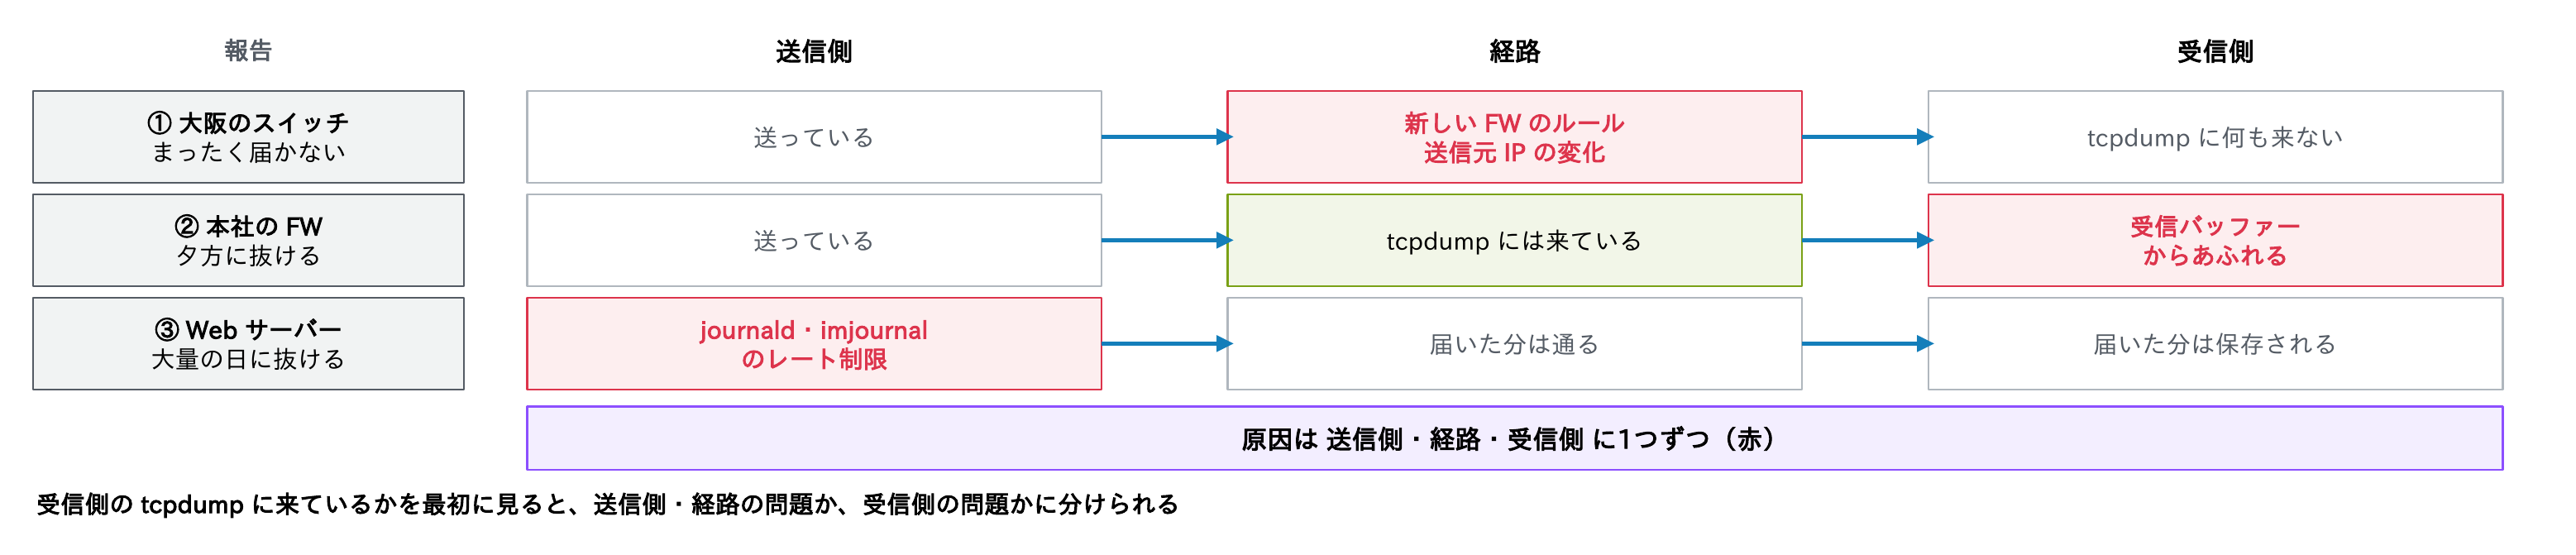
案Bです。原因は、送信側・経路・受信側に1つずつありました(第10回)。
- ①は、新しいFWのルールか送信元IPの変化(経路)。受信側のtcpdumpに何も来ない
- ②は、受信バッファーのあふれ(受信側)。RcvBufSizeの拡大、TCPへの切り替え、受信の分散で対処する
- ③は、journald・imjournalのレート制限(送信側)。上限の見直しと、出しすぎの是正で対処する
受信側のtcpdumpに来ているかを最初に見ると、送信側・経路の問題か、受信側の問題かに分けられます。「性能の高いサーバーに替える」や「全部TCPに」は、3件のうち1件にしか効きません。
振り返り
全11回を通じて、持ち帰ってほしいことは3つです。
- ログは「届いたか確かめられる形」で運ぶ。UDPは抜ける前提で、重要なログはTCPとディスクキュー、暗号化はTLS、受け取りの確認まで要るならRELP
- 時刻・形式・文字コードをそろえてから集める。全台をNTPで同期し、オフセット付きのRFC 3339(できればUTC)とUTF-8で記録する
- 容量・保存期間・改ざん防止を最初に設計する。EPS × 1件の大きさ × 日数で見積もり、検索用と保管用を分け、WORMとハッシュで証跡を守る
まずは自分のサーバーでlogger -n 集約サーバー -P 514 -T "test"を送り、受信側のtcpdumpとファイルで到着を確かめてみてください。困ったときに戻る場所は、第10回の「連載の早見表」にまとめています。時刻の合わせ方は連載「NTP入門」、TLSの証明書は連載「証明書入門」もあわせてどうぞ。
まとめ
- 設計は要件と現状の確認から。書かれていない条件は仮定を明記する
- 問1:運び方は送信元ごと(rsyslog・WEF・syslog)、そろえるのは中継から先。量は多い送信元から測る
- 問2:抜け・盗聴・改ざん・消去・時刻に、ログの一生のそれぞれの段で手当てする。「すぐ調べる」と「1年守る」は置き場所を分ける
- 問3:入口でUTCにそろえ、速い置き場(30日)と安い置き場(1年)の2か所へ
- 問4:受信側のtcpdumpで二分し、送信側・経路・受信側の原因を1つずつ直す
「syslog入門」全11回、最後までお読みいただき、ありがとうございました。
連載「syslog入門」全11回
全回の目次と、読む順番・目的別の読み方は、syslog入門の入口のページにまとめています。
コメント