「アラートが1日に数百件届くので、正直もう見ていません」
「ファイアウォールのログが3か月前から届いていなかったことに、監査で初めて気づきました」
ログは、集めただけではファイルの山です。検索できて、異常に気づけて、初めて役に立ちます。そして、気づく仕組みにも落とし穴があります。多すぎるアラートと、鳴らないアラートです。
第7回(ログ集約基盤の設計)では、集約基盤の設計を見ました。第8回では、集めたログを検索・監視して異常に気づく仕組み(検索基盤とSIEM)を扱います。
検索基盤とは
検索基盤は、ログに索引を付け、「昨日の10時台にweb01で出たERROR」「このユーザーのログオン失敗を全サーバーで」といった検索と集計を、数秒で返します。
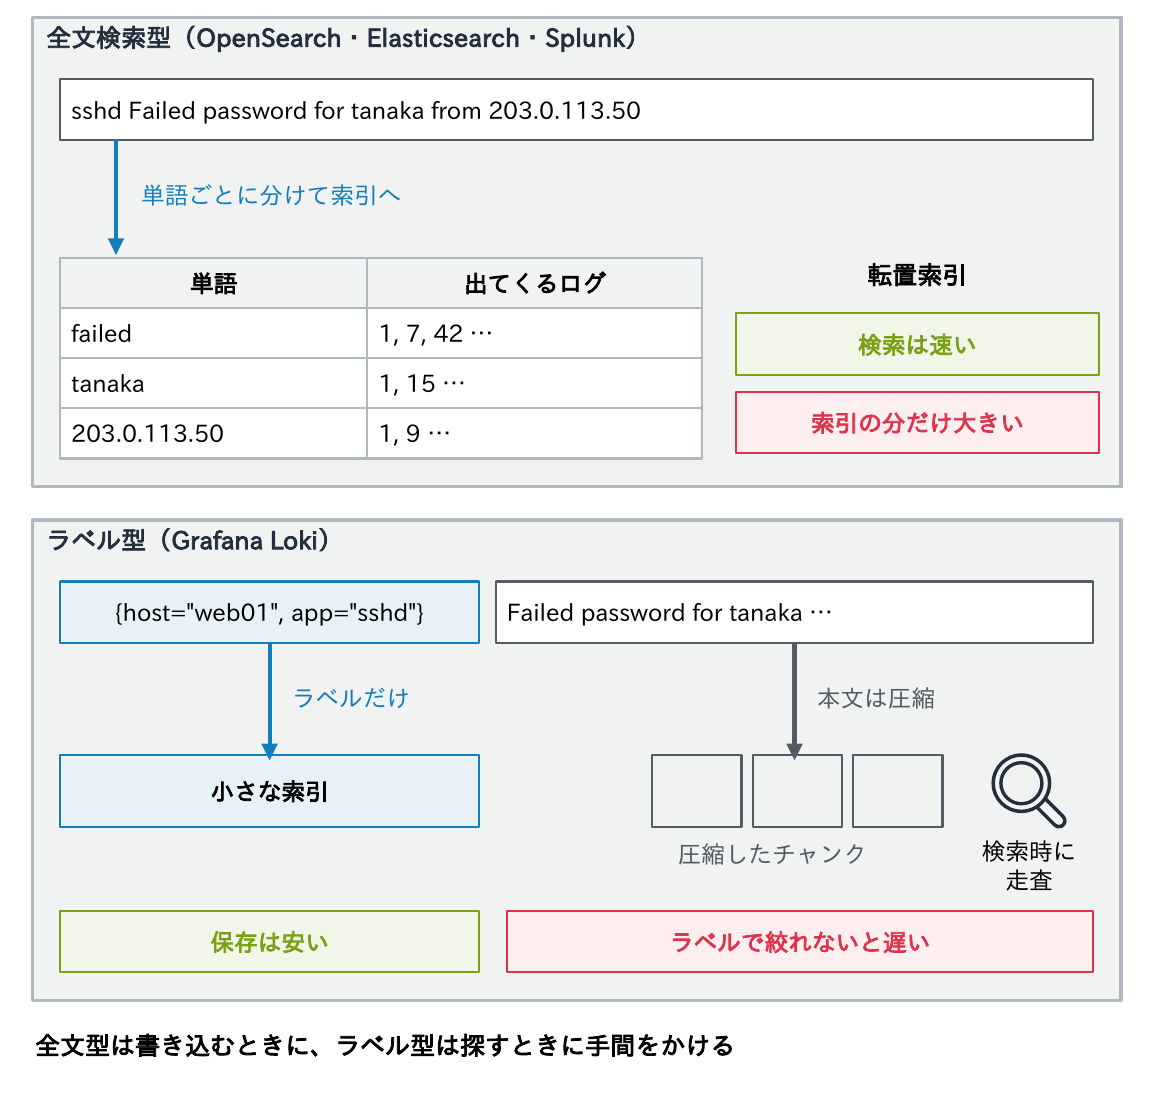
- 全文検索型(OpenSearch、Elasticsearch、Splunk):本文の単語まで索引を作る。検索は速いが、索引の分だけ容量と計算資源を使う
- ラベル型(Grafana Loki):ホスト名やアプリ名などのラベルだけに索引を作り、本文は圧縮して保存し、検索のときに走査する。保存は安い反面、ラベルで絞れない検索は遅くなる
- クラウドでは、CloudWatch LogsやLog Analyticsのように、容量や台数を管理しないサービスもある(第9回)
選ぶときは、取り込み量、検索の速さ、保持期間、運用の手間、ライセンスと費用で比べます。
検索基盤の比較
| 製品 | ライセンス・提供形態(2026年9月) | 索引・検索の方式 | 向く場面 |
|---|---|---|---|
| OpenSearch 3.x | Apache 2.0。Linux Foundation 傘下の財団が運営 | 全文索引 | 自前で持つ全文検索。AWS のマネージドもある |
| Elasticsearch 9.x | AGPLv3・SSPL・Elastic License 2.0 から選ぶ | 全文索引 | 機能の多さ。Elastic Security(SIEM) |
| Grafana Loki 3.x | AGPLv3 | ラベルだけに索引 | 大量のログを安く保存し、Grafana で見る |
| Splunk | 商用(取り込み量や処理量などで課金)。2024年に Cisco が買収 | 全文索引 | 大規模、SIEM(Enterprise Security) |
| CloudWatch Logs | AWS の従量課金サービス | 索引なしで検索時に走査(スキャン量で課金) | AWS のログ(第9回) |
| Log Analytics | Azure Monitor の従量課金サービス | 列指向で KQL で検索 | Azure のログ、Microsoft Sentinel(第9回) |
2021年にElasticがSSPLとElastic Licenseへ変えたことで、OpenSearchが分岐しました。2024年8月にElasticはAGPLv3を選択肢に加え(8.16以降)、同年9月にOpenSearchはLinux Foundation傘下の財団へ移りました。社内利用かサービス提供かで条件が変わるため、採用時に確認します。
何を監視するか
| 事象 | Linux | Windows(イベント ID) | ネットワーク機器・クラウド |
|---|---|---|---|
| ログオンの連続失敗 | sshd の Failed password、Invalid user | 4625(失敗)、4771(Kerberos 事前認証の失敗) | VPN の認証失敗、CloudTrail の ConsoleLogin の失敗 |
| アカウントの作成・ロック・削除 | useradd、faillock によるロック | 4720(作成)、4740(ロック)、4726(削除) | IAM ユーザーの作成(CreateUser) |
| 特権の使用・付与 | sudo、su | 4672(特権の割り当て)、4728・4732・4756(特権グループへの追加) | enable の失敗、ルートユーザーの使用 |
| 設定の変更 | auditd で監視するファイル(/etc/sudoers など) | 4719(監査ポリシーの変更)、5136(GPO などディレクトリーの変更) | Cisco の %SYS-5-CONFIG_I、セキュリティグループの変更 |
| サービスの停止・導入 | systemd の Stopped・Failed | 7036(状態の変化)、7045(サービスの導入) | 機器の再起動(%SYS-5-RESTART) |
| ログの停止・消去 | rsyslog・auditd の停止 | 1102(セキュリティログの消去)、1100(イベントログサービスの停止)、104(ほかのログの消去) | CloudTrail の StopLogging・DeleteTrail |
監視する事象は、「起きたら誰かが動くか」で選びます。Windowsのイベントは、監査ポリシーを有効にしていないと記録されません(第6回)。最後の行の「ログの停止」は見落とされがちですが、攻撃者が最初に行う操作の1つです。
アラートの設計
冒頭の「1日に数百件で、もう見ていない」への答えです。
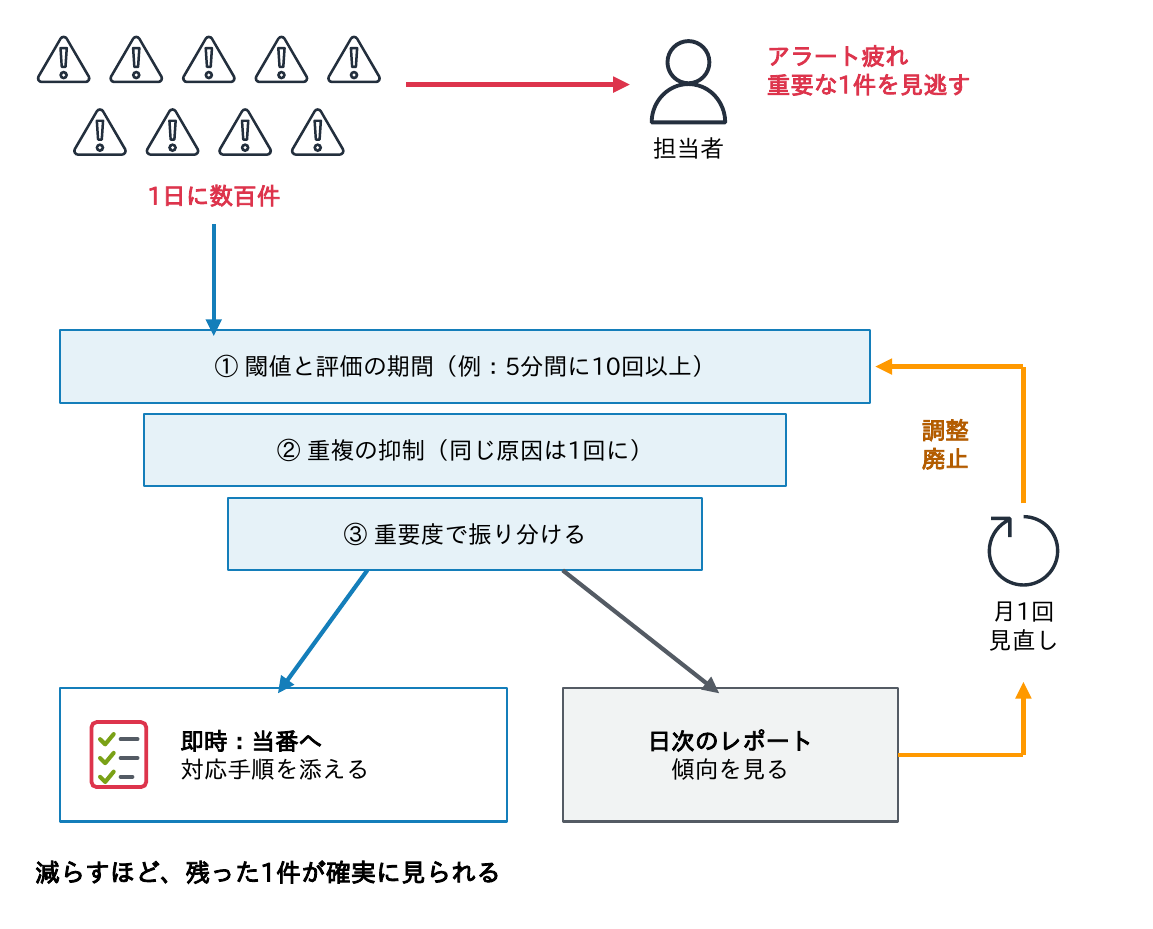
- アラートは多ければ安心というものではない。1日に数百件の通知が届くと、担当者は見なくなり、本当に重要な1件を見逃す。これをアラート疲れと呼び、監視で最も多い失敗(連載「クラウド入門」第11回)
- 閾値と評価の期間:「ログオン失敗が1回」ではなく「同じアカウントに5分間で10回以上」のように、平常時の値を調べたうえで異常と言える線を引く
- 重複の抑制:同じ原因の通知は一定時間まとめ、復旧時に1回知らせる
- 重要度で通知先を分ける:すぐ動く必要があるものだけを当番へ即時に送り、傾向を見ればよいものは日次のレポートにする
- 1つのアラートごとに、「受け取った人が何をするか」を対応手順(ランブック)として書く。手順を書けないアラートは作らない
- 月に1回程度、誤報の割合と実際に対応した割合を見直し、閾値を調整したり廃止したりする
アラートの定義の例
| 項目 | 例①ログオンの連続失敗 | 例②ログの途絶 |
|---|---|---|
| 条件 | 同じアカウントへの失敗(4625、sshd)が5分間に10回以上 | ある送信元からのログが30分間1件もない |
| 重要度・通知先 | 中:運用チームのチャットのチャンネル | 高:当番へ電話とチャット |
| 重複の抑制 | 同じアカウントは1時間に1回まで | 復旧するまで1回。復旧時にも1回 |
| 除外 | 監視用のアカウント、既知の脆弱性検査の送信元 | 計画停止中の機器(保守の予定と連動) |
| 対応手順 | 送信元 IP を確認→本人に確認→必要ならロック・遮断 | 機器の稼働→経路→受信側の順に確認(第10回) |
| 見直し | 月1回、誤報の割合を確認 | 保守の予定の登録漏れを確認 |
アラートは表のような定義書にして、基盤の設定と一緒に管理します。条件だけでなく、除外と対応手順まで書いておくと、担当者が替わっても同じ判断ができます。
SIEMの役割
SIEM(Security Information and Event Management)は、検索基盤にセキュリティのための機能を加えたものです。
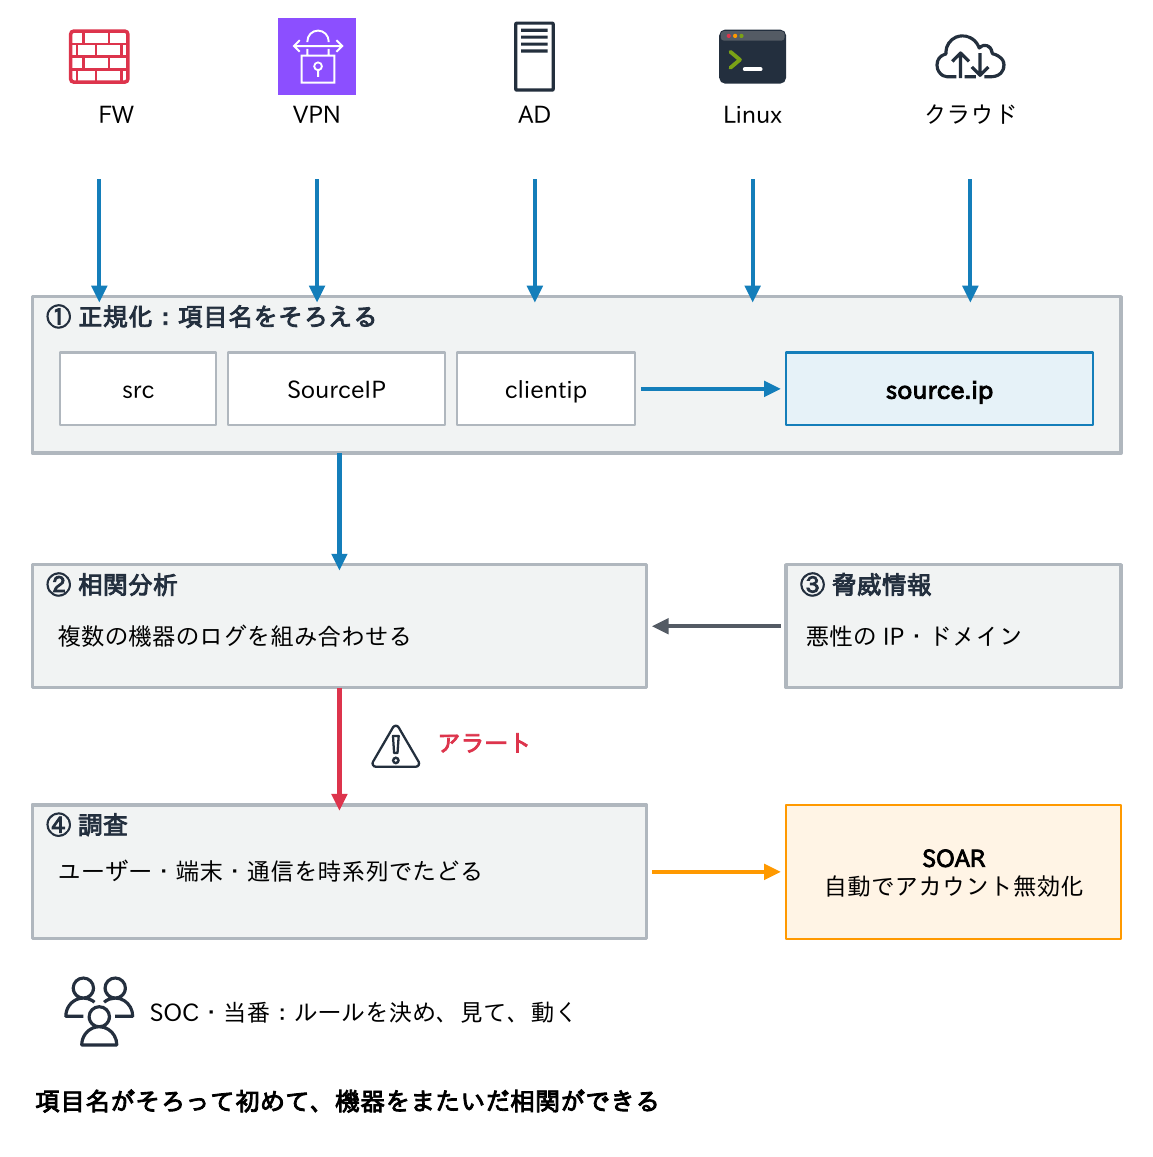
- 正規化:製品ごとにばらばらな項目名(src、SourceIP、clientipなど)を、共通のスキーマにそろえる
- 相関分析:複数の機器のログを組み合わせ、単独では平凡な出来事の中から攻撃の流れを見つける
- 脅威情報との照合:既知の悪性のIPアドレスやドメインとの通信を見つける
- 調査:アラートを起点に、関係するユーザー、端末、通信を時系列でたどる
ただし、SIEMは導入するだけでは働きません。どのログを入れ、どのルールで検知し、誰がいつ見るか(SOCなどの体制)まで決めて初めて役に立ちます。
SIEMの主な製品と正規化のスキーマ
| 製品 | 提供形態 | 正規化のスキーマ | 備考 |
|---|---|---|---|
| Microsoft Sentinel | Azure のサービス | ASIM(Advanced Security Information Model) | Defender ポータルへ移行中(Azure ポータル版は2027年3月末で終了) |
| Splunk Enterprise Security | 製品・クラウド | CIM(Common Information Model) | 2024年から Cisco の傘下 |
| Elastic Security | 製品・クラウド | ECS(Elastic Common Schema) | ECS は OpenTelemetry の規約へ統合が進行中 |
| Google Security Operations | クラウド(旧 Chronicle) | UDM(Unified Data Model) | SIEM と SOAR を統合 |
| Wazuh | オープンソース(GPLv2) | デコーダーで項目を取り出す独自の形式 | エージェント型。ホストの改ざん検知なども |
| Amazon Security Lake | AWS のサービス(保管) | OCSF | SIEM ではなくセキュリティのデータレイク。SIEM へ渡す |
検知のルールを特定の製品に依存しない形で書くSigma(YAMLの汎用ルール形式)もあり、各製品のクエリーに変換して使えます。製品を選ぶときは、取り込み量に応じた費用、既存のログ基盤との関係、運用する人の体制を合わせて比べます。
相関分析の例:VPNとAD
2026-09-26T01:02:03Z vpn01 auth: user=tanaka src=203.0.113.50 country=XX assigned=192.0.2.23 result=success
2026-09-26T01:05:10Z dc01 EventID=4771 TargetUserName=tanaka IpAddress=192.0.2.23 Status=0x18
2026-09-26T01:05:12Z dc01 EventID=4625 TargetUserName=administrator IpAddress=192.0.2.23
2026-09-26T01:05:14Z dc01 EventID=4625 TargetUserName=svc-backup IpAddress=192.0.2.23
(以下、同じ送信元から多数のアカウントへの失敗が続く)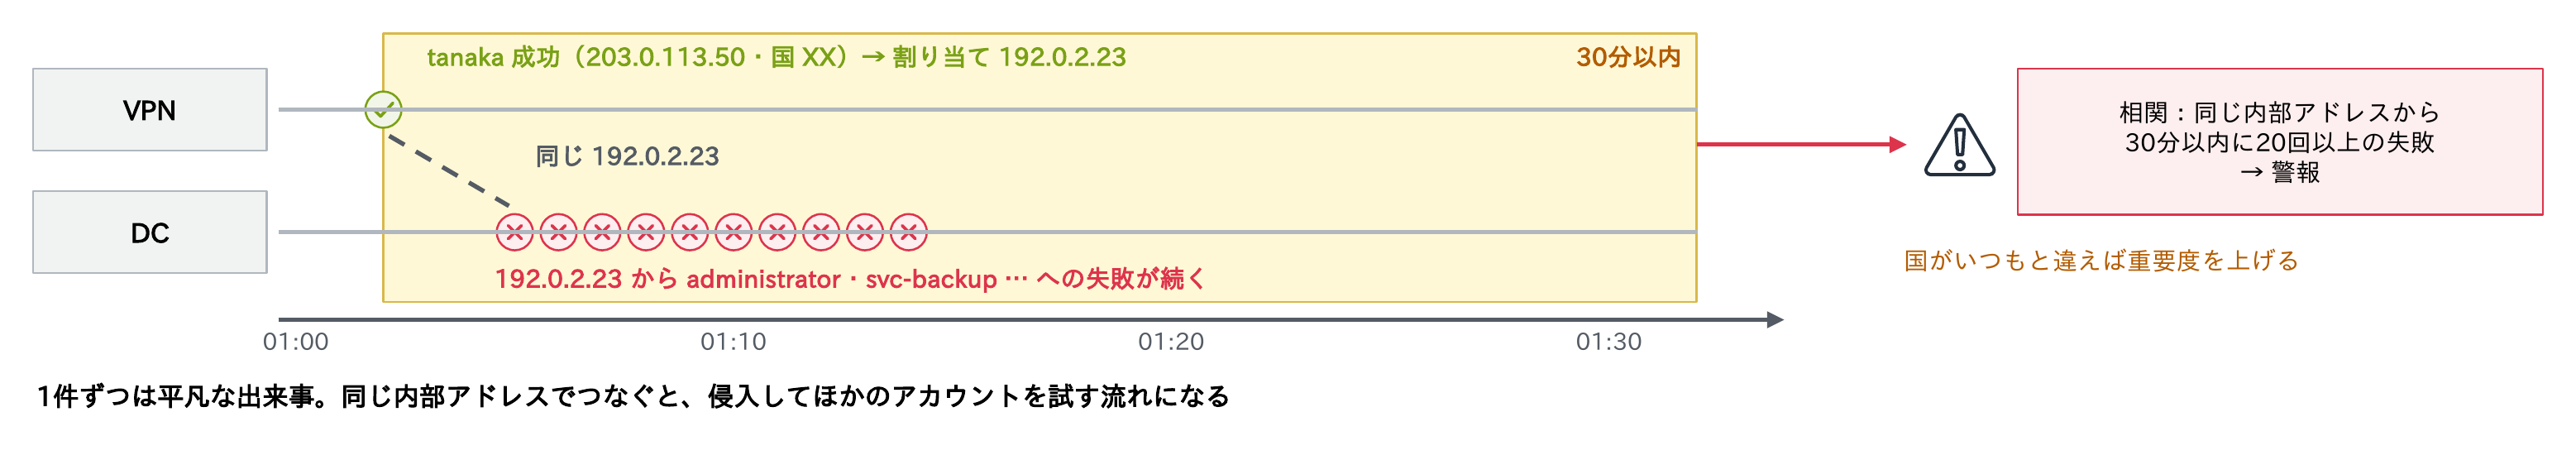
- VPNの認証成功を記録する(送信元IP、国、VPNが割り当てた内部アドレス)
- 30分以内に、①の内部アドレスからDCへのログオン失敗(4625・4771)が、複数のアカウントに対して20回以上あれば検知する。①も②も単独ではよくある出来事で、組み合わせると「盗まれた認証情報で侵入し、ほかのアカウントを試している」疑いになる
- ①の国が普段と違う、同じユーザーが別の場所から同時にログインしている、などが重なれば重要度を上げる
前提は、時刻がそろい(第7回)、ユーザー名とIPの表記がそろっていること。tanaka、CORP\tanaka、tanaka@corp.example.jpを、正規化で1つにします。
ダッシュボード
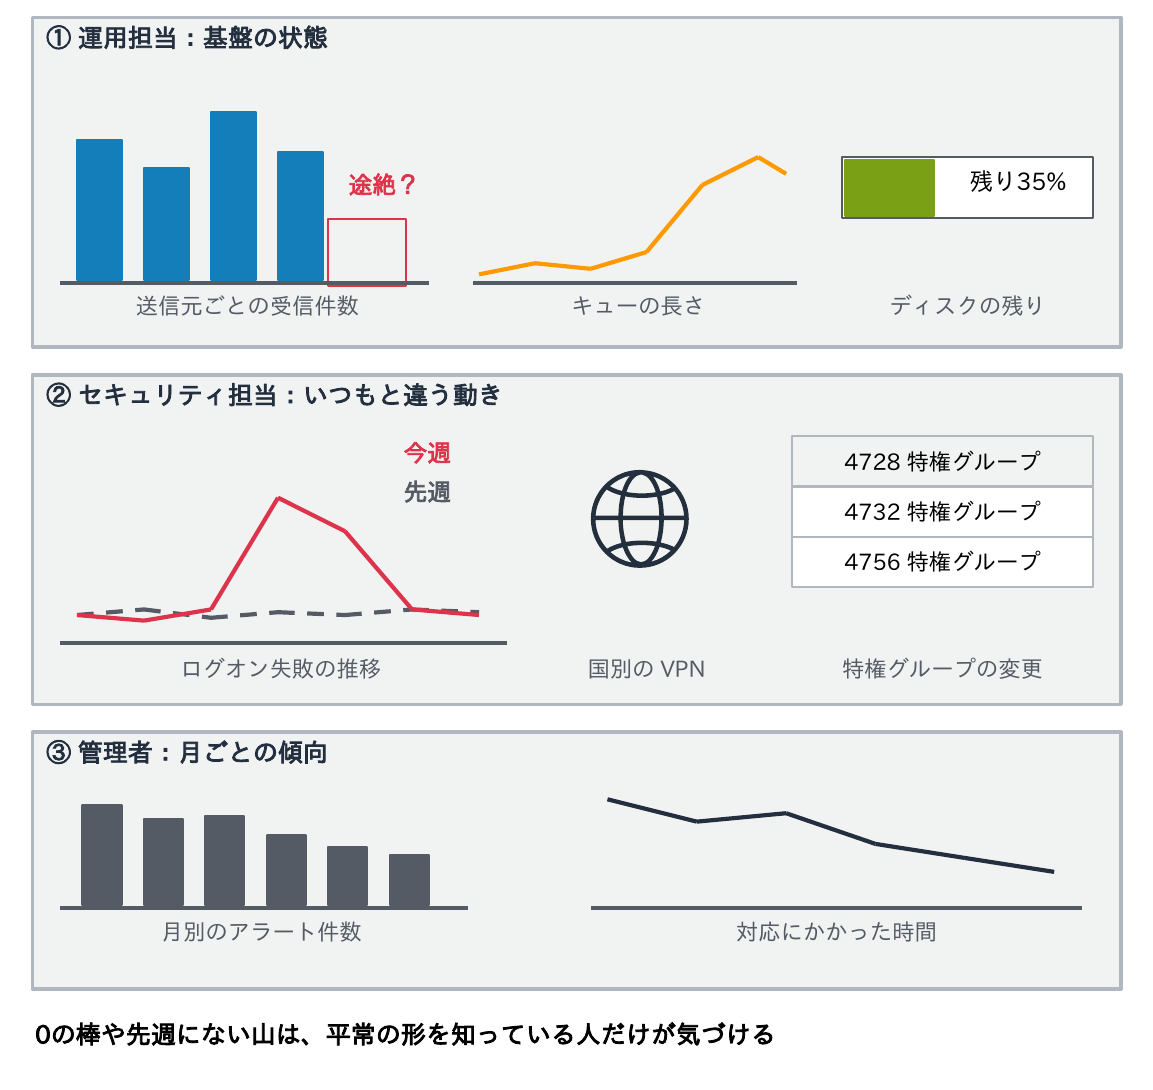
- ダッシュボードは、見る人と目的ごとに分けて作る
- 運用担当向け:基盤の状態。送信元ごとの受信件数、エラーの件数、キューの長さやディスクの残り
- セキュリティ担当向け:いつもと違う動き。ログオン失敗の推移、国別のVPN接続、特権グループの変更、アラートの件数と対応状況
- 管理者向け:傾向。月ごとの件数や対応時間の推移
- 大切なのは平常時の形を知っておくこと。数字の絶対値よりも、前日や前週の同じ時間帯との比較のほうが、変化に気づきやすい
- 大きな画面に映して眺めるだけでなく、アラートから関係するグラフや検索画面へすぐ飛べる、調査の入口として設計すると役に立つ
- 道具には、OpenSearch Dashboards、Kibana、Grafana、CloudWatchのダッシュボード、Sentinelのブックなどがある
ログが来なくなったことを検知する
冒頭の「3か月前から届いていなかった」は、最も気づきにくい障害です。
# Linux:5分ごとにハートビートを送る(/etc/cron.d/log-heartbeat)
*/5 * * * * root /usr/bin/logger -p local0.info -t heartbeat "alive"
# Windows:アプリケーションログに書く(タスクスケジューラで5分ごとに実行)
PS> eventcreate /T INFORMATION /ID 900 /L APPLICATION /SO Heartbeat /D "alive"
# rsyslog:60秒ごとにキューの長さや破棄した件数を記録する
module(load="impstats" interval="60" format="json" log.file="/var/log/rsyslog-stats.log")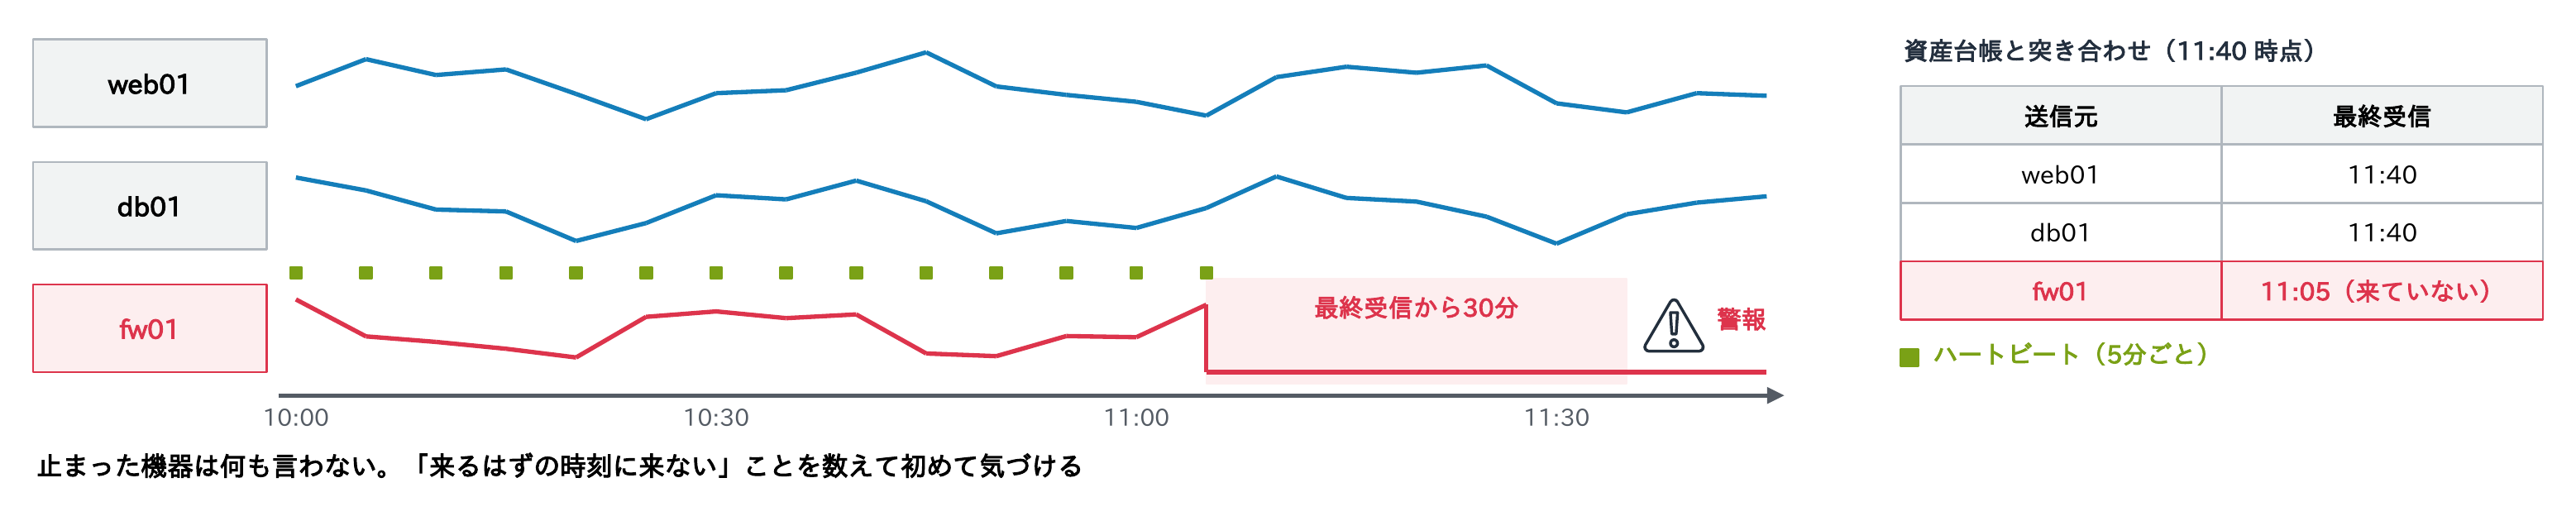
- ログの途絶は、警報が鳴らない障害。機器の故障、設定の誤り、ディスクの枯渇でも、攻撃者がログを止めた場合でも、「何も起きていない」ように見える
- 送信元ごとに最後に受け取った時刻を記録し、資産台帳と突き合わせて「来るはずなのに来ていない」送信元を検知する(アラートの定義の例②)。ハートビートがあれば、平常時にログが少ない機器でも判断できる
- 件数の急減(前週の同じ時間帯の半分未満など)も検知する。完全には止まらず、一部だけ欠ける場合に効く。クラウドでは、CloudWatch LogsのメトリクスIncomingLogEventsにアラームを設定し、データが来ないときも異常として扱う
止まった機器は、何も言いません。「来るはずの時刻に来ない」ことを数えて、初めて気づけるのです。
考えてみよう
- 今の職場で、アカウントがロックされたり、特権グループに人が追加されたりしたとき、誰が何分後に気づきますか。
- 毎日届くアラートのうち、実際に対応したものは何割ですか。減らしてよいアラートと、足りないアラートはどれですか。
- ある機器のログが今日から止まったとしたら、何日後に気づきますか。気づくための仕組みを1つ提案してください。
ヒント:この記事の監視する事象の表、アラートの設計と定義の例、途絶の検知が手がかりです。
まとめ
- 検索基盤は全文検索型(速いが大きい)とラベル型(安いが絞り込みが要る)。量・速さ・期間・運用・費用で選ぶ
- 監視する事象は「起きたら誰かが動くか」で選ぶ。ログの停止・消去も必ず入れる
- アラートは閾値・期間・重複の抑制・重要度で絞り、対応手順の無いアラートは作らない
- SIEMは正規化・相関・脅威情報・調査。体制まで決めて初めて働く
- 相関分析の前提は、時刻と表記がそろっていること
- ダッシュボードは見る人ごとに。平常の形を知り、調査の入口にする
- ログの途絶は、最終受信時刻・資産台帳・ハートビートで検知する
次回は、AWS・Azureのクラウドのログサービスと、オンプレのログとの一元化を扱います。
連載「syslog入門」全11回
全回の目次と、読む順番・目的別の読み方は、syslog入門の入口のページにまとめています。
コメント