「で、うちの会社の時刻同期は、結局どう組めばいいんですか?」
仕組みや設定を学んだ後に出てくるのが、この問いです。時刻同期の設計にも、正解は1つではありません。拠点の数、インターネットの出口、クラウドの有無、求められる精度……どの要件を重く見るかで、選ぶ案が変わります。
連載の最終回となる第11回では、第1回〜第10回の知識を使って、4つの設計演習に取り組みます。答えを覚えるのではなく、要件から案を選ぶ筋道を身に付けましょう。
演習の進め方
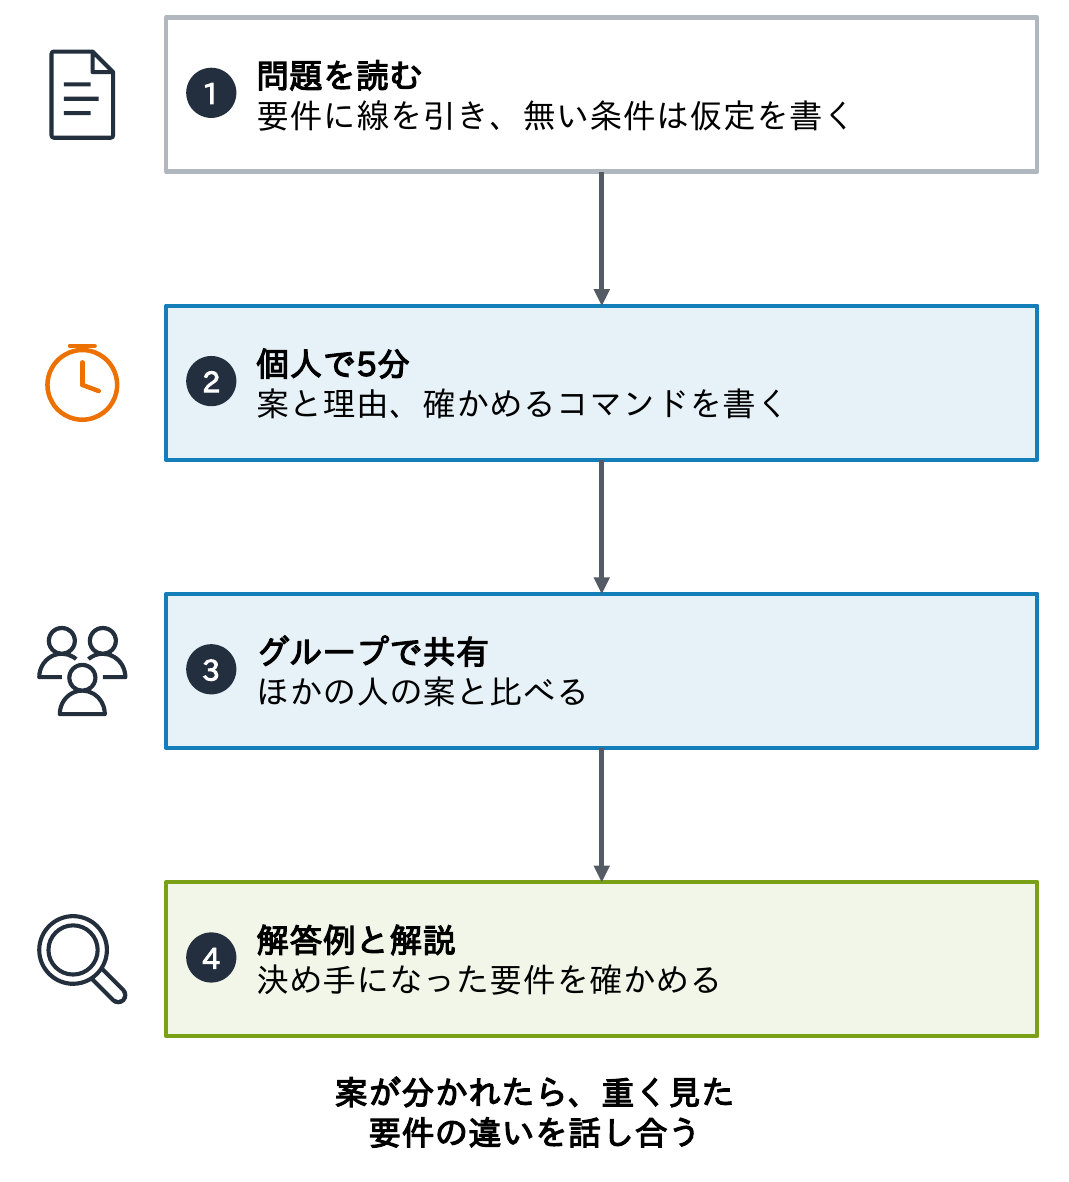
- 各問は「問題 → 解答例 → 解説」の順に進みます
- まず5分考え、選ぶ案と、その理由を書き出します。可能なら、
chronyc・w32tmで確かめる手順も書きます - 最初にすべきことは、要件と現状の確認です。問題文に書かれていない条件(予算、体制、将来の拡張)は、どう仮定したかを明記します
案が分かれたら、重く見た要件の違いを比べてみてください。
問1 拠点が3つある会社の時刻同期の階層を設計する
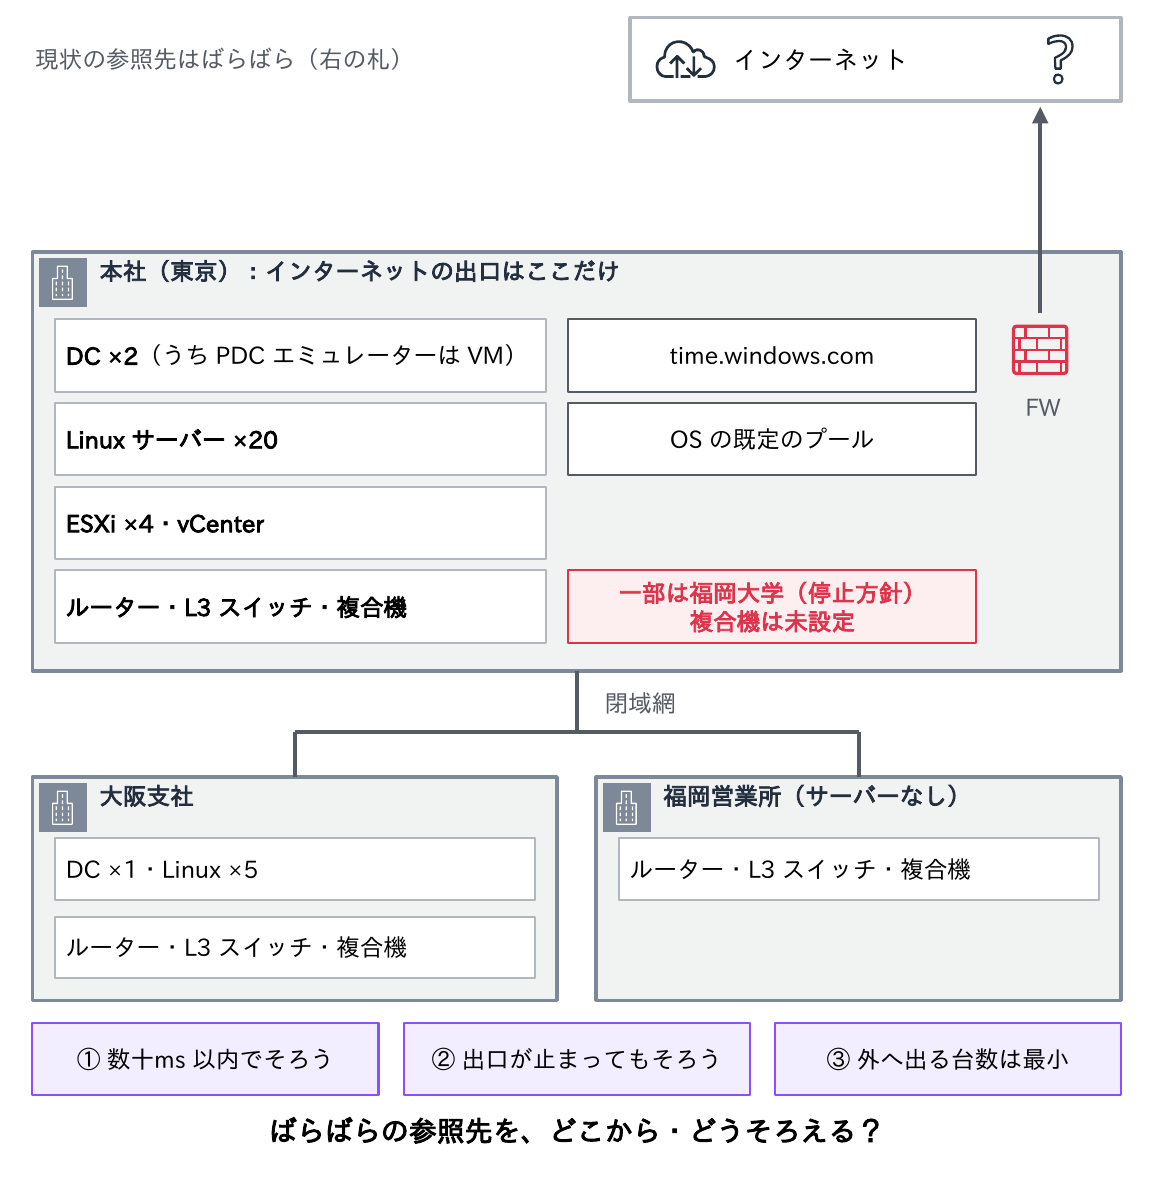
- 状況:従業員500名の会社で、本社(東京)・大阪支社・福岡営業所を閉域網でつないでいる。インターネットの出口は本社だけ
- 機器:本社にDC 2台(うち1台がフォレストルートのPDCエミュレーター、VM)、Linuxサーバー20台、vSphere(ESXi 4台とvCenter)。大阪にDC 1台とLinuxサーバー5台。福岡はサーバーなし。各拠点にルーター・L3スイッチ・複合機、本社にファイアウォール
- 現状:参照先がばらばら。PDCは
time.windows.com、LinuxはOSの既定のプール、ネットワーク機器の一部は停止の方針が出ている福岡大学の公開NTPのまま、複合機は未設定 - 要件:全社の時刻を数十ミリ秒以内でそろえ、インターネットの出口が止まっても社内の時刻はそろったままにする。出口のファイアウォールでNTPを通すサーバーは最小限にする
考えるポイント:外部の時刻源の選び方と数、社内のNTPサーバーの台数と置き場所、PDCエミュレーターとの関係、機器の参照先。
問1 解答例
| 案 | 構成 | メリット | デメリット |
|---|---|---|---|
| A | すべての機器がインターネットの公開 NTP を直接参照する(福岡・大阪も本社の出口を通る) | 社内にサーバーが要らない | 出口で多くの機器に UDP 123 を開ける。出口が止まると機器ごとにずれていく。参照先が機器ごとにばらつく |
| B | 本社に社内 NTP サーバー(chrony)を2台置き、独立した外部の時刻源4つ以上を参照する。PDC は社内 NTP を参照し、ほかの Windows はドメイン階層、Linux・ESXi・vCenter・ネットワーク機器・複合機は社内 NTP を参照する | 外へ出るのは2台だけ。全社の時刻の元が1つになる。費用が小さい | 本社の2台に全社が依存する。出口が止まると、社内はそろったまま UTC から少しずつずれる |
| C | 案B に加え、大阪にも社内 NTP を1台置き(計3台で互いに比べる)、本社に GNSS 受信機付きの時刻サーバー(stratum 1)を置く | 出口が止まっても UTC にそろう。3台以上で多数決が効き、拠点の障害にも強い | GNSS のアンテナの設置と機器の費用、運用が増える |
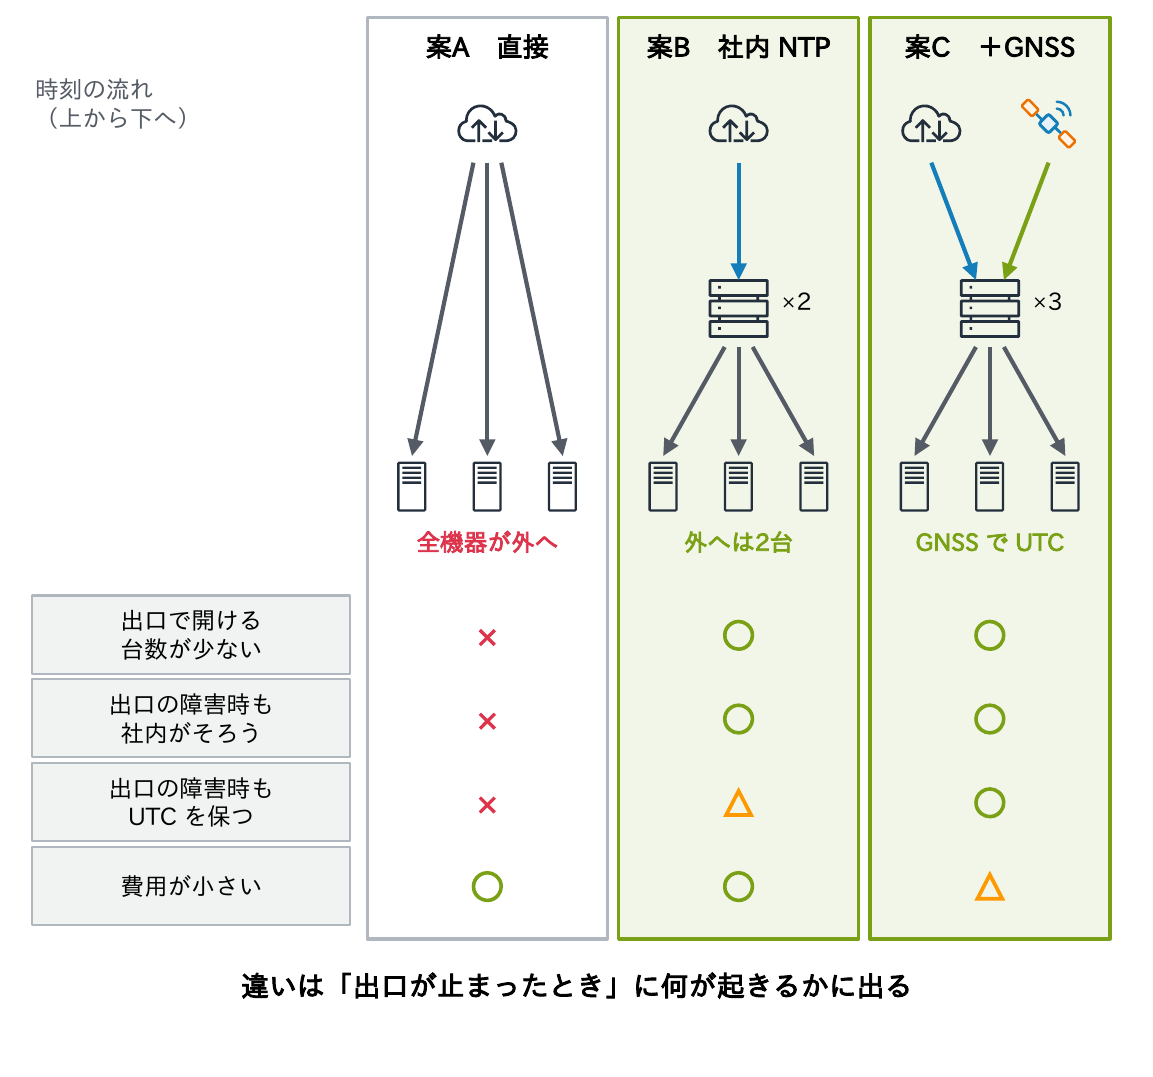
案Bが基本で、出口の障害でもUTCを保ちたい、または精度を示す必要がある場合に案Cを選びます。どの案でも、ADの時刻の元はPDCエミュレーター1台だけにし、ほかのDCに個別の参照先を設定しません(第5回)。
問1 解説:時刻の階層
| 階層 | 機器 | 参照先 | 注意 |
|---|---|---|---|
| 外部 | 公開の時刻源 | NICT(ntp.nict.jp)、jp.pool.ntp.org、NTS に対応した公開サーバーなど、運用者の違う4つ以上 | リープスメアをするサーバー(time.google.com・time.aws.com)を混ぜない |
| 社内 NTP | 本社 chrony 2台(案C は大阪1台と GNSS を追加) | 外部4つ以上と、社内 NTP どうし | allow で社内だけに応答。ntp.corp.example.jp のような名前で配る |
| AD の頂点 | フォレストルートの PDC エミュレーター | 社内 NTP(w32tm /config /manualpeerlist:… /syncfromflags:manual /reliable:yes /update) | VM ならホストからの時刻同期を止める。PDC を移したら設定も移す |
| AD | ほかの DC、ドメイン参加の Windows | ドメイン階層(NT5DS) | 個別に参照先を設定しない |
| サーバー・基盤 | Linux、ESXi、vCenter | 社内 NTP 2〜3台 | 近い拠点の NTP を先に書く |
| 機器 | ルーター、L3 スイッチ、ファイアウォール、複合機 | 社内 NTP(1台しか書けない機器は名前で指定) | 福岡大学などの古い参照先を棚卸しして消す |
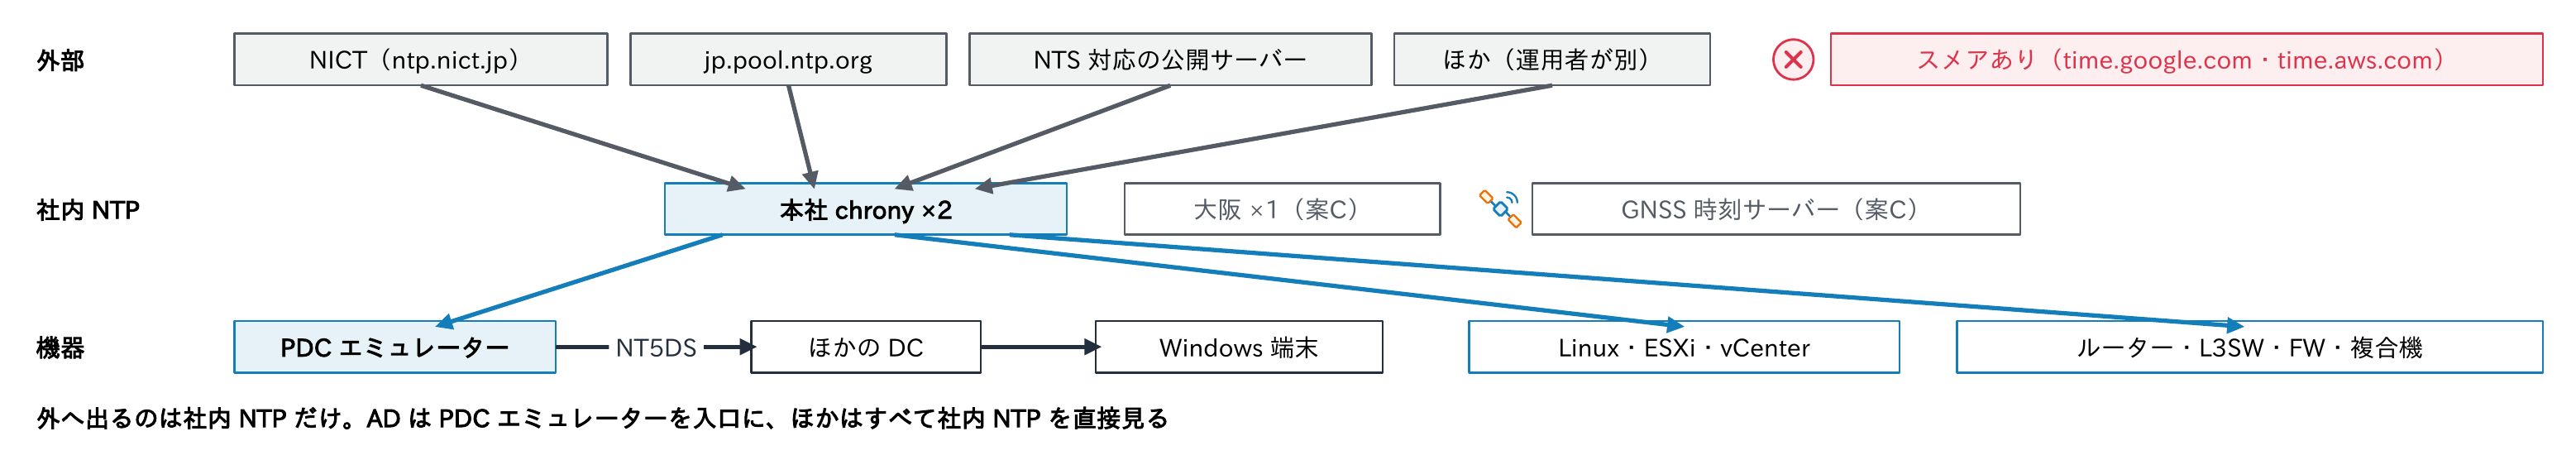
外部を4つ以上にするのは、1つが誤っても多数決で外せるようにするためです(RFC 8633。第3回・第7回)。実際にNICTの公開NTPも、2026年9月9日に誤った時刻を10分あまり配信しました。ネットワーク機器やLinuxを、DCではなく社内NTPに向けると、ADの更新作業やDCの再起動の影響を受けずに済みます。
問2 オンプレとAWSのログの時刻をそろえる
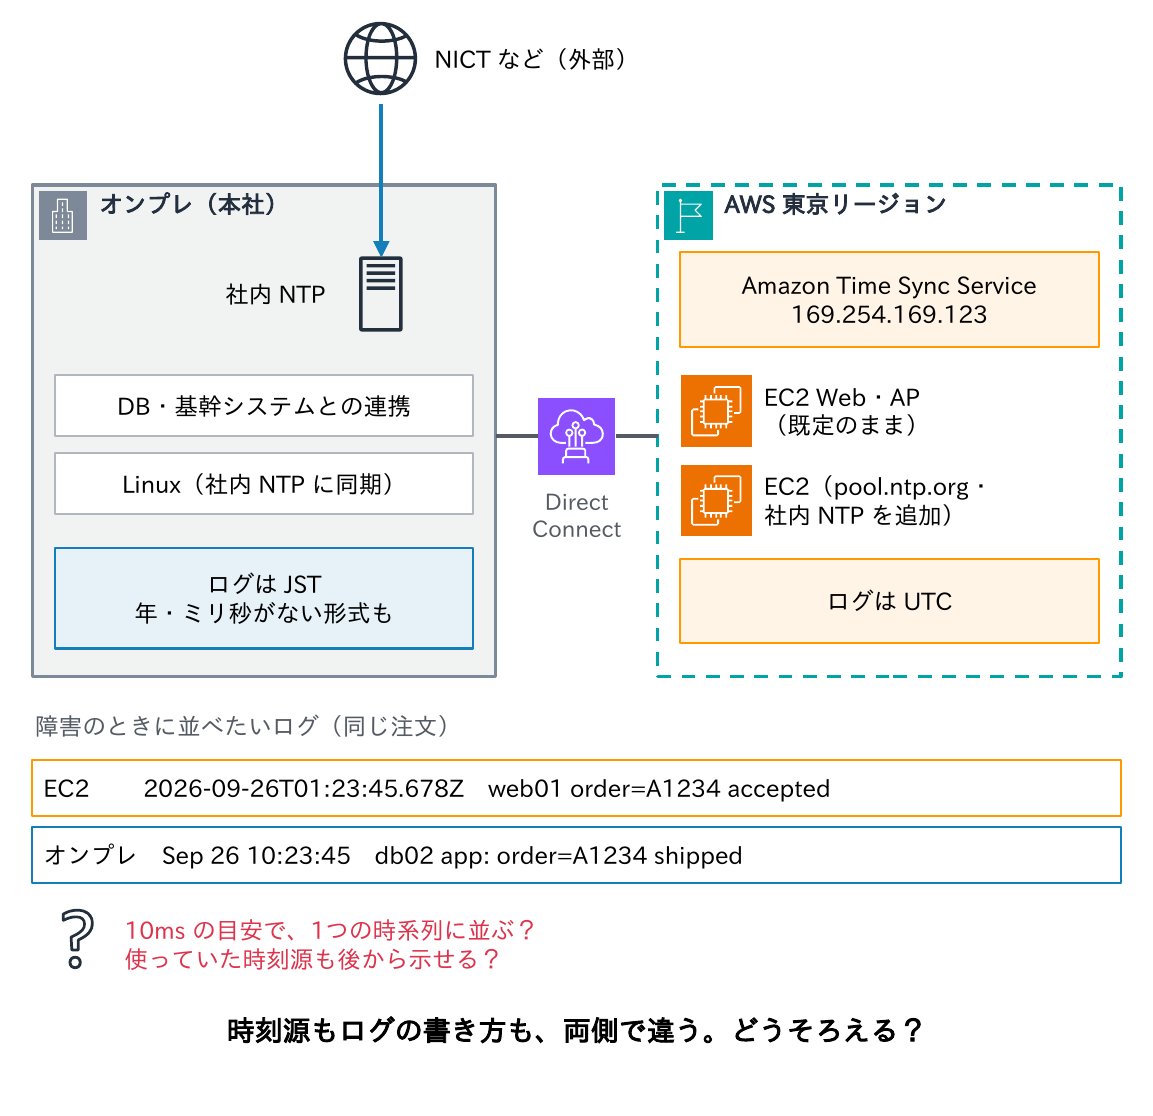
- 状況:受注システムのWeb・APサーバーはAWSの東京リージョン(EC2のLinux)、DBと基幹システムとの連携はオンプレの本社にあり、Direct Connectで接続している
- 現状①:EC2はAL2023の既定(Amazon Time Sync Serviceの
169.254.169.123)に、担当者がpool.ntp.orgと社内NTPを追加した台と、していない台が混在している - 現状②:オンプレのLinuxは社内NTP(NICTなどを参照)に合わせている。ログはEC2がUTC、オンプレがJSTで、年やミリ秒がない形式もある
- 要件:障害のとき、両方のログを1つの時系列に並べ、1件の注文の流れを追えるようにする(目安は10ミリ秒以内)。どの時刻源を使っていたかも後から示せるようにする
考えるポイント:EC2とオンプレがそれぞれ何を参照するか、リープスメアの混在、ログの時刻の記録形式。
問2 解答例と解説
| 案 | 構成 | メリット | デメリット |
|---|---|---|---|
| A | EC2 も Direct Connect 経由で社内 NTP だけを参照する | 時刻の元が1つになる | 回線の遅延と非対称で EC2 の精度が落ちる。回線が切れると AWS 側がずれていく |
| B | EC2 は Amazon Time Sync Service だけ、オンプレは社内 NTP だけを参照し、1台の設定にスメアありとなしを混ぜない。ログはすべて UTC(ミリ秒、オフセット付き)で記録する | それぞれの場所で最も精度が高い。回線の障害に強い | うるう秒の日だけ、両者に最大約0.5秒の差が出る |
| C | 案B に加え、社内 NTP の上位もスメアありの時刻源(time.aws.com など)にそろえる | うるう秒の日も両者がそろう | 外部の時刻源をすべてスメアありにする必要があり、独立した4つをそろえにくい |
2026-09-26T01:23:45.678Z web01 order=A1234 accepted            # EC2(UTC)
2026-09-26T10:23:45.702+09:00 db01 order=A1234 committed       # オンプレ(JST、オフセット付き)
Sep 26 10:23:45 db02 app: order=A1234 shipped                  # 年・ミリ秒・タイムゾーンがない(避ける)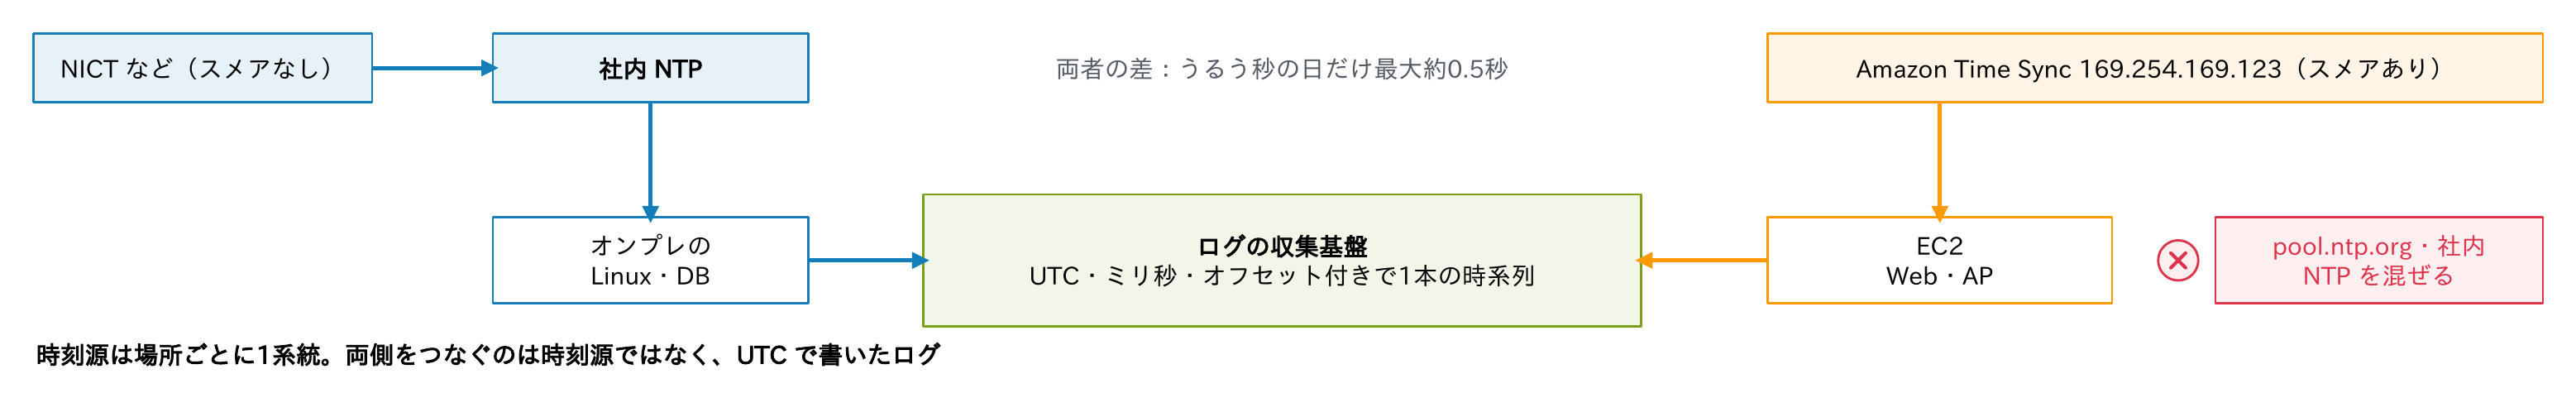
案Bが有力です。AWSも、うるう秒のときにスメアありとなしを同じ設定に混ぜないよう勧めています(第7回)。うるう秒は2026年12月末も挿入されず(IERS Bulletin C 72)、2027年5月20日から連続したUTCに移ることが決まっています(第2回)。EC2の設定を統一し、chronyc sourcesを定期的に記録して、使っていた時刻源を示せるようにします。
時刻源は場所ごとに1系統。両側をつなぐのは時刻源ではなく、UTCで書いたログです。
問3 「ときどきKerberos認証に失敗し、ログの時刻もずれている」
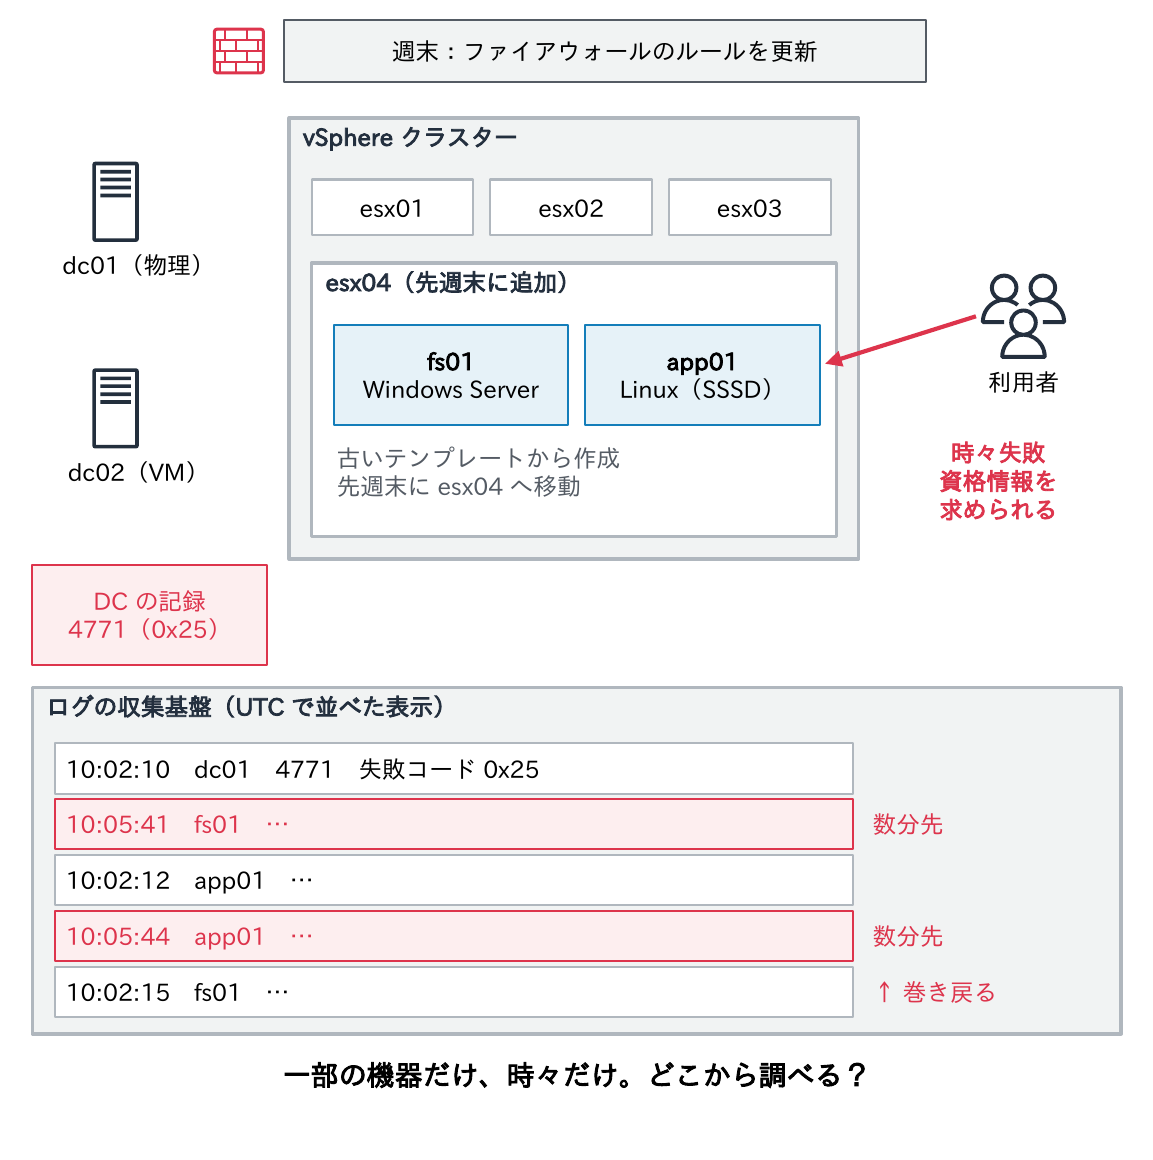
- 状況:月曜の朝から「ファイルサーバーfs01に時々つながらず、資格情報を求められる」「業務アプリapp01のログインが時々失敗する」と報告が続いている
- 記録:DCのセキュリティログに4771(失敗コード0x25)が散発している。ログの収集基盤で見ると、fs01とapp01のログだけ時刻が数分ずれ、ときどき巻き戻っている
- 構成:DCは2台(物理1台、VM 1台)。fs01(Windows Server)とapp01(Linux、SSSDでAD認証)はvSphereのVMで、古いテンプレートから作った。先週末にESXiホストesx04を追加し、fs01とapp01をesx04へ移した
- 同じ週末に、サーバーのセグメントのファイアウォールのルールも更新している
考えるポイント:どの順に何を確かめるか、考えられる原因、直し方と再発の防止。
問3 解答例と解説
| 案 | 対応 | メリット | デメリット |
|---|---|---|---|
| A | Kerberos の許容範囲を5分から10分に広げる | すぐに失敗が減る | 原因が残り、ずれが広がれば再発する。リプレイ攻撃への耐性も下がる |
| B | fs01 で w32tm /resync を実行し、w32time を再起動する | すぐに試せる | 数分後にまたずれる。app01 も直らない |
| C | 共通点(esx04 上の VM)から、同期の状態 → 誰が時計を動かしたか → ホストの順に確かめ、原因を直す | 原因を特定し、再発を防げる | 手間と、vSphere・Windows・Linux の知識が要る |
PS> w32tm /stripchart /computer:dc01.corp.example.jp /samples:4 /dataonly
10:02:11, +00.0012034s
10:02:13, -359.8420961s                         # fs01 が約6分進んだ
PS> & "C:\Program Files\VMware\VMware Tools\VMwareToolboxCmd.exe" timesync status
Enabled
$ journalctl -u chronyd | grep 'time jump'          # app01
... Forward time jump detected!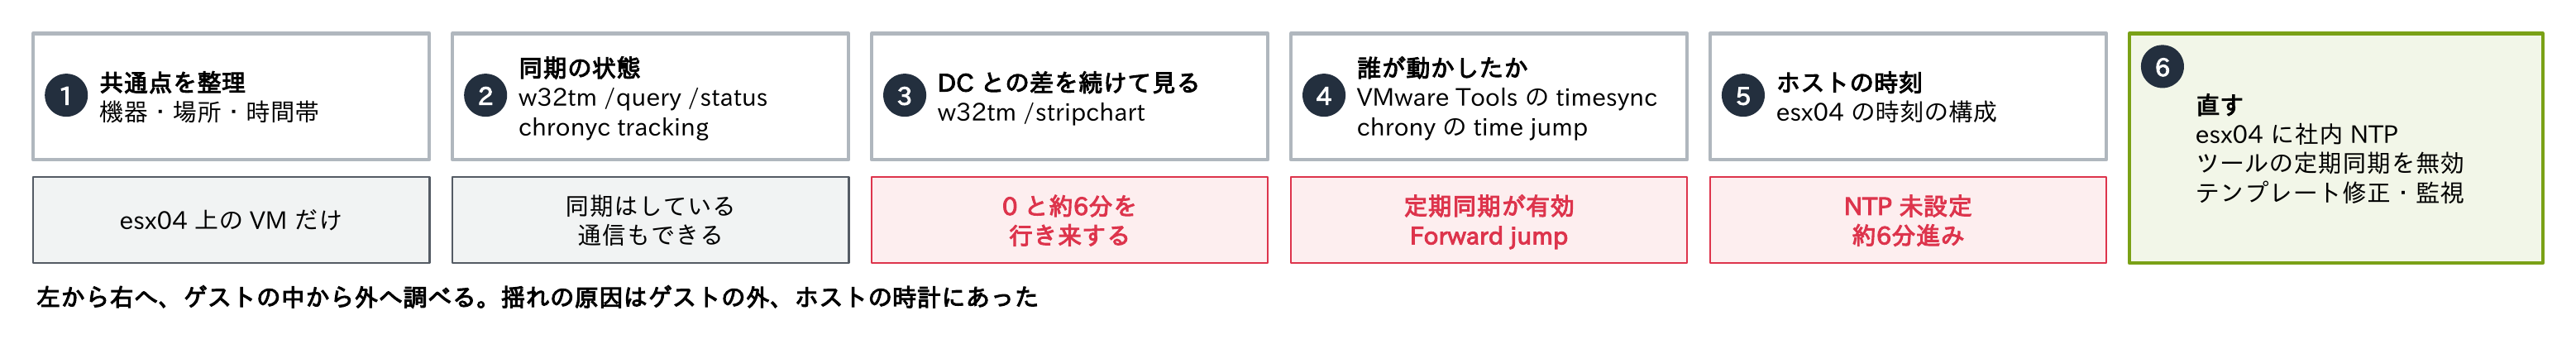
案Cです。w32timeの参照先はDCで、通信もできています(ファイアウォールではない)。それでも時刻が跳ぶのは、古いテンプレートで有効なVMware Toolsの定期同期が、NTPが未設定で約6分進んだesx04の時刻を押し付けているためです(第6回・第10回の二重の同期)。
esx04に社内NTPを設定し、定期同期を無効にして、テンプレートも直します。ゲストの中から外へ調べると、揺れの原因はゲストの外、ホストの時計にありました。同じ週末のファイアウォールの変更は、疑わしく見えても、同期の状態を確かめれば外せます。
問4 監査の要件で、UTCから1ms以内にそろえる
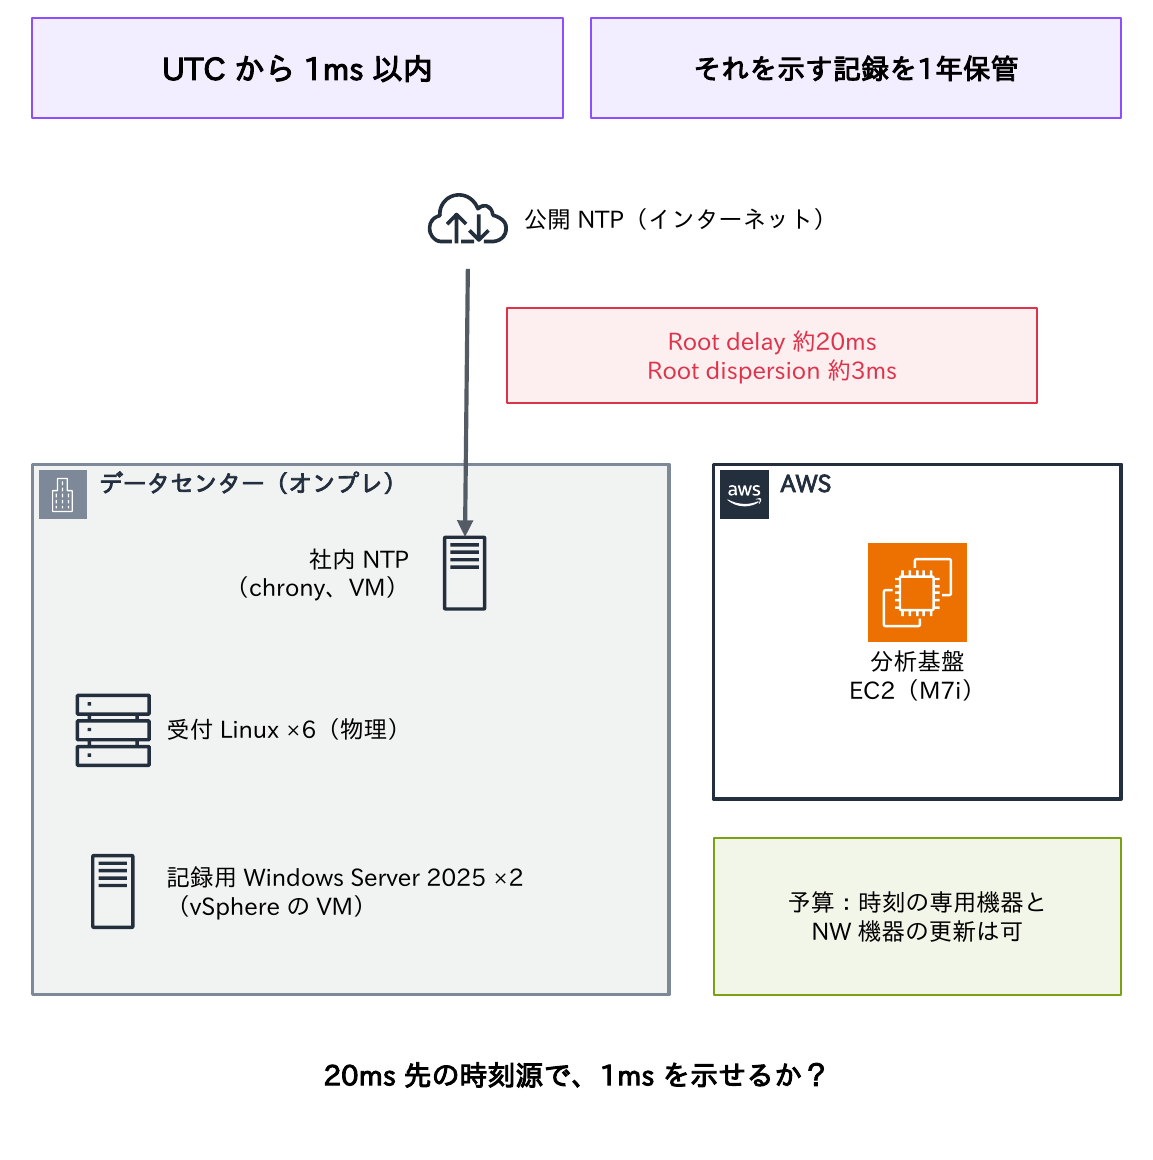
- 状況:取引を記録するシステムで、監査の要件として「記録サーバーの時刻をUTCから1ms以内に保ち、それを示す記録を1年間保管する」ことが求められた
- 構成:オンプレのデータセンターに、受付用のLinuxサーバー6台(物理)と、記録用のWindows Server 2025が2台(vSphereのVM)。分析基盤はAWSのEC2(Linux、M7i)
- 現状:社内NTP(chrony、VM)が、インターネット経由で公開NTPを参照している。記録サーバーで
w32tm /query /statusを見ると、Root Delayが約20ms、Root Dispersionが約3ms - 予算:時刻の専用機器とネットワーク機器の更新は、必要なら認められる
考えるポイント:今の構成で1msを示せるか、NTPとPTPの使い分け、Windowsの高精度時刻の条件、クラウドのPTPハードウェアクロック、監視と証跡。
問4 解答例
| 案 | 構成 | メリット | デメリット |
|---|---|---|---|
| A | 今の構成のまま、社内 NTP と記録サーバーのポーリング間隔を短くする | 費用がかからない | 誤差の上限が約13ms(ずれの絶対値+3ms+20ms÷2)以上で、1ms を示せない |
| B | データセンターに GNSS 受信機付きの時刻サーバー(stratum 1、NTP と PTP に対応)を2台置く。物理の Linux は PTP(ptp4l・phc2sys、PTP 対応スイッチ)、Windows の VM は同じ LAN から NTP(高精度の設定)、EC2 は精度重視の配置グループで PTP ハードウェアクロックを使う | どこでも 1ms に十分な余裕があり、根拠を示しやすい | 時刻サーバー、PTP 対応スイッチ、アンテナの費用と運用 |
| C | 時刻サーバーは案B と同じにし、配布は NTP だけにする(chrony のハードウェアタイムスタンプ、短いポーリング間隔) | スイッチの入れ替えが要らない | ネットワークの負荷と非対称の影響を受けやすく、余裕が小さい。測定で確かめる必要がある |
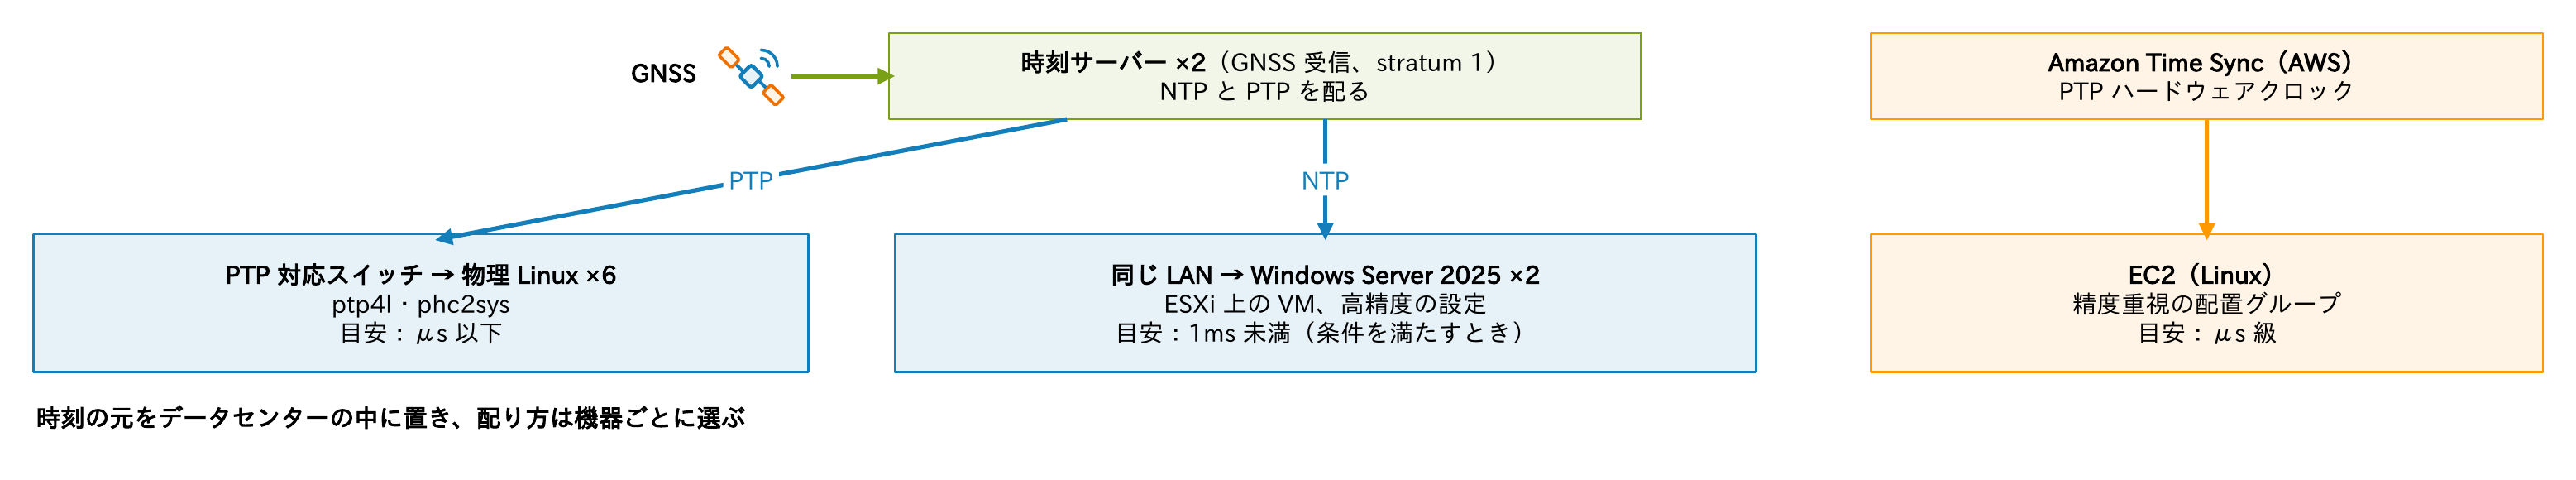
案Bが有力で、測定で余裕が確かめられれば案Cでも要件を満たせます。
案Aが駄目な理由は、第4回(Linuxの時刻同期)の誤差の上限の式で分かります。Root delayが20msあると、それだけで上限は10ms以上になり、1msは示せません。時刻源をデータセンターの中に置くことが出発点です。
Windowsで1msを狙うには、時刻源までの遅延0.1ms未満、stratum 5以内、4ホップ以内、CPU使用率の1日平均80%以下(VMはホストも)がMicrosoftの条件です(第5回)。EC2のWindowsはPTPハードウェアクロックを使えず、NTPで受けます(第9回)。
問4 解説:精度の示し方(監視と証跡)
| 対象 | 記録する値 | 取り方 | 保管と警告 |
|---|---|---|---|
| Linux(chrony) | System time、Root delay、Root dispersion から誤差の上限(ずれの絶対値+Root dispersion+Root delay÷2) | chronyc tracking を定期的に取得、または log tracking measurements statistics | 上限が 0.5ms を超えたら警告。1年保管 |
| Linux(PTP) | ptp4l・phc2sys のずれ(offset)と状態 | ptp4l・phc2sys のログ | 状態の変化とずれを警告 |
| Windows | Computed Time Offset、NTP Roundtrip Delay、使っていた時刻源 | パフォーマンスカウンター、w32tm /debug /enable、システムログ(Time-Service・Kernel-General) | カウンターとログをまとめて保管 |
| 時刻サーバー | GNSS の受信状態、ホールドオーバー(受信断の間の自走)への切り替え | SNMP・syslog、機器のログ | 受信断と切り替えを警告 |
| EC2 | 誤差の上限 | ClockBound(AWS のオープンソースのデーモン) | CloudWatch に記録 |
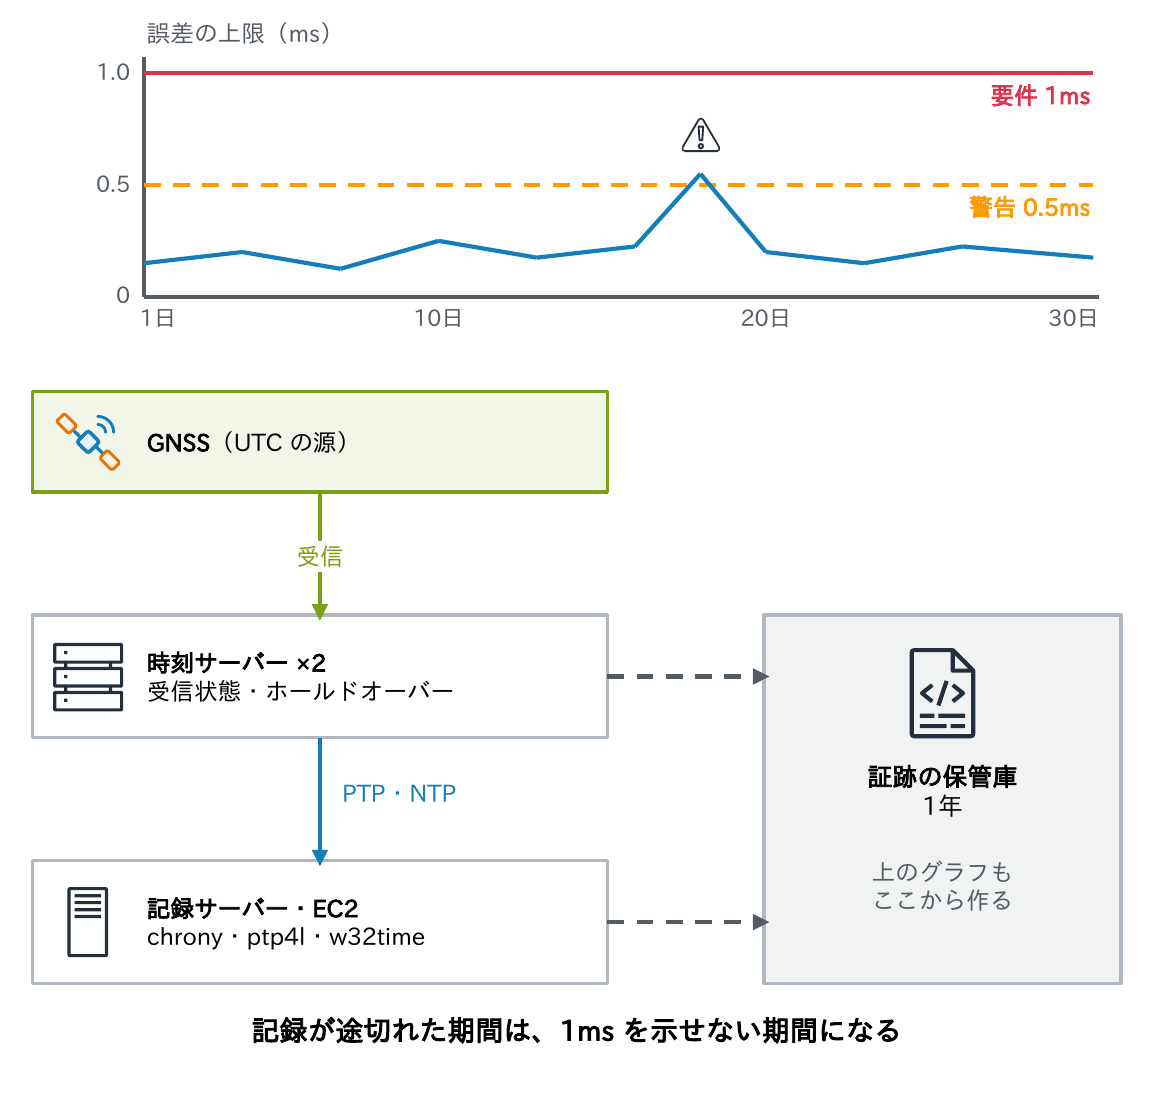
1msの根拠は、ずれの値だけでなく「誤差の上限」と、UTCまでたどれる時刻源の連鎖(トレーサビリティー)で示します。Microsoftも、w32timeのログ・イベントログ・パフォーマンスカウンターを保管して後から示す方法を案内しています。GNSSは妨害や受信断もあるため、時刻サーバーは2台とし、互いに比べます(第7回)。
記録が途切れた期間は、1msを示せない期間になることも、忘れないようにしましょう。
振り返り
全11回を通じて、持ち帰ってほしいことは3つです。
- 時刻はUTCを基準に、独立した4つ以上の時刻源から、1本の階層でそろえる。外部は社内NTPだけが参照し、リープスメアの有無を混ぜず、ログはUTCで記録する
- 時計を動かす仕組みは1台に1つ。chrony・w32timeと仮想化のツールによる二重の同期を避け、大きなずれのstepは業務への影響を考えて行う
- 同期の状態は数値で読み、監視して示す。届くか → 使われるか → 誰が時計を動かしたか、の順に確かめる
まずは自分のサーバーでchronyc sources -v(Windowsはw32tm /query /status)を実行し、どの時刻源に合わせているかを確かめてみてください。困ったときに戻る場所は、第10回の「連載の早見表」にまとめています。時刻に深く関わる証明書とDNSは、連載「証明書入門」「DNS入門」もあわせてどうぞ。
まとめ
- 設計は要件と現状の確認から。書かれていない条件は仮定を明記する
- 問1:外へ出るのは社内NTPだけ。ADの元はPDCエミュレーター1台。出口の障害でもUTCを保つならGNSS
- 問2:時刻源は場所ごとに1系統、スメアを混ぜない。つなぐのはUTCで書いたログ
- 問3:共通点から、同期の状態 → 誰が時計を動かしたか → ホストの順に。許容範囲を広げるのは対症療法
- 問4:1msは時刻源を近くに置き、誤差の上限と記録で示す。記録が途切れた期間は示せない
「NTP入門」全11回、最後までお読みいただき、ありがとうございました。
連載「NTP入門」全11回
全回の目次と、読む順番・目的別の読み方は、NTP入門の入口のページにまとめています。
コメント