「障害の原因を調べたいのに、そのサーバーのディスクが壊れていてログが読めません」
「容量が心配なので、ログはwarning以上だけ集めることにしました」
どちらも、よく聞く話です。でも前者はログを機器の中に置いたままだったこと、後者は大事な記録を自分で捨てていることが問題です。
ログは、障害や不正アクセスが起きたときに「何が起きたか」を後から確かめられる、ほとんど唯一の手がかりです。連載「syslog入門」では、なぜログを集めるのかから始め、syslogの形式と転送方式、Linuxのjournaldとrsyslog、Windows・ネットワーク機器のログ、集約基盤の設計、SIEM、クラウドのログ、届かないときの切り分けまでを全11回で扱います。第1回は、ログとは何か、なぜ集めるのかです。
連載の進め方
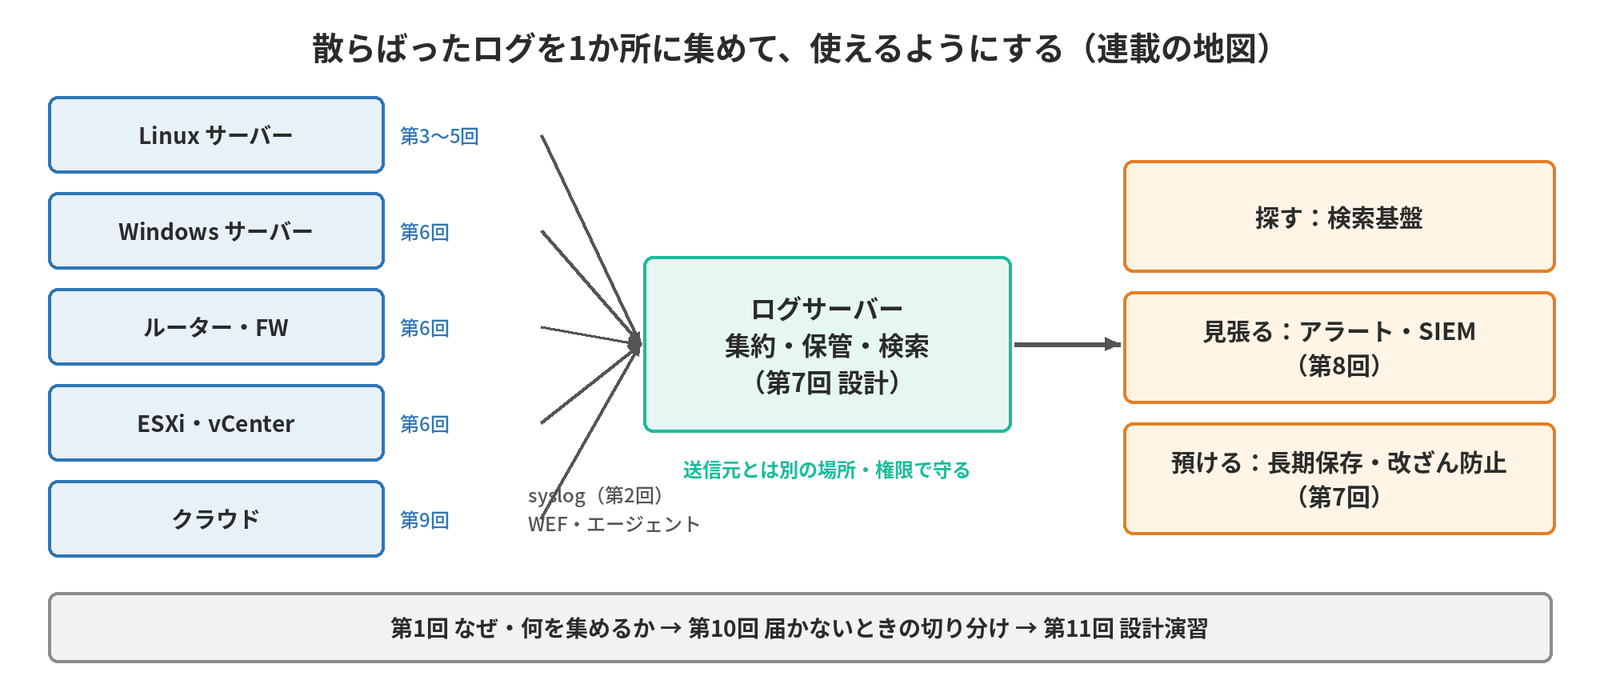
第1回〜第3回が土台です。第1回で「なぜ・何を集めるか」、第2回で「syslogの形式と運び方」、第3回で「Linuxの中のログの流れ」を押さえると、第4回以降の設定の意味が分かります。コマンドは、LinuxとWindows標準のPowerShellを併記します。
ログの役割
ログとは、システムが「いつ、どこで、何が起きたか」を時刻付きで書き残した記録です。役割は大きく4つあります。
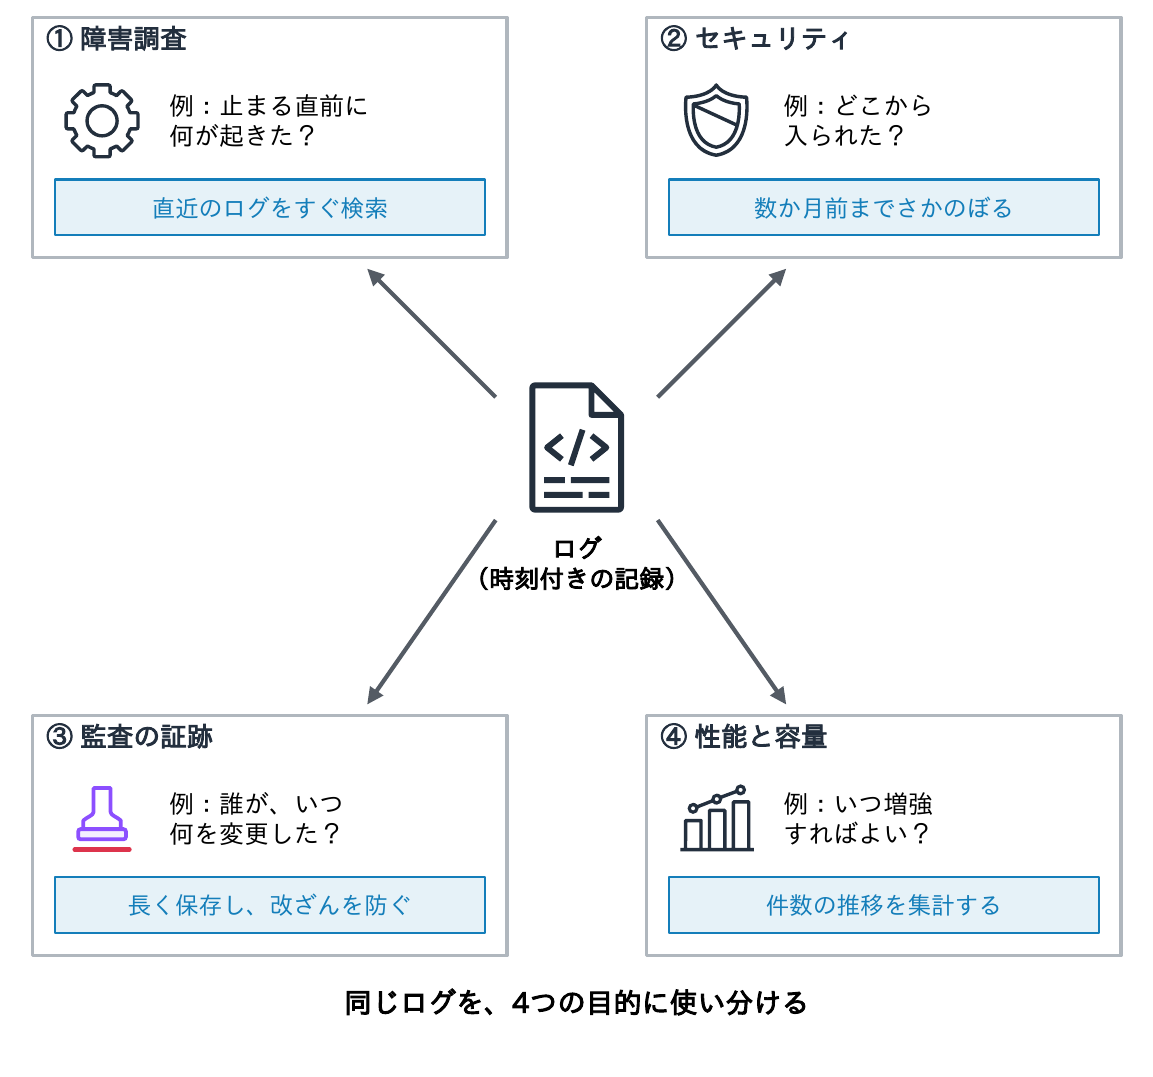
- 障害調査:サービスが止まった時刻の前後に何が起きたかをたどり、原因と影響の範囲を特定する
- セキュリティの検知と調査:ログインの失敗の急増や、深夜の管理者権限の使用などから攻撃の兆候を見つけ、侵入された後は、いつ、どこから入り、何をされたかを追跡する
- 監査の証跡:誰がいつ何を変更し、どのデータにアクセスしたかを第三者に示す。PCI DSSやISMSが保存を求めるのはこの役割
- 性能と容量の把握:アクセス数やエラーの件数の推移から、増強の時期や設定の問題を判断する
同じログでも、目的によって必要な保存期間と検索の速さが違います。何のために集めるのかを先に決めることが、設計の出発点です。
ログを集中管理する理由
ログを各機器の中に置いたままにすると、3つの問題が起きます。
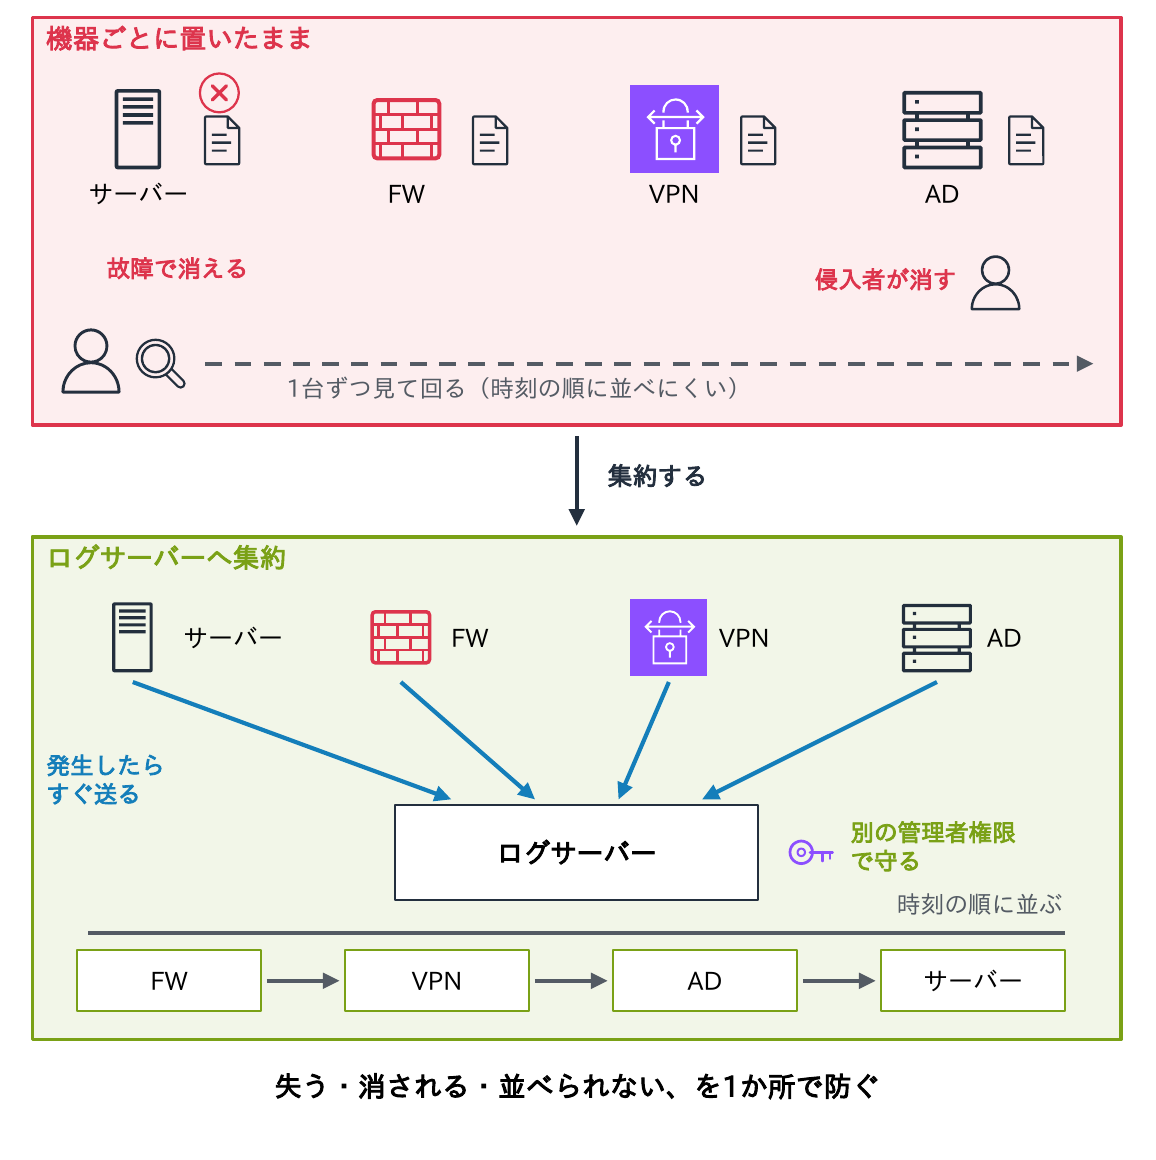
- 機器と一緒に失われる:ディスクが壊れたサーバー、交換したネットワーク機器、Auto Scalingで削除された仮想マシンのログは、もう調べられない。再起動で消える機器も多い
- 侵入者に消される、書き換えられる:攻撃者は痕跡を消すためにログを削除・改ざんする(MITRE ATT&CKのT1070)。管理者権限を奪われた機器のログは信用できない
- 横断して調べられない:1件の不正アクセスは、ファイアウォール、VPN、AD、サーバーのログにまたがって現れる。1台ずつ見ていては、時刻の順に並べられない
そこで、ログは発生したらすぐにログサーバーへ送り、そこで保管と検索を行います。ログサーバーは、送信元とは別の管理者権限で守ります。冒頭の「ディスクが壊れてログが読めない」は、集中管理していれば防げた問題です。
ポイント
失う・消される・並べられない、を1か所で防ぐ。ログは「発生したらすぐ外へ」。
1件の不正アクセスは、4か所のログにまたがる
2026-09-26T01:02:11Z fw01   allow tcp 203.0.113.50:51022 -> 192.0.2.30:443           (ファイアウォール)
2026-09-26T01:02:14Z vpn01  user=tanaka login success from 203.0.113.50                  (VPN)
2026-09-26T01:05:40Z dc01   4624 Logon Type 3 TargetUserName=tanaka IpAddress=192.0.2.200 (AD)
2026-09-26T01:07:02Z web01 sudo: tanaka : COMMAND=/usr/bin/tar czf /tmp/x.tgz /data (サーバー)- 外部の同じアドレスから、ファイアウォールを通り、VPNに同じ利用者名でログインし、ADで認証され、サーバーでデータをまとめている……という流れは、4台のログを時刻で並べて初めて見える
- どれか1台のログが消えていたり、時刻がずれていたりすると、流れが途切れる
- 上の例はUTCで、年・秒までそろえて記録している。形式がばらばらだと、並べる前に変換が要る(第2回・第7回)
ログとメトリクス・トレース
システムの状態を知る手がかりには、ログのほかにメトリクス(CPU使用率・件数などの数値の時系列)とトレース(1件の要求が複数のサービスをたどった経路)があります。
- ログ:何が起きたかの個々の記録。調査と証跡に強い
- メトリクス:数値の推移。しきい値の監視とグラフに強く、量が少ない
- トレース:1件の処理の経路と所要時間。マイクロサービスの遅延の調査に強い(分散トレースの設計は、このブログの連載「AWSマイクロサービス設計入門」第6回でも扱います)
「応答時間の推移」のような数値はメトリクスで監視し、ログは記録と調査に使う、と分けると、ログの量も抑えられます。この連載はログを中心に扱い、収集ツールの一部(OpenTelemetry Collectorなど)でメトリクス・トレースにも触れます(第7回)。
何を集めるか:種類ごとの優先度
| 種類 | 主な例 | 優先度 | 主な目的 |
|---|---|---|---|
| 認証・認可 | SSH・sudo(secure、auth.log)、AD のログオン、VPN、RADIUS(連載「RADIUS入門」第16回「ログと監査」) | 必須 | 不正ログインの検知と追跡 |
| 管理操作・設定変更 | 機器の設定変更、特権コマンド、クラウドの API 操作(CloudTrail) | 必須 | 誰が何を変えたかの証跡 |
| 境界の通信 | ファイアウォールの許可・拒否、プロキシ、DNS の問い合わせ | 必須 | 侵入と持ち出しの経路の特定 |
| OS・サービスの異常 | カーネル、サービスの停止・再起動、ディスクの障害 | 高 | 障害調査 |
| アプリケーション | Web のアクセスログ、アプリのエラー | 高〜中 | 障害調査と攻撃の検知 |
| 性能・容量 | 処理件数、応答時間 | 中 | 傾向の把握(数値はメトリクスで監視) |
| デバッグ | debug レベルの詳細 | 常時は不要 | 調査のときだけ一時的に有効にする |
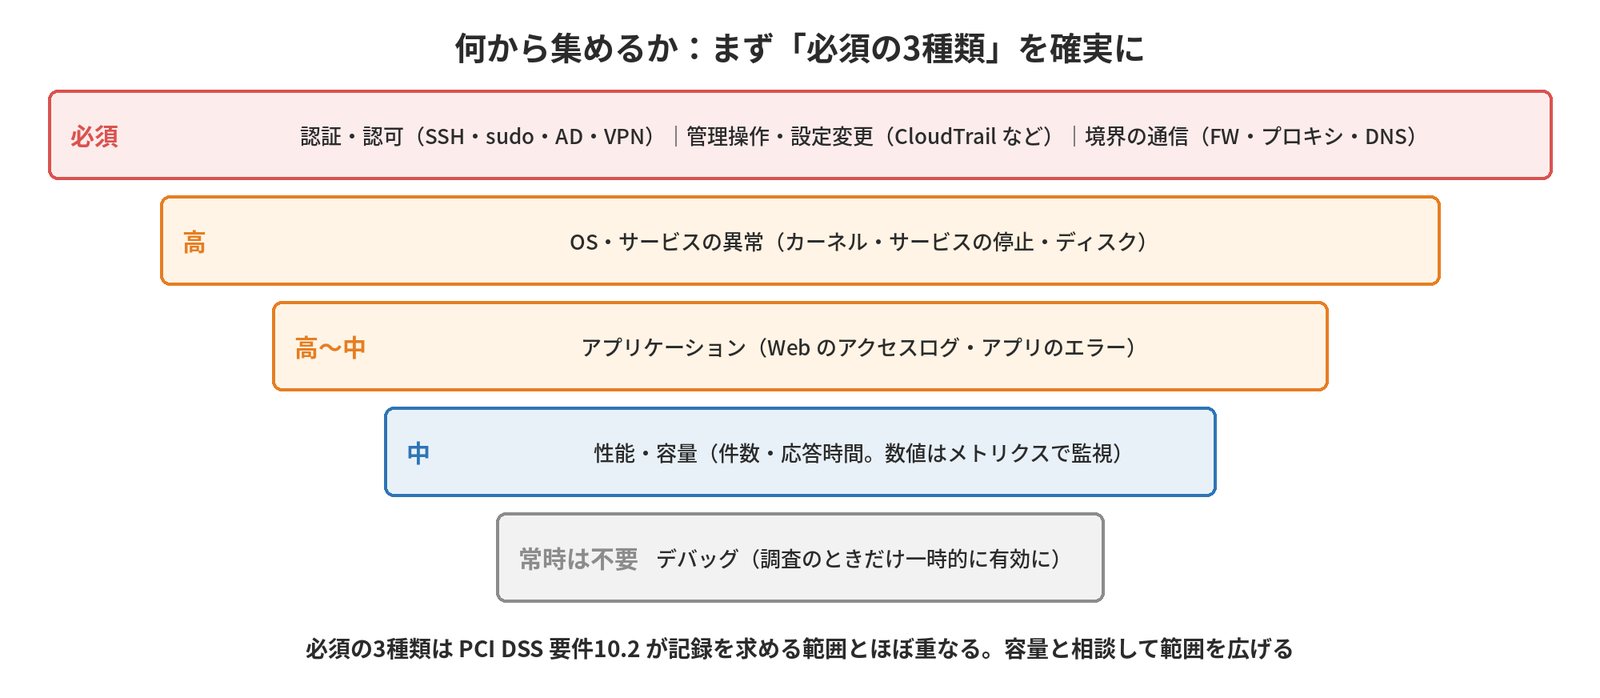
優先度は目安です。「必須」の3種類は、PCI DSSの要件10.2が記録を求める範囲とほぼ重なります。まず必須の3種類を確実に集め、容量の見積もり(第7回)と相談しながら範囲を広げます。何を監視して警報を出すかは、第8回で扱います。
どこまで集めるか:絞り方の注意
冒頭の「warning以上だけ集める」は、ここで問題になります。
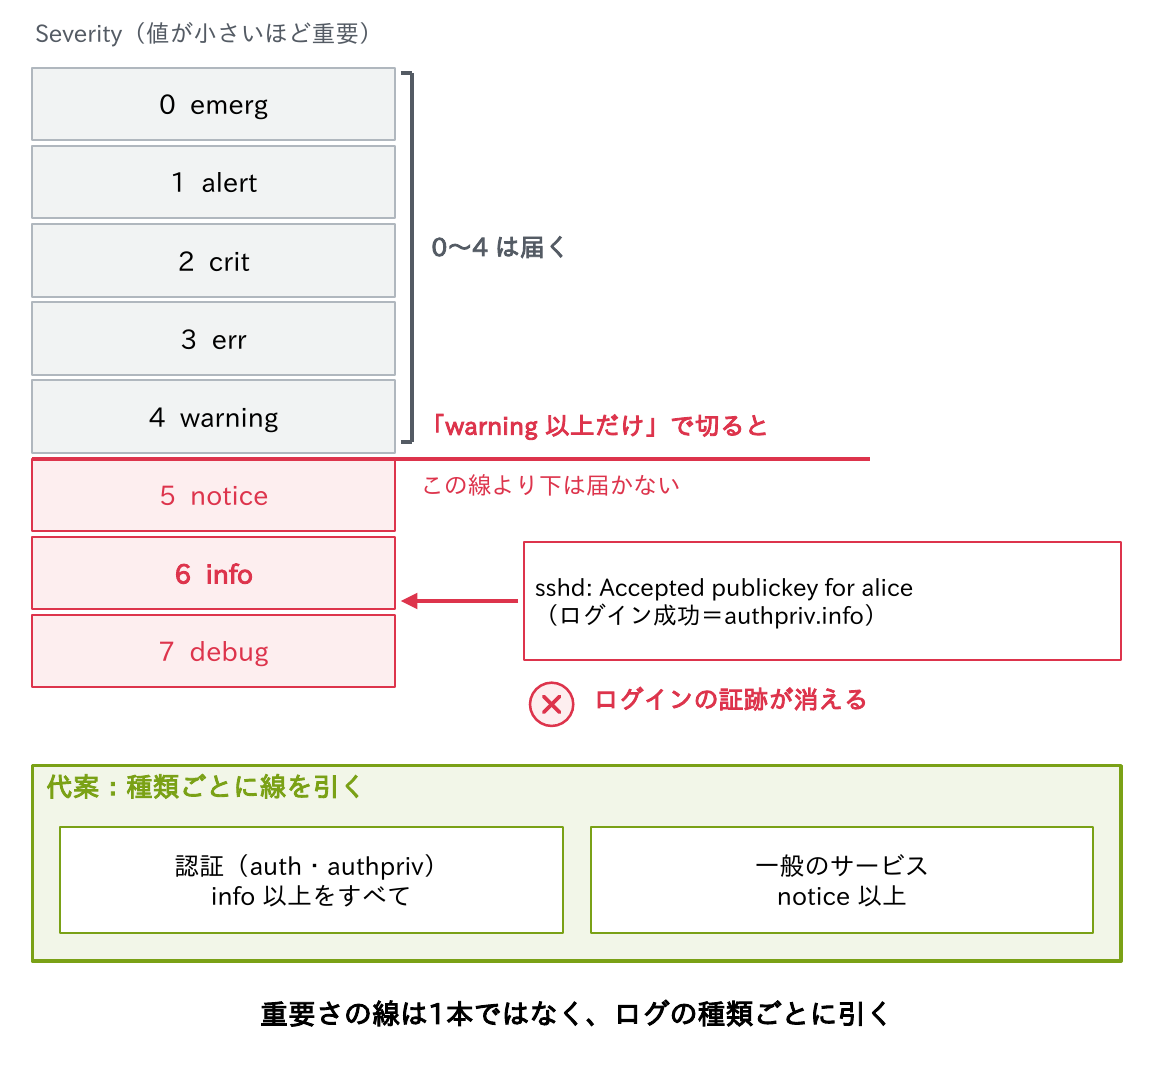
- Severityで一律に切らない:Severityは、各ソフトウェアの作者が決めた分類にすぎない。SSHのログイン成功(sshdの
Accepted publickey)はauthpriv.info(RHELの既定。Debian系はauth.info)で届くため、「warning以上だけ」にするとログインの記録が消える - 絞るなら、送信元の種類・Facility・プログラム名で決める。例:認証はinfo以上をすべて、一般のサービスはnotice以上(Facility・Severityは第2回)
- ローカルにも短期間残す:集約先へ送るのに加え、各機器にも数日分は残す。ネットワークやログサーバーの障害の間の穴埋めになる
- ログに入れてはいけないもの:パスワード、APIキーやトークン、カード番号(PAN)の全桁。アプリのデバッグ出力や、リクエストの全文記録に紛れ込みやすい
- 量は「1件の大きさ × 1秒あたりの件数 × 保存期間」で決まる。見積もり方は第7回
重要さの線は1本ではなく、ログの種類ごとに引くのです。
規制とガイドライン① PCI DSS
| 要件(v4.0.1) | 求める内容 |
|---|---|
| 10.2 | 全システムで監査ログを有効にする。個人によるカード情報へのアクセス、管理者の操作、ログへのアクセス、不正なアクセスの試行、アカウントの変更、ログの開始・停止などを記録 |
| 10.2.2 | 各イベントに、ユーザー、種類、日時、成否、発生元、対象を記録 |
| 10.3 | 閲覧を必要な人に限り、改ざんから守る。中央のログサーバー等へ速やかにバックアップし、変更検知の仕組みで書き換えを検知 |
| 10.4 | セキュリティイベントと重要なシステムのログを毎日確認する。確認は自動化する(10.4.1.1) |
| 10.5.1 | 保存は12か月以上、うち直近3か月はすぐに分析できる状態 |
| 10.6 | 時刻の同期 |
| 10.7 | ログの仕組みを含むセキュリティ機能の停止を検知し、対応する |
PCI DSSは、カード情報を扱う事業者の基準です。現行はv4.0.1(2024年6月公開。v4.0は2024年末で廃止)で、2025年3月末で将来日付だった要件もすべて必須になりました。
対象外の組織でも、「12か月保存・直近3か月はすぐ検索」「中央へ速やかに送る」「毎日確認」は、保存期間と構成を決めるときの良い目安になります。時刻の同期(10.6)は、連載「NTP入門」で詳しく扱っています。
規制とガイドライン② ISMSと個人情報
- ISMS(ISO/IEC 27001:2022、JIS Q 27001:2023):附属書Aの管理策8.15(ログ取得)で、活動・例外・障害などのログを取得し、保存し、保護し、分析することを求める。8.16(監視活動)で異常の監視、8.17(クロックの同期)で時刻の同期を求める
- ISMSは保存期間の数値を定めない。事業上の必要、法令、契約から自社で決め、規程に書いて守る
- ログも個人情報になり得る:ユーザーID、メールアドレス、氏名などを含み、他の情報と照らして個人を特定できるログは、個人情報として安全管理措置の対象になる
- 個人情報保護委員会のガイドライン(通則編)は、安全管理措置の手法の例として、ログイン実績やアクセスログなどの記録の整備と、ログ等の定期的な分析による不正アクセスの検知を挙げている
ログサーバーは、個人情報の集積所でもあります。閲覧できる人を限り、閲覧の記録も残し、保存期間を過ぎたら消します。
考えてみよう
- 担当するシステムのログは、どこに、何日分残っていますか。機器が壊れたり、管理者権限を奪われたりしたとき、そのログは残りますか。
- 「容量が心配なのでwarning以上だけ集める」という方針を提案されたら、どう答えますか。そのとき失われるログの例を挙げてください。
- 自社のログの保存期間は、どの規程・契約・基準に基づいて決まっていますか。決まっていなければ、何を根拠に決めますか。
ヒント:この記事の集中管理の3つの理由、sshdの例、PCI DSSの「12か月・3か月」と、ISMSは数値を定めないことが手がかりです。
まとめ
- ログは「いつ・どこで・何が起きたか」を時刻付きで残した記録。役割は障害調査・セキュリティ・監査の証跡・性能と容量
- 目的で保存期間と検索の速さが変わる。目的を先に決める
- 機器に置いたままだと失う・消される・並べられない。発生したらすぐログサーバーへ送り、別の権限で守る
- まず認証・管理操作・境界の通信の必須3種類を確実に集める
- Severityで一律に切らない。種類ごとに線を引き、ローカルにも数日残す
- PCI DSSは12か月保存・直近3か月はすぐ検索。ISMSは数値を定めず、自社で決める。ログサーバーは個人情報の集積所でもある
次回は、ログを集める共通の仕組みであるsyslogのメッセージの形式と転送方式を扱います。
連載「syslog入門」全11回
全回の目次と、読む順番・目的別の読み方は、syslog入門の入口のページにまとめています。
- ログとは・なぜ集めるか(この記事)
- syslogの基本
- Linuxのログの仕組み
- rsyslog 前編
- rsyslog 後編
- Windows・ネットワーク機器のログ
- ログ集約基盤の設計
- 分析と監視・SIEM
- クラウドのログ
- syslogのトラブルシュート
- ログ管理の設計演習
コメント