「NTPサーバーは冗長化のために2台参照しています。これで安心ですよね?」
「時刻が5分ずれていたので、手で合わせました」
どちらも、よくある運用です。でも実は、2台では誤った時刻を見分けられず、稼働中に時刻を一気に戻すとサービスが誤動作するおそれがあります。
第2回では、NTPが配る時刻(UTC)を見ました。第3回では、NTPがネットワーク越しにどうやって時刻のずれを測り、どう直すのかを扱います。ここが分かると、第4回以降の設定の意味がすぐ分かります。
NTPとは
NTP(Network Time Protocol)は、ネットワーク越しに時刻を合わせるプロトコルで、UDP 123番を使います。1985年のRFC 958に始まり、今は2010年のNTPv4(RFC 5905)が基準です。
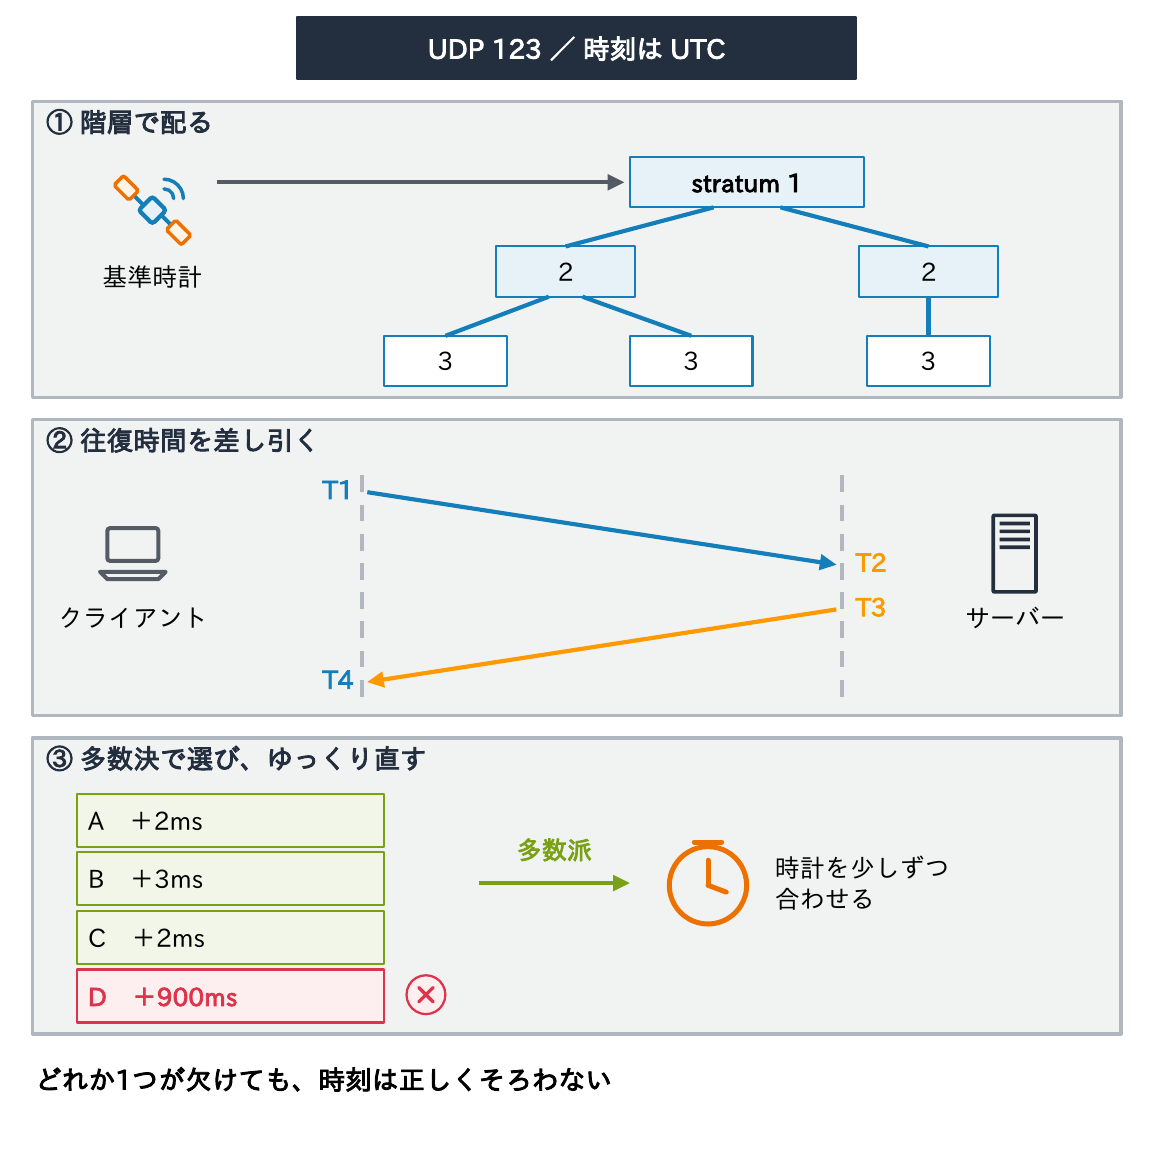
要点は3つあります。
- 正確な時刻源から階層(stratum)をたどって時刻を配る
- 4つのタイムスタンプで往復の通信時間を測って差し引き、ずれを計算する
- 複数のサーバーの答えを比べて外れ値を除き、時計を急に動かさず少しずつ直す
- やり取りする時刻は常にUTCで、タイムゾーンや夏時間の情報は含まず、うるう秒は予告(LI)だけを伝える
- 精度の目安は、インターネット越しで数十ms以内、LAN内で1ms未満
- 統計処理を省いた簡易版のSNTPもあり、systemd-timesyncdや多くの機器が使う。実装はntpd、chrony、Windows Timeなど
stratumの階層
NTPの時刻は、正確な時刻源から木のような階層(stratum)をたどって配られます。
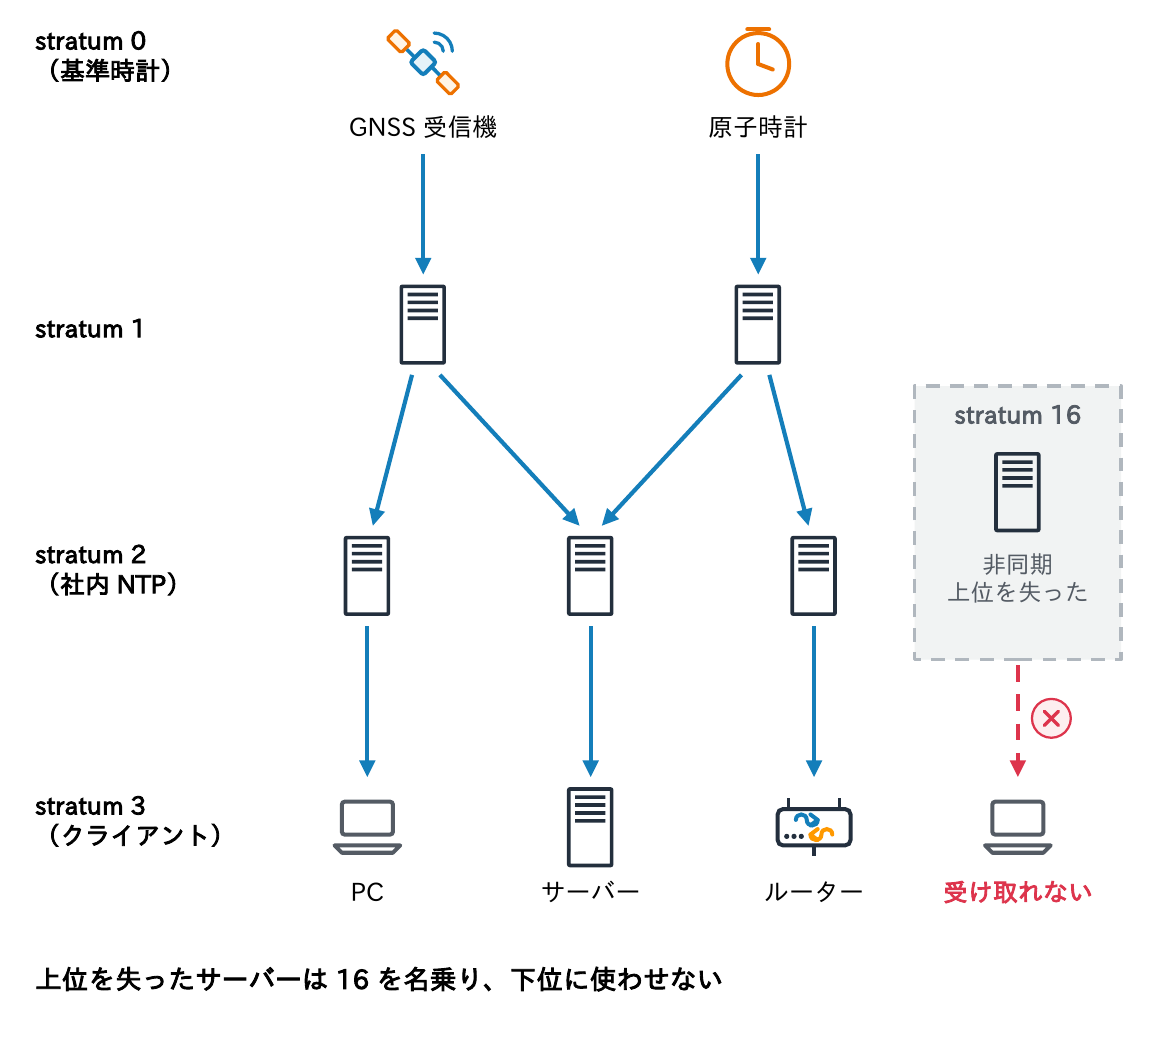
- GNSS受信機や原子時計などの基準時計を、慣例でstratum 0と呼ぶ。それに直結したNTPサーバーがstratum 1。そこから時刻をもらうサーバーは2、その下は3と、段ごとに1つ増える
- 同期できるのはstratum 15までで、16は「同期していない」ことを示す値。16からは時刻を受け取れない。上位を失ったサーバーは16を名乗るので、16は同期できていない合図
- stratumは段数で、精度の順位ではない。LAN内のstratum 2が、遠くのstratum 1より正確なこともある
- パケットのstratum 0は「不明・無効」で、アクセス制限などを伝えるKiss-o’-Deathに使う
4つのタイムスタンプ
NTPの核心は、4つのタイムスタンプで「時計のずれ」と「通信にかかった時間」を分けて求めることです。
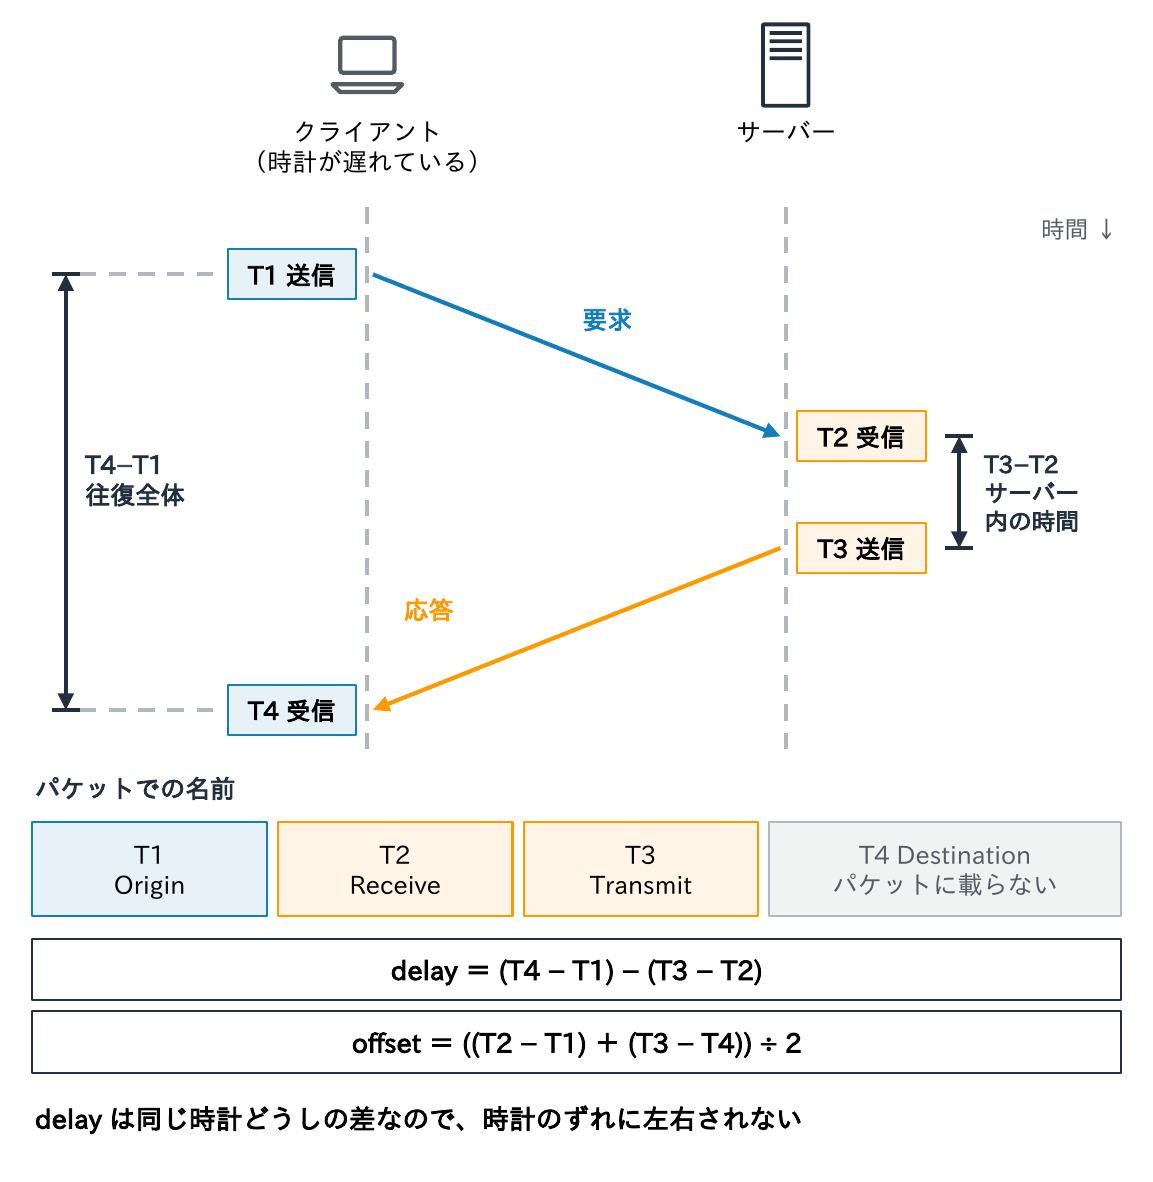
- クライアントは要求を送るときに、自分の時計の時刻T1を記録する
- サーバーは要求を受けた時刻T2と、応答を送る時刻T3を自分の時計で記録し、応答に入れて返す
- クライアントは応答を受けた時刻T4を記録する
(T4−T1)は往復全体、(T3−T2)はサーバー内で待った時間なので、その差が純粋な往復の通信時間(delay)です。行きと帰りの時間が等しいと仮定すると、時計のずれ(offset)は、行きの差(T2−T1)と帰りの差(T3−T4)の平均で求まります。
delayは同じ時計どうしの差なので、時計のずれに左右されないのがポイントです。
offsetとdelayの計算
具体的な数字で計算してみましょう。
| 記号 | 意味 | 記録する時計 | 例(10:00:00 以降の秒) |
|---|---|---|---|
| T1 | クライアントが要求を送った時刻 | クライアント | 0.050 |
| T2 | サーバーが要求を受けた時刻 | サーバー | 0.110 |
| T3 | サーバーが応答を送った時刻 | サーバー | 0.111 |
| T4 | クライアントが応答を受けた時刻 | クライアント | 0.071 |
offset = ((T2 − T1) + (T3 − T4)) / 2
       = ((0.110 − 0.050) + (0.111 − 0.071)) / 2
       = (0.060 + 0.040) / 2 = +0.050 秒   … 50ms遅れ
delay  = (T4 − T1) − (T3 − T2)
       = (0.071 − 0.050) − (0.111 − 0.110)
       = 0.021 − 0.001 = 0.020 秒          … 往復の通信時間は20ms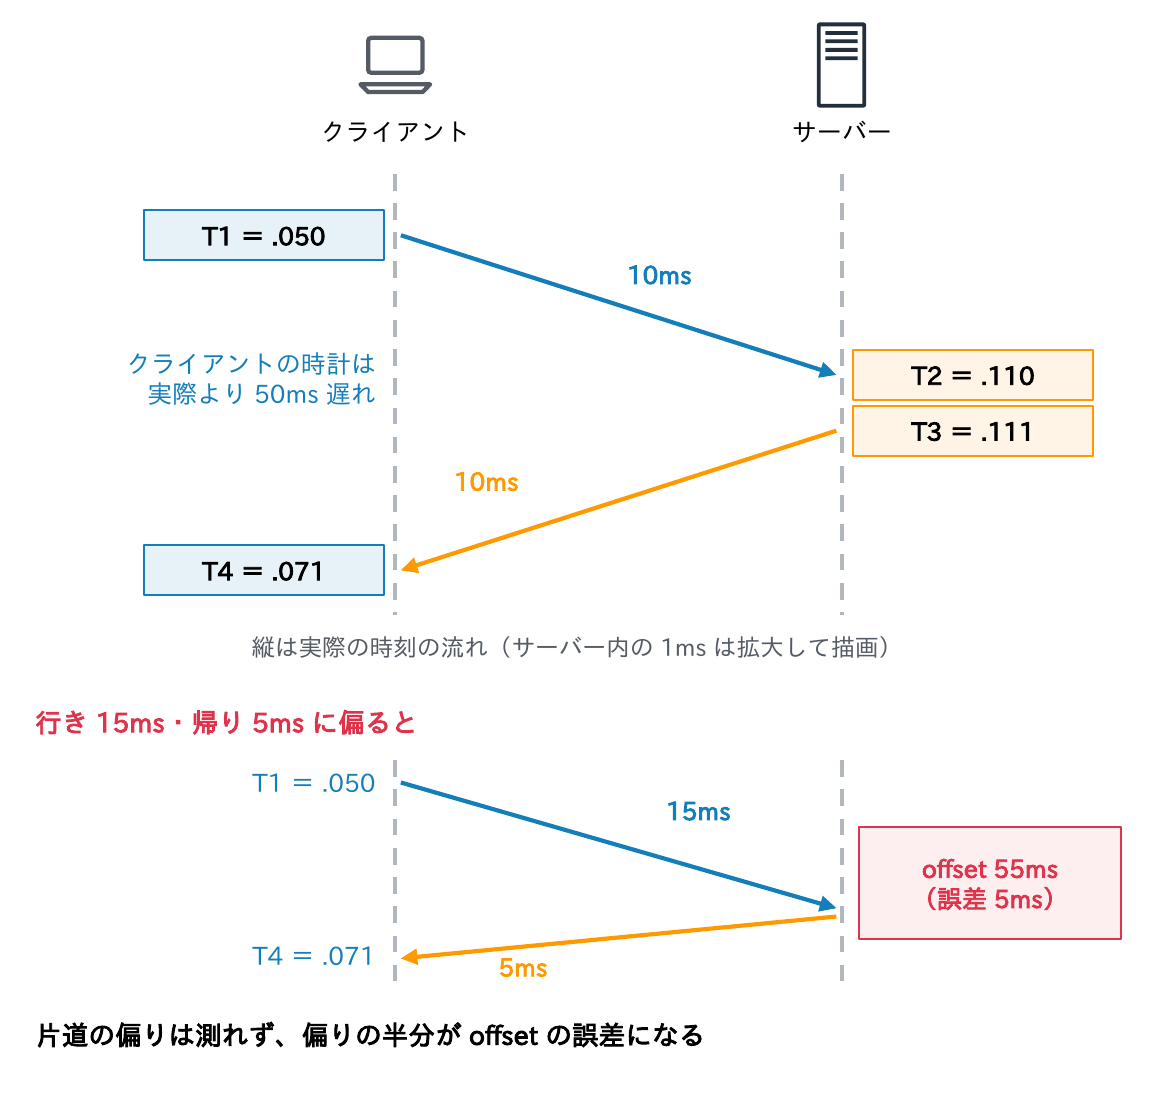
- 例は、クライアントの時計が50ms遅れ、片道10ms、サーバーの処理1msの場合。offsetが正なら、クライアントの時計を進める
- 計算は行きと帰りが同じ時間だと仮定している。行き15ms・帰り5msのように偏ると、offsetは55msと計算され、5ms(偏りの半分)の誤差が出る
- 片道の偏りは測れないが、誤差は最大でもdelayの半分に収まる。だからdelayの小さいサーバーほど信頼できる
root delayとroot dispersion
offsetとdelayは、直接やり取りしたサーバーとの間の値です。そのサーバーも上位の遅延や誤差を引き継ぐため、NTPは基準時計までの累積値をパケットで下へ伝えます。
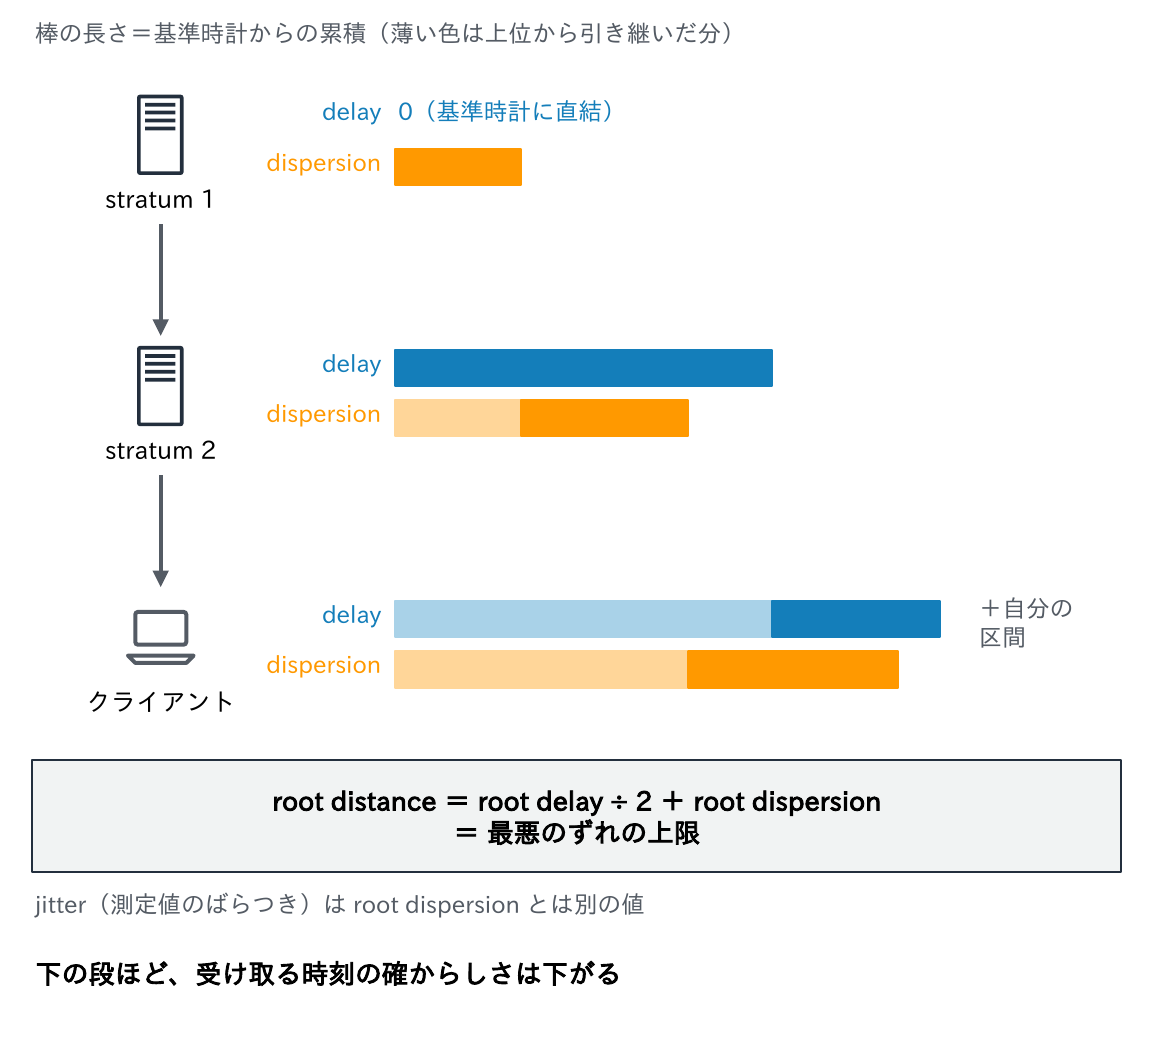
- root delay:基準時計までの往復遅延の合計
- root dispersion:累積した誤差の最大見積もり。測定の誤差に、次の測定までに時計がずれうる量(RFC 5905は15ppmを想定)を足していく値で、段を下るごとに増える。測定値のばらつきはjitterという別の統計
- クライアントは、root delayの半分とroot dispersionの和(root distance)を最悪のずれの上限とみなし、大きすぎるサーバーは使わない(上限はRFC 5905で1秒、chronyの既定で3秒)
下の段ほど、受け取る時刻の確からしさは下がります。
時刻源の選び方
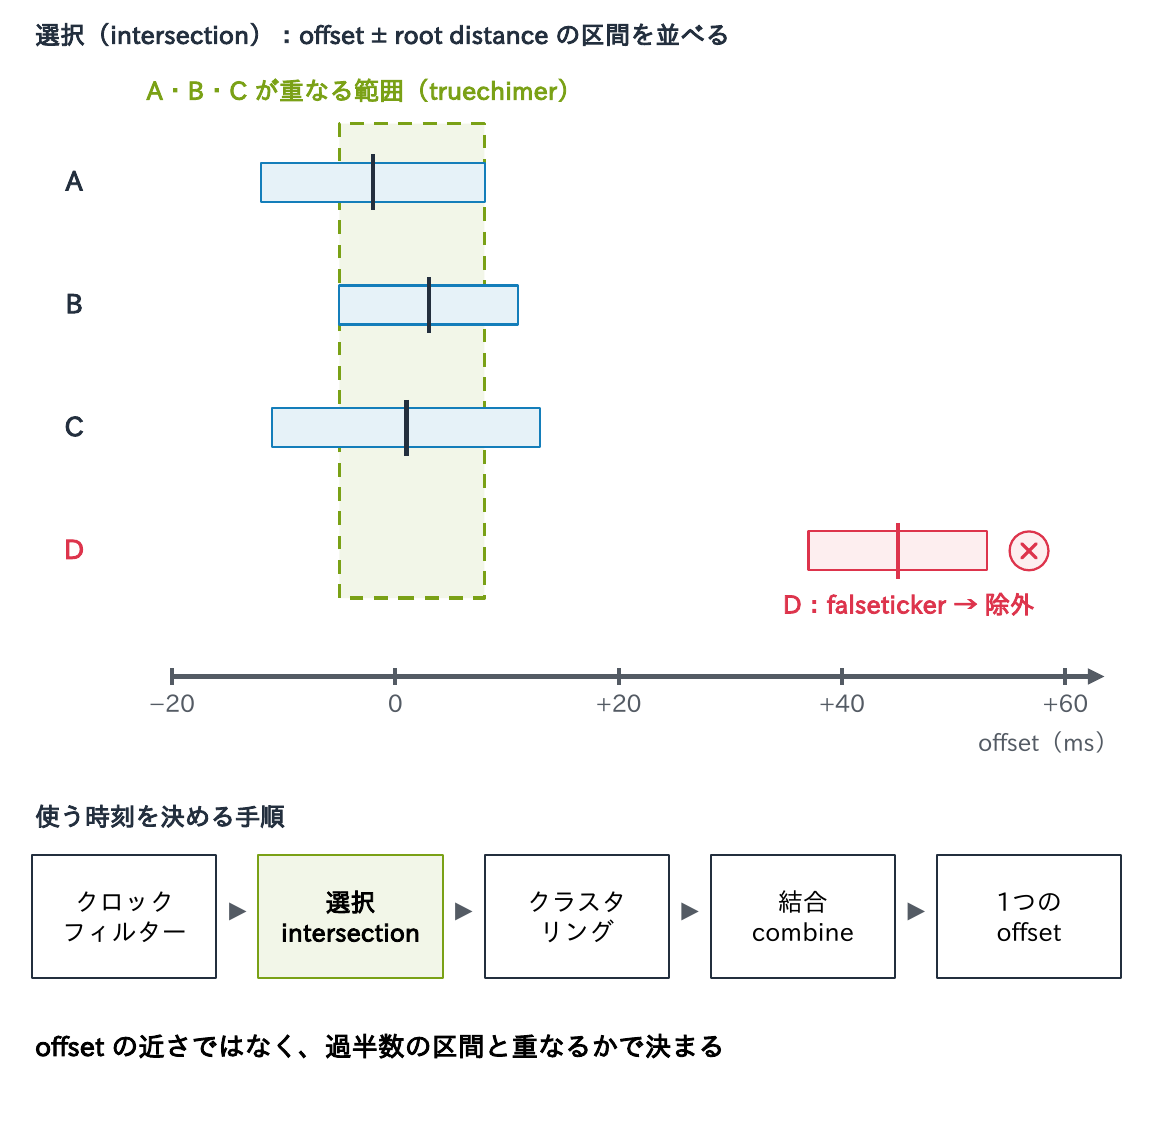
クライアントは複数のサーバーに問い合わせ、次の手順で使う時刻を決めます。
- クロックフィルター:サーバーごとに、直近8回の測定からdelayが最小の(混雑の影響が少ない)ものを選ぶ
- 選択(intersection)アルゴリズム:各サーバーのoffsetを「offset ± root distance」の区間として並べ、過半数の区間が重なる範囲を探す。範囲に入るサーバーがtruechimer、外れるサーバーがfalsetickerで、後者は除かれる
- クラスタリング:ばらつきの大きいものを減らす
- 結合(combine):重み付けして1つのoffsetを決める
つまり多数決で時刻を決めるので、過半数が正しい限り、壊れた時計や偽のサーバーを除けます。chronyも考え方は同じです(第4回)。
何台の時刻源を使うか
冒頭の「2台参照しているから安心」は、ここで崩れます。
| 台数 | 1台がおかしくなったとき | 評価 |
|---|---|---|
| 1台 | 誤りがそのまま伝わる。止まれば同期できない | 避ける |
| 2台 | 食い違っても、どちらが正しいか決められない。1台止まると1台と同じ | 1台と大差ない |
| 3台 | 1台の誤りは多数決で除ける。1台止まると2台と同じ状態 | 最低限 |
| 4台以上 | 1台が止まっても、残る3台で1台の誤りを除ける | 推奨(RFC 8633) |
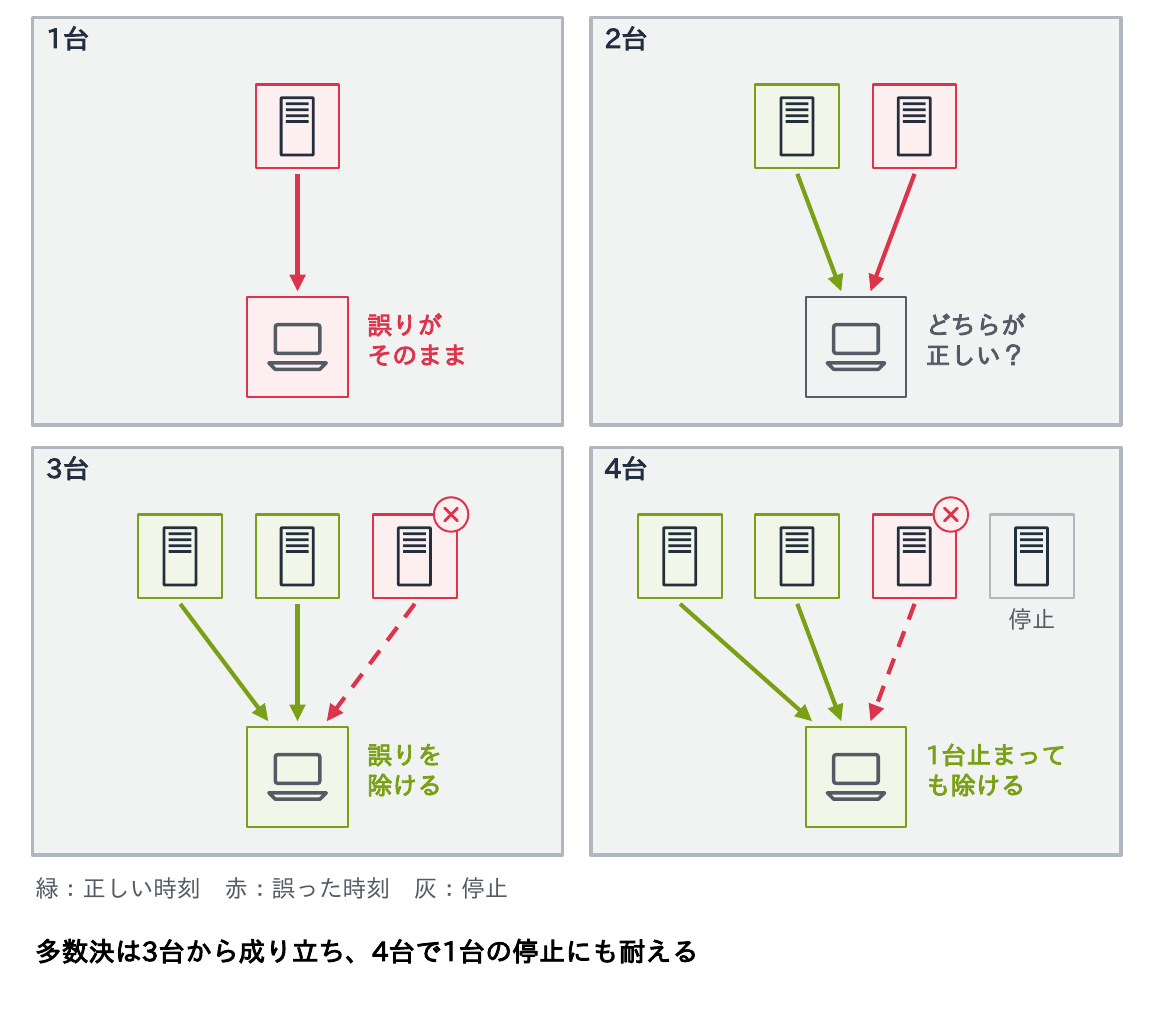
- RFC 8633(BCP 223)は、正確な時刻を保ちたいなら「独立した多様な時刻源を少なくとも4つ」使うべき(SHOULD)としている
- 前提は、過半数が正しいこと。多数決があるから、正しくない時刻源が混じっても同期を続けられる
- 同じ上位を参照する4台は、独立ではない(第7回)
ポイント
多数決は3台から成り立ち、4台で1台の停止にも耐える。2台は冗長のつもりで、実は1台と大差ない。
時刻の直し方:slewとstep
ずれを見つけた後の直し方は2通りあります。
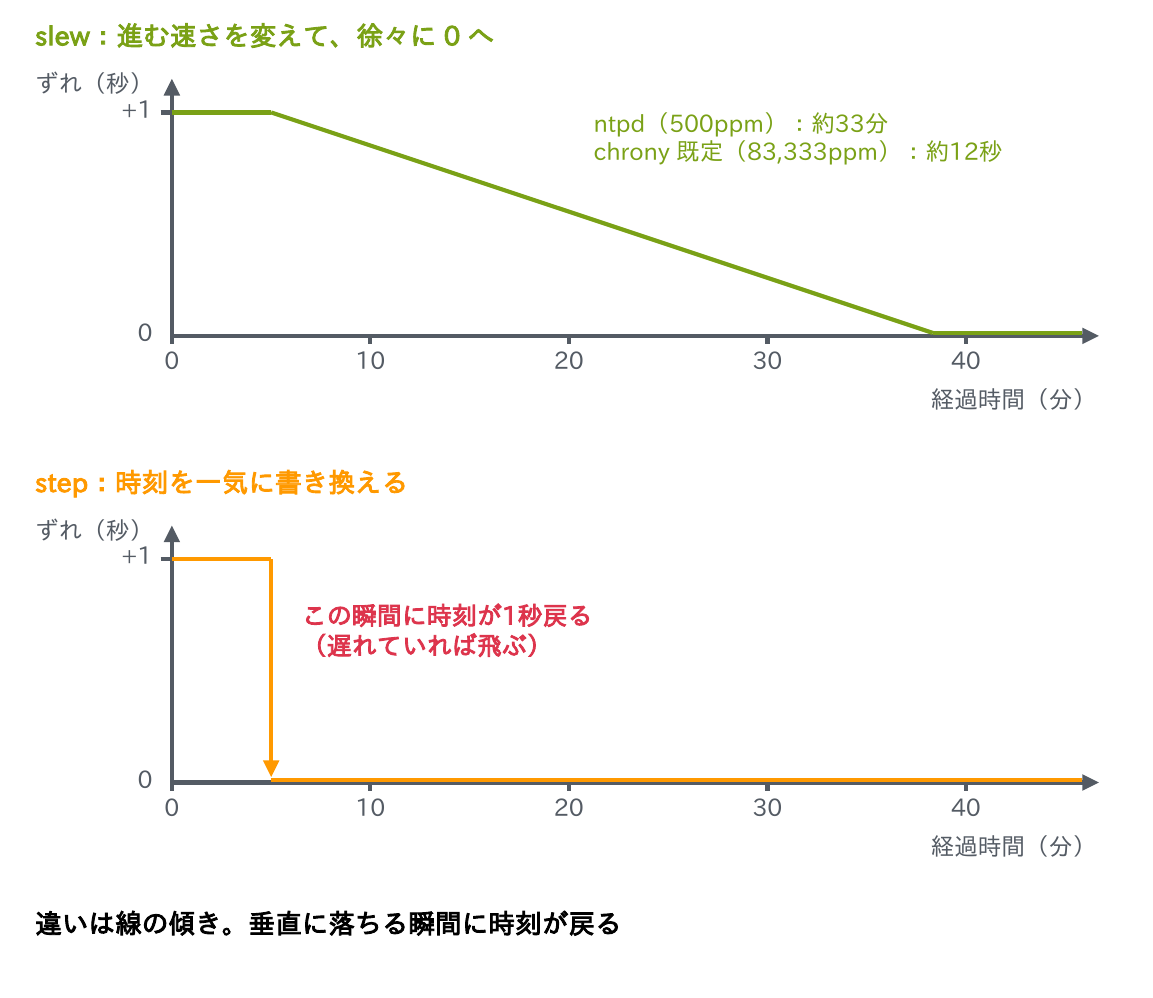
- slew(スルー):時計の進む速さを少し変え、時間をかけて徐々に合わせる。時刻が飛んだり戻ったりしないので安全。ただし速さには上限があり、ntpd(RFC 5905の参考実装)では500ppm(1秒あたり最大0.5ms)。この速さでは1秒のずれを直すのに約2,000秒(約33分)かかる。chronyは既定で最大83,333ppm(12分の1)まで速められる
- step(ステップ):時刻を一気に書き換える。すぐ合うが、時刻が戻るとログの順序が崩れ、タイマーやデータベースが誤動作するおそれがある
基本は、起動直後だけstep、稼働中はslewです。冒頭の「5分ずれていたので手で合わせた」は、稼働中のサービスに対するstepになるので、影響を考えてから行います(第10回)。
直し方の閾値
実装は、ずれの大きさでslew・step・異常(直さない)を切り替えます。
| 項目 | RFC 5905・ntpd | chrony |
|---|---|---|
| slew の最大の速さ | 500ppm | 既定 83,333ppm(maxslewrate で変更) |
| step する条件 | 128ms を超えるずれが stepout(900秒)続いたら(起動直後はすぐ) | makestep 1 3 なら、最初の3回の更新で1秒を超えたときだけ。指定がなければ step しない |
| panic(異常とみなす) | 1000秒を超えたら終了。-g で起動時の1回だけ許す | 既定ではなし。maxchange で設定できる |
| step を抑える | -x で step の閾値を600秒に広げる | makestep を書かない |
| 手動で一度だけ合わせる | ntpdate(旧)、ntpd -gq | chronyd -q、chronyc makestep |
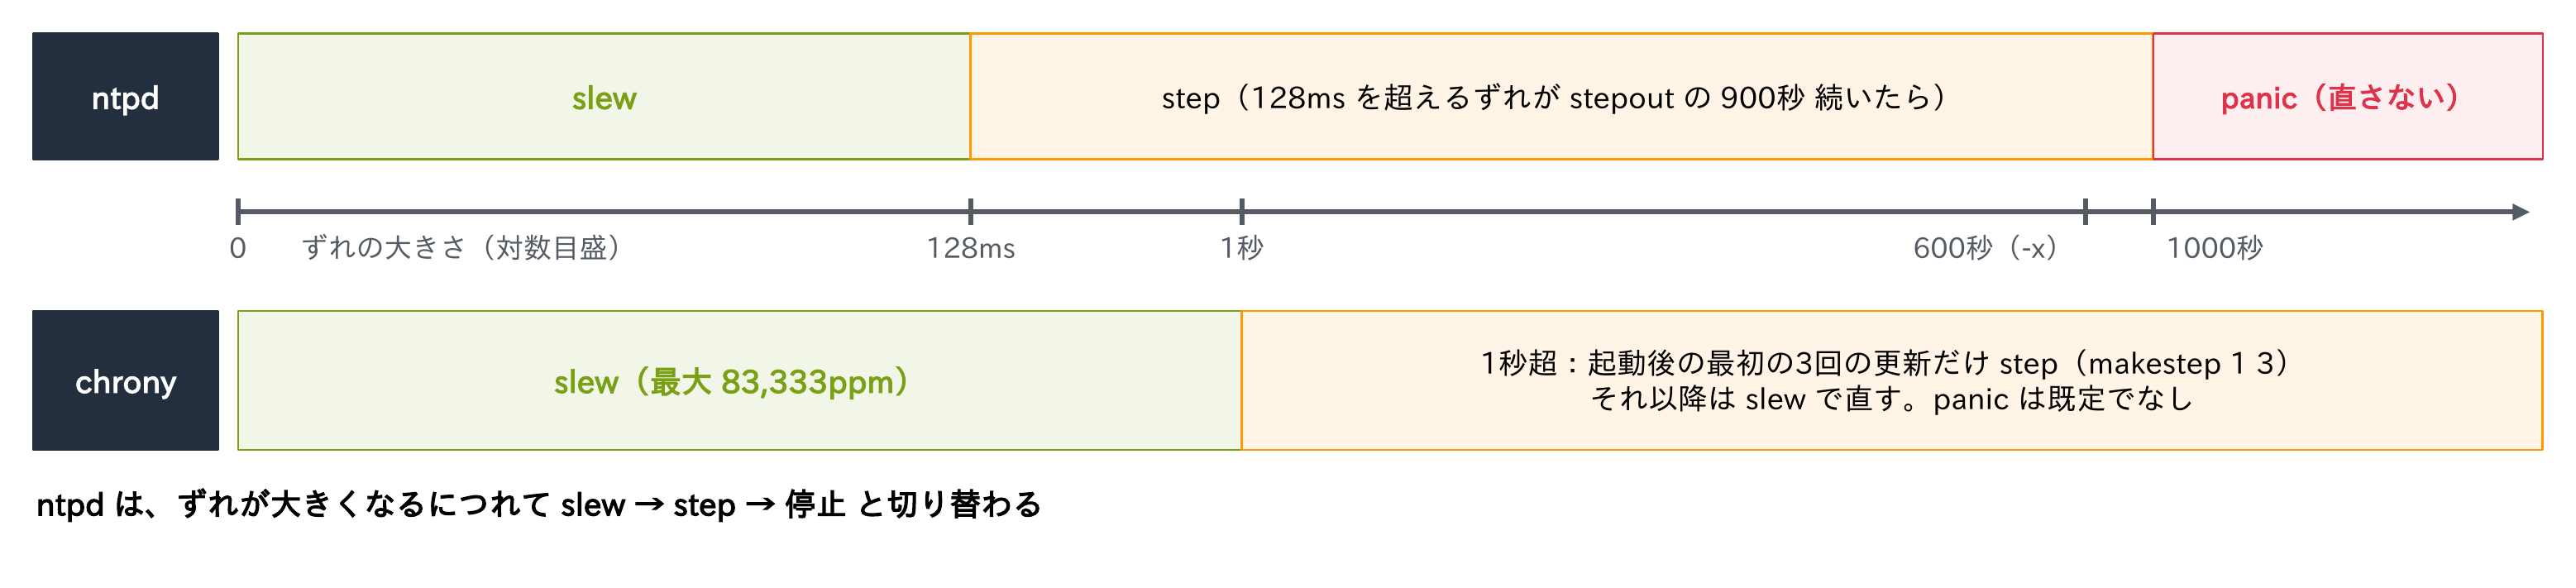
panicの1000秒は約17分です。仮想マシンのスナップショットからの復元やRTCの電池切れで大きくずれると、同期が止まったり直らなかったりします。Windows Timeにも、大きなずれを直さない閾値(MaxPosPhaseCorrectionなど)があります(第5回)。
ポーリング間隔
$ chronyc -n sources          (抜粋)
MS Name/IP address         Stratum Poll Reach LastRx Last sample
===============================================================================
^* 198.51.100.122                2   9   377   280  +5426us[+5452us] +/-  112ms
^+ 198.51.100.123                2  10   377   254  +5100us[+5100us] +/-  112ms
PS> w32tm /query /peers       (抜粋)
ピア: ntp.example.jp,0x8
状態: アクティブ
階層: 2 (二次参照 - (S)NTP で同期)
ピアポーリング間隔: 10 (1024s)
ホストポーリング間隔: 10 (1024s)- 問い合わせの間隔は2のべき乗の秒で表し、minpoll〜maxpollの範囲で自動で調整する。chrony・ntpdの既定は6〜10(64〜1024秒)。上の例のPoll 9は512秒、10は1024秒
- 同期が安定すると間隔を延ばして相手の負荷を下げ、ずれや揺らぎが大きいと縮める
- Reachは、直近8回の応答の有無を8ビットで表した値(8進数)。377なら8回すべて成功、0なら届いていない
- 公開サーバーに対してminpollを小さくしない(NTP Poolの利用条件)。短い間隔は、LAN内の自社のサーバーに限る
動作モード
| 値 | モード | 使いどころ | 注意 |
|---|---|---|---|
| 3・4 | クライアント・サーバー | 下位が上位に問い合わせる。ほとんどの構成はこれ | 基本の形 |
| 1・2 | symmetric active・passive | 同じ階層のサーバー同士で互いに時刻を補い合う(peer) | 認証なしの passive は危険。chrony は passive 側の自動応答に非対応 |
| 5 | broadcast | LAN 内にまとめて配る | 往復を測れず遅延を補正しにくい。なりすましに弱い。chrony は受信側に非対応 |
| 6 | 制御メッセージ | ntpq による状態の問い合わせ | 外部に開けない(第8回) |
| 7 | 実装独自(ntpd の ntpdc) | 旧来の管理用 | monlist が増幅攻撃に悪用された(第8回) |
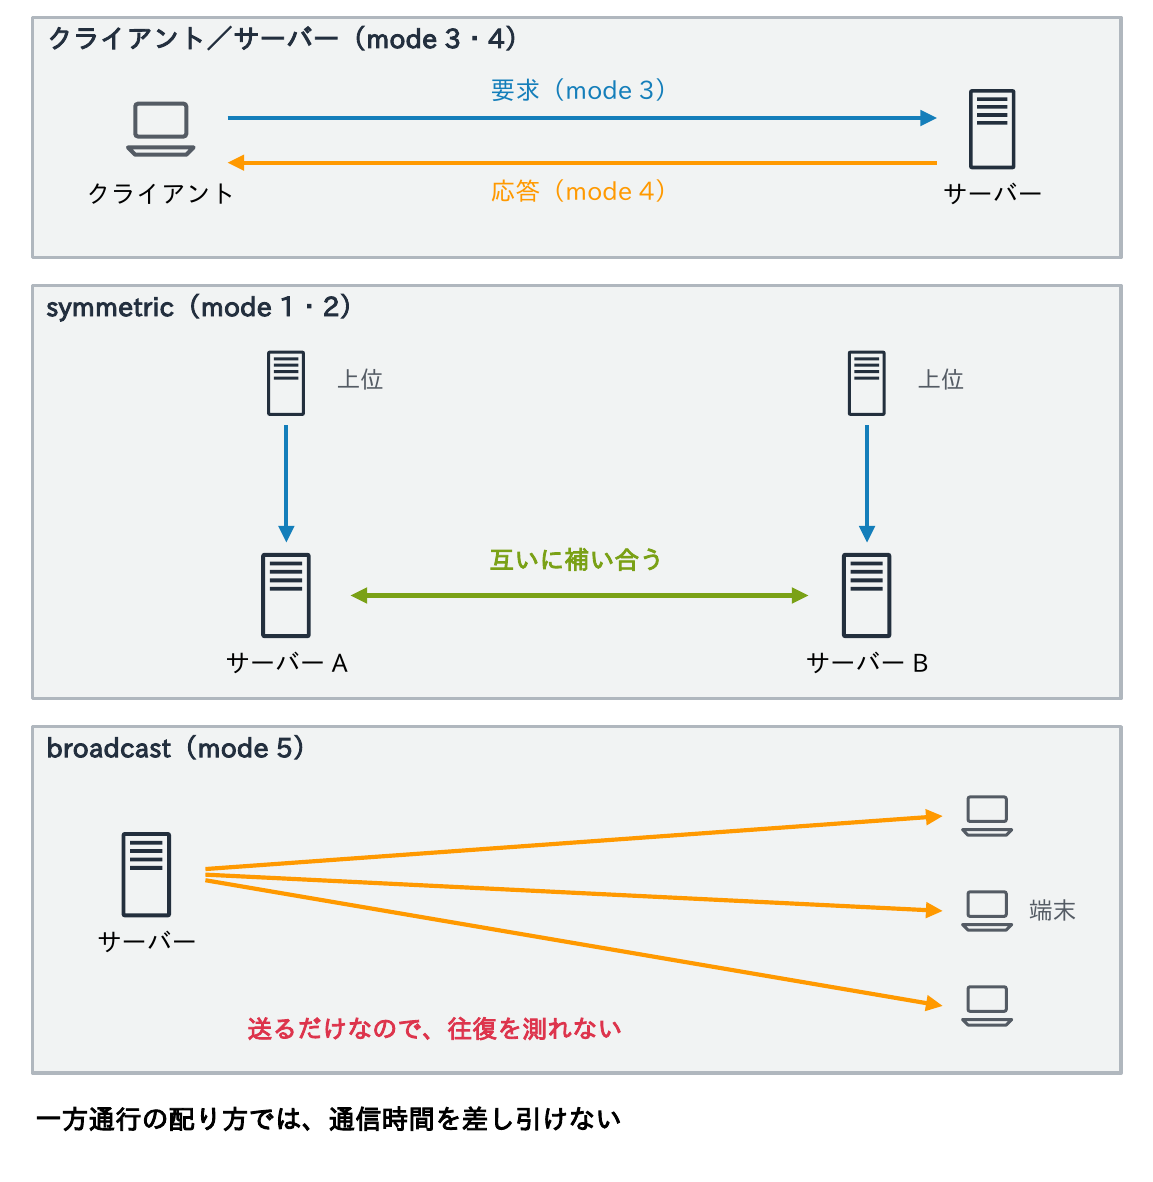
NTPでは、通信相手との関係をassociation(アソシエーション)と呼び、モードはその種類です。ntpdには、マルチキャストで相手を探すmanycastもあります。RFC 9769(2025年)は、送信後の正確な時刻を次のパケットで伝えるinterleavedモードを定めました。
一方通行の配り方(broadcast)では、通信時間を差し引けません。基本はクライアント・サーバーと覚えておきましょう。
NTPv4と関連するRFC
| RFC(年) | 内容 | 位置づけ |
|---|---|---|
| RFC 5905(2010) | NTPv4 の本体。SNTP も含む(RFC 1305・4330 を廃止) | 現在の基準 |
| RFC 7822(2016) | 拡張フィールドの扱い | NTS の土台 |
| RFC 8573(2019) | 対称鍵の認証を AES-CMAC に。MD5 は非推奨 | 第8回 |
| RFC 8633(2019) | NTP のベストプラクティス(BCP 223) | 設計の指針(第7回) |
| RFC 8915(2020) | NTS(Network Time Security) | 第8回 |
| RFC 9109(2021) | クライアントの送信元ポートをランダムにする | なりすまし対策 |
| RFC 9748・9769(2025) | レジストリの修正、interleaved モード | RFC 5905 を更新 |
RFC 5905は廃止されておらず、上のRFCで更新されながら使われています(2026年9月時点)。NTPv5はInternet-Draft(draft-ietf-ntp-ntpv5-09、2026年7月)の段階で、クライアント・サーバーのモードだけに絞る方針です。RFC 9523(2024年)は、時刻をずらす攻撃を見つける補助の仕組みKhronosを定めています。
NTPパケットの主な項目
| 項目 | 大きさ | 意味 | ntp.nict.jp の応答の例 |
|---|---|---|---|
| LI・VN・Mode | 2・3・3ビット | うるう秒の予告、版、モード | 0・4・4(予告なし、v4、サーバー) |
| Stratum | 8ビット | 階層。0 は Kiss-o’-Death、16 は非同期 | 1 |
| Poll・Precision | 各8ビット | 問い合わせ間隔、時計の精度(2のべき乗の秒) | Precision −20(約1μs) |
| Root Delay・Root Dispersion | 各32ビット | 基準時計までの往復遅延、累積誤差の見積もり | 0・0(基準時計に直結) |
| Reference ID | 32ビット | stratum 1 は時刻源の名前、2以上は上位の IPv4 アドレス(IPv6 はハッシュ) | NICT |
| Reference Timestamp | 64ビット | 最後に時計を合わせた時刻 | — |
| Origin・Receive・Transmit | 各64ビット | T1・T2・T3 | T2−T1 ≒ 2.7ms、T3−T2 ≒ 0.001ms |
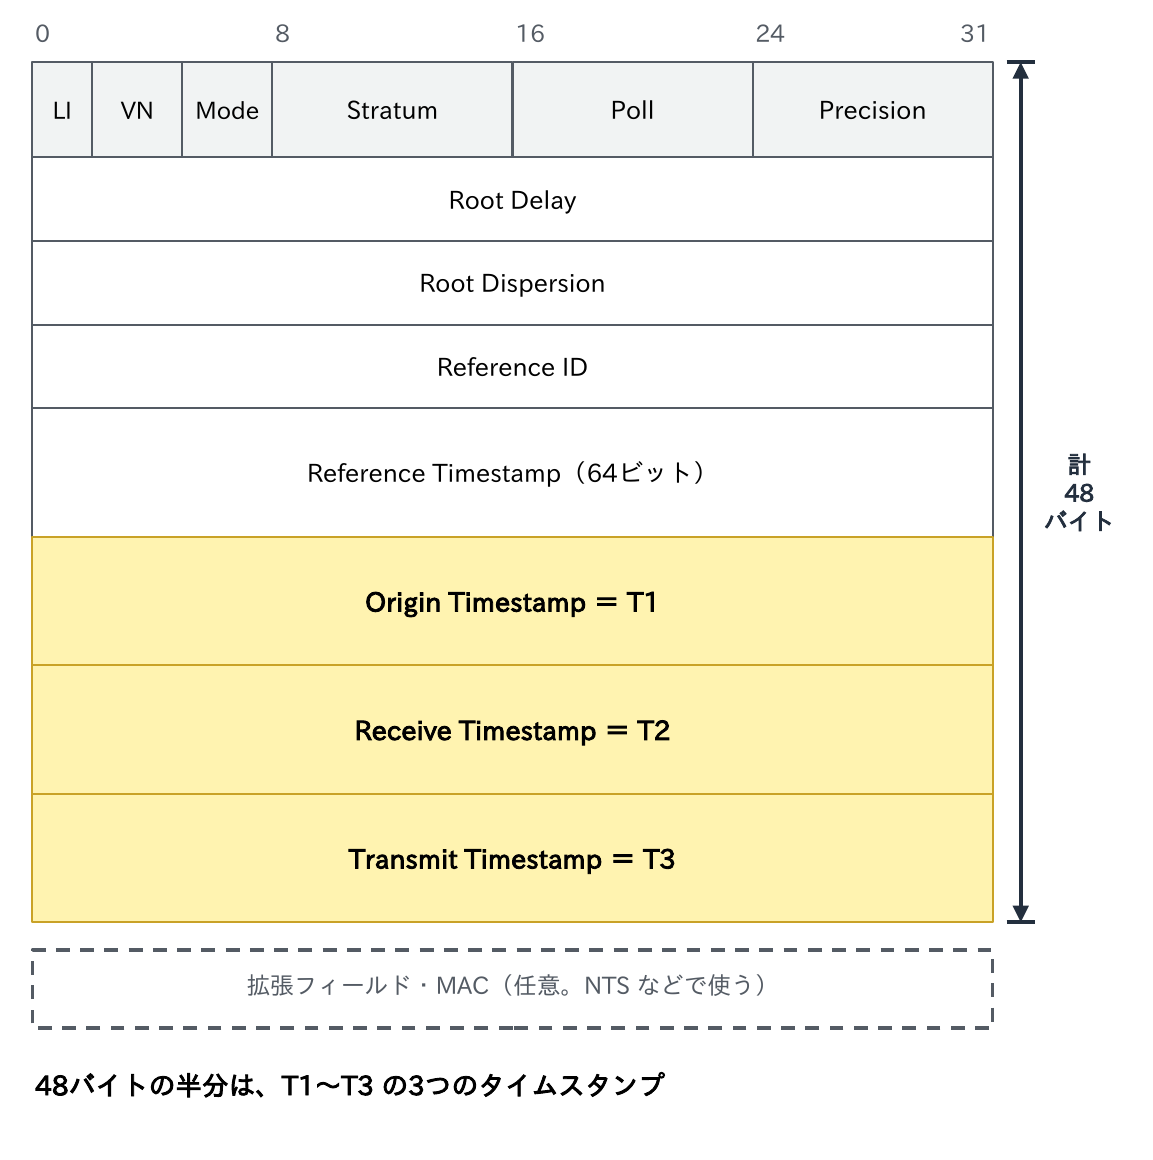
- ヘッダーは48バイトで、後ろに拡張フィールド(NTSなど)やMACを付けられる。T4はパケットに入らず、受信時に記録する
- 例は、2026年9月26日にntp.nict.jpへ問い合わせた値(offset −0.7ms、delay 6.9ms)
- 中身は
chronyc ntpdata(root)やw32tm /query /status /verboseで見られる
poolとiburst
サーバーの書き方は2つあります。
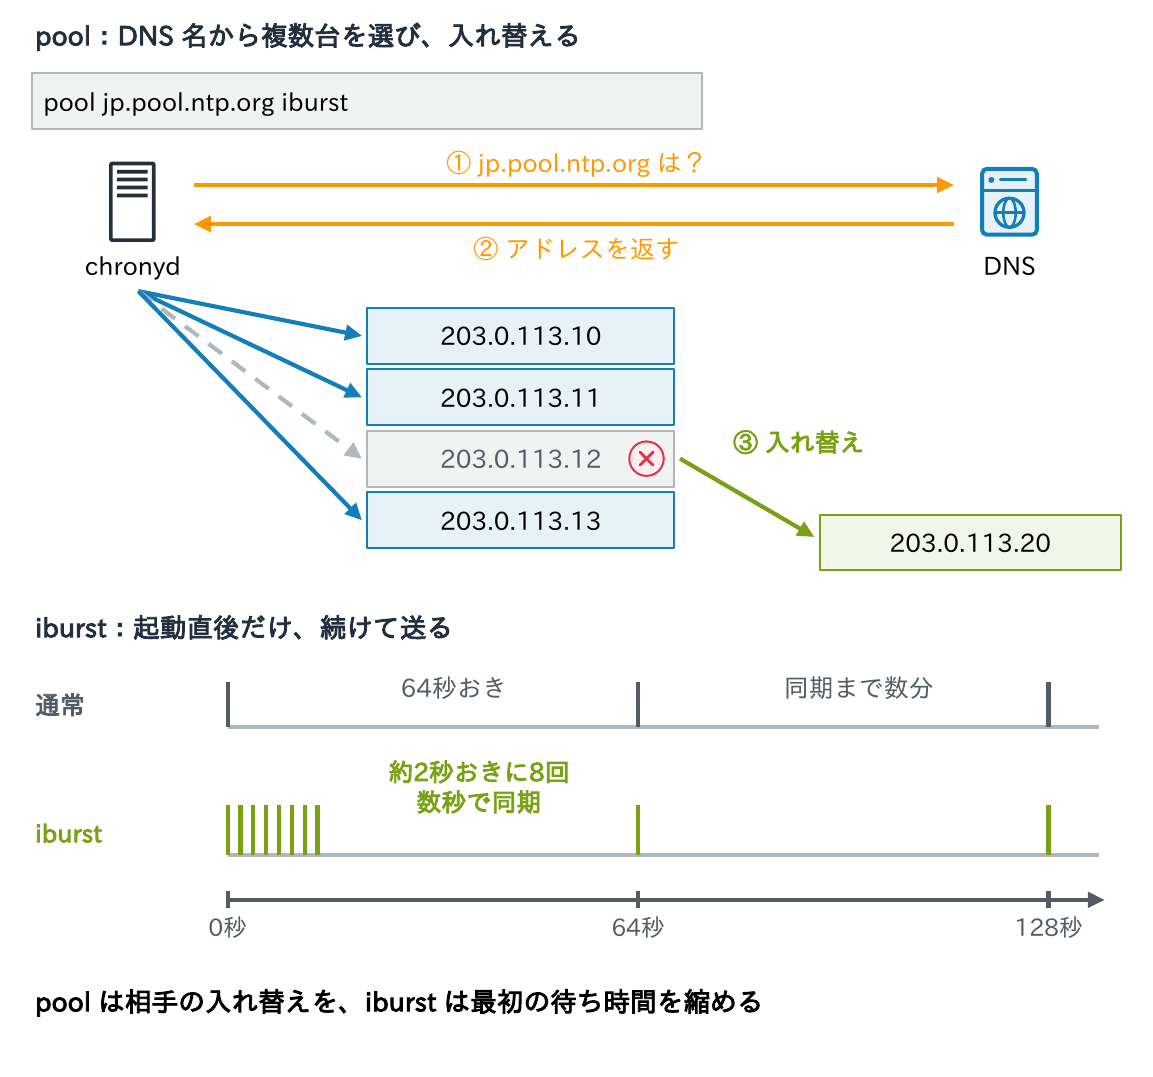
- serverは決まった1台を指定し、poolはDNS名から得た複数のアドレスのうち複数台(chronyの既定は最大4台)を使い、応答しなくなったサーバーを別のアドレスに入れ替える
- NTP Pool Projectは、0〜3の番号付きの名前と、jp.pool.ntp.orgのような国別の名前を提供し、返すアドレスは1時間ごとに変わる(IPv6は2の付く名前だけ)。ただし運営はボランティアに支えられており、業務に重要な時刻を直接インターネットから取ることは勧められていない(第7回)
- iburstは、起動直後や到達できなかったサーバーに、通常の1回の代わりに4〜8回を約2秒間隔で送る指定で、最初の同期を数分から数秒に縮める。常に続けて送るburstと違い、相手の負荷が増えるのは起動時だけ
考えてみよう
- T1=10:00:00.000、T2=10:00:00.130、T3=10:00:00.131、T4=10:00:00.041のとき、offsetとdelayはいくつですか。クライアントの時計は進んでいますか、遅れていますか。
- 社内のサーバーが参照しているNTPサーバーは何台ですか。2台なら、1台が誤った時刻を返したとき何が起きるでしょうか。
- 稼働中のデータベースサーバーの時計が5分ずれていました。slewで直すと、500ppmでは何日、83,333ppmでは何分かかりますか。stepで直すなら、何に気をつけますか。
ヒント:この記事のoffsetとdelayの式、台数の表、slewの速さ(500ppm=1秒あたり0.5ms)が手がかりです。1問目の答えはoffset+110ms、delay 40msです。
まとめ
- NTPはUDP 123でUTCを配る。階層で配り、往復時間を引き、多数決で選んでゆっくり直す
- stratumは段数。16は「非同期」で、そこからは受け取れない
- offset=((T2−T1)+(T3−T4))÷2、delay=(T4−T1)−(T3−T2)。誤差は最大でもdelayの半分
- 時刻源は多数決で選ぶ。2台では決められず、4台以上が推奨
- 直し方はslew(徐々に)とstep(一気に)。起動直後だけstep、稼働中はslew
- poolは複数台を入れ替え、iburstは起動時の同期を速める
次回は、Linuxのchronyの設定と、chronyc tracking・sourcesの読み方、仮想マシンの時刻を扱います。
連載「NTP入門」全11回
- なぜ時刻同期が必要か
- 時刻の基礎知識
- NTPの仕組み(この記事)
- Linuxの時刻同期(chrony)
- Windowsの時刻同期
- ネットワーク機器・仮想基盤
- 設計と推奨構成
- NTPのセキュリティ
- PTPと高精度同期
- 時刻同期のトラブルシュート
- 時刻同期の設計演習
コメント